


谁是计算机科学界的迈克尔·乔丹?
2016年4月,《Science》杂志登了一篇报道,标题是个问句:谁是计算机科学界的迈克尔·乔丹? 答案就叫迈克尔·乔丹。 不是芝加哥公牛的23号,是加州大学伯克利分校的教授Michael I. Jordan,中间那个I是Irwin。 那篇报道讲的是一个新工具。微软联合创始人保罗·艾伦出资创办的艾伦人工智能研究所,做了个学术搜索引擎Semantic Scholar,不光数论文被引了多少次,还用机器学习去判断一篇论文到底直接影响了哪些后来的论文。按这个办法给全世界的计算机科学家排座次,排第一的是他。研究所负责人Oren Etzioni在报道里说:大家都叫他"机器学习界的迈克尔·乔丹"。 他是美国国家科学院、美国国家工程院、美国艺术与科学院三家的院士,也是英国皇家学会外籍会员。2022年首届世界顶尖科学家协会奖揭晓,"智能科学或数学奖"奖金1000万元人民币,由他一人独得,在上海颁奖。2025年11月,他当选中国科学院外籍院士。 他已经70岁,从伯克利荣休,全职在巴黎做研究。 他研究了一辈子的东西,叫机器学习。
▲Michael I. Jordan(图源:本人伯克利主页) 机器学习:不教规则,给例子 机器学习,就是不把规则一条条写给电脑,而是给它看大量例子,让它自己总结出规律。 拿认字举例:孩子作业本上写的一个"8",怎么让电脑认出来? 老办法是程序员写规则:上下两个圈连在一起,就是8。可每个人写的8都不一样,有的歪着,有的上面那个圈没封口,有的两个圈没挨上,规则怎么补都补不完。 机器学习的办法是,把几万个不同的人手写的数字交给电脑,每个都标好"这是几",让它自己去找:8和3、和0、和6,到底差在哪。新写的字进来,它算出一个数:这个字有多大把握是8。
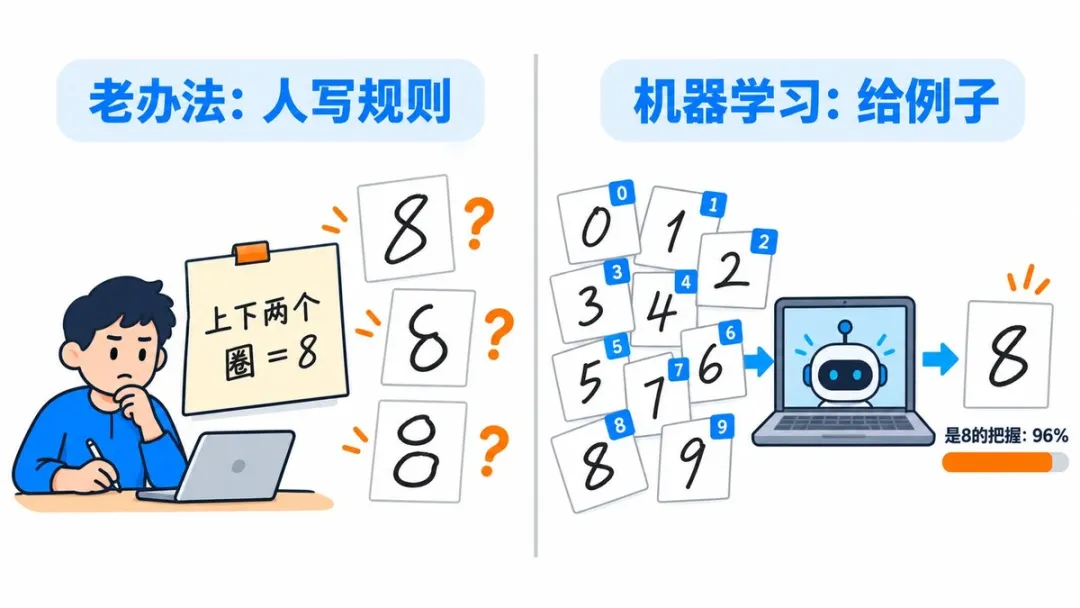
▲写规则和给例子的区别(示意图,AI生成) 电脑给出的不是一个斩钉截铁的答案,是一个把握有多大的数。算把握,正是统计学的老本行。 2015年,乔丹和卡内基梅隆大学的Tom Mitchell一起给《Science》写过一篇综述,给机器学习下的定义是:研究怎么让计算机从经验中自动变好,它站在计算机科学和统计学的交叉点上。2014年有网友问他,统计和机器学习到底有什么区别,他反问:为什么有人觉得这是个有意义的区分? 拍照搜题时手机认出孩子写的字,刷短视频时下一条推什么,手机相册怎么把同一个人的照片归到一起,ChatGPT和DeepSeek怎么一个字一个字往外写回答,背后都是机器学习。乔丹2018年写过一篇长文《人工智能:革命尚未到来》,里面说,今天大家嘴里的"AI",大部分就是过去几十年一直叫"机器学习"的那些东西。 2025年1月,西班牙BBVA基金会把"知识前沿奖"信息通信技术类颁给他(和指纹识别专家Anil Jain共享),评语里说,他的工作给ChatGPT这样的生成式AI、亚马逊那样的推荐系统打下了数学基础。 孩子要是在准备NOAI,这些正是考点。NOAI初赛的学术大纲里,"机器学习"单列一大块:回归、分类、聚类,概率和统计基础,都在里面。聚类里有个常用算法叫NJW谱聚类,三个字母是三位作者的姓:N是吴恩达(Andrew Ng),J就是乔丹,W是Yair Weiss。 本科读的是心理学 乔丹1956年出生在美国马里兰州,小时候跟着父母在路易斯安那和堪萨斯两地之间搬来搬去。 他在路易斯安那州立大学读本科。第一次走进学校的大图书馆,满屋子都是他一无所知的书,他当场下了决心:要把这座图书馆里相当大一部分的东西学会。后来他读罗素、读哥德尔,迷上了"人是怎么思考的"这个问题,本科选了心理学。 1978年本科毕业,他想当"数学心理学家",去亚利桑那州立大学读了数学硕士,方向是统计。有一次从亚利桑那去圣地亚哥度假,他顺路进了加州大学圣地亚哥分校,跟几位老师聊完,发现了一个刚冒出来的领域:认知科学,用数学和科学去研究人怎么思考。他说,当时就是"啊哈"的那种感觉。 1985年,29岁的他在那里拿到认知科学博士,导师是David Rumelhart。1986年,Rumelhart和Hinton等人发表了反向传播的论文,今天训练神经网络,用的还是这套方法。 同在1986年,乔丹提出了一种能处理前后相连数据的网络,后来就叫"Jordan网络",是最早的循环神经网络之一。Transformer出现之前,处理一句话、一段语音这类前后相连的数据,主力就是循环神经网络。 1988年他去MIT脑与认知科学系当助理教授,一路升到正教授。1998年,伯克利的统计学家Peter Bickel请他同时加入统计系和计算机系,他去了,一待就是26年。 混合专家:DeepSeek论文里写明的源头 大模型有个难处:参数越多,能力往往越强,可要是每写一个字都把几千亿个参数全算一遍,又慢又费电。 DeepSeek用的办法叫"混合专家"(Mixture of Experts,MoE)。好比去医院看病,分诊台先看一眼你的情况,只把你派给最对口的那几位专家,其他专家这一轮不用动。DeepSeek-V3和R1一共有6710亿个参数,每处理一个词,只调动其中370亿,不到6%。
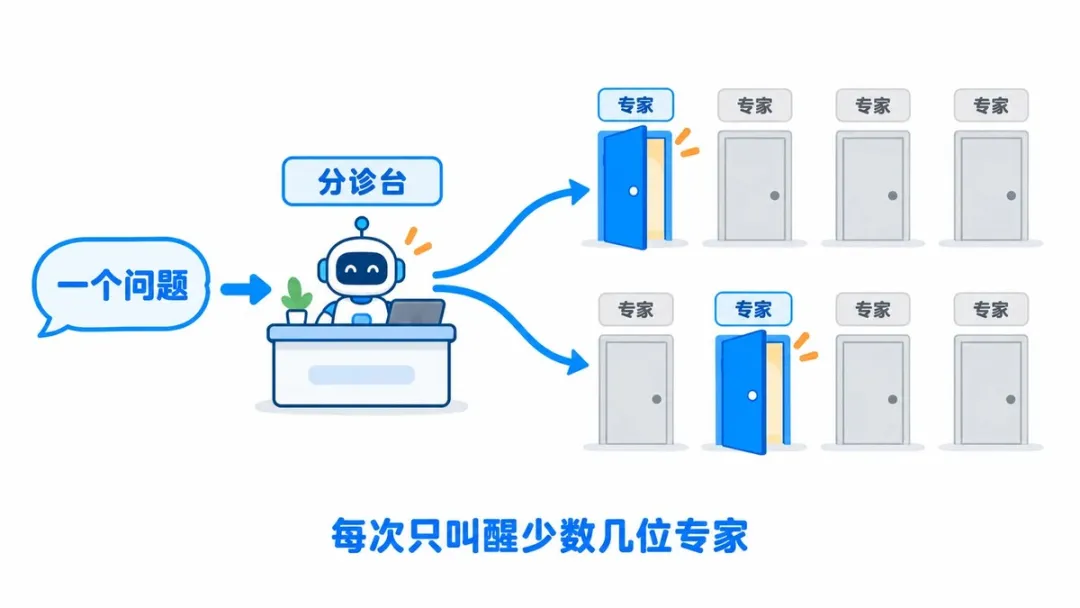
▲混合专家:分诊台只把问题派给少数几位专家(示意图,AI生成) 2024年1月,DeepSeek团队专门写了一篇讲混合专家的论文,末位作者是梁文锋。论文回顾这项技术的来历时写道:混合专家技术,最早由Jacobs等人(1991)、Jordan和Jacobs(1994)提出。 DeepSeek这次融资,梁文锋拿得出200亿,他为什么还要上班? Jordan,就是乔丹。 1991年那篇发在神经网络期刊《Neural Computation》上,四位作者里,第一作者Robert Jacobs是乔丹带的学生,第二作者是乔丹,第四作者是Geoffrey Hinton,后来拿了2018年图灵奖和2024年诺贝尔物理学奖。1994年那篇,乔丹是第一作者。 从1991年到2024年,隔了33年。 今天公开写明用混合专家的大模型,还有月之暗面的Kimi K2(1万亿个参数,每次只用320亿)、阿里的Qwen3、Meta的Llama 4、谷歌的Gemini 1.5 Pro,以及OpenAI在2025年开源的gpt-oss。谷歌给Gemini 1.5写的技术报告里,引的也是1991年那篇。 他带出来的人:吴恩达、Bengio,还有一位IOI金牌 吴恩达是乔丹在伯克利带的博士生。毕业后,他在谷歌创立了Google Brain项目,和Daphne Koller一起创办了在线课程平台Coursera,2014年到2017年当过百度首席科学家。 吴恩达读博时,和同门David Blei、导师乔丹一起写过一篇论文,2003年发表,讲一个叫LDA的方法:给它一大堆文章,它自己找出这些文章在聊哪几类话题,再算出每篇文章里各个话题各占几成,全程不用人先打标签。这篇论文被引用超过3万次(OpenAlex数据),《纽约时报》2015年给网站做"为你推荐"栏目时就用上了它。Blei后来在博士论文的致谢里写,这条研究线,是吴恩达某天下午在一个信封上画出一张图开始的。 Yoshua Bengio和乔丹是另一种关系。1991年Bengio刚拿到博士学位,到MIT跟着乔丹做博士后。2018年,Bengio和Hinton、LeCun一起拿了图灵奖。那一年的三位得主里,一位在他手下做过博士后,一位和他合写过混合专家的论文。 再往下数,名字一个比一个响。Zoubin Ghahramani在MIT跟他读的博士,后来当了剑桥大学教授,现在是Google DeepMind研究副总裁。邢波在伯克利读博时,导师之一是乔丹,他现在是阿联酋穆罕默德·本·扎耶德人工智能大学(MBZUAI)的校长。Percy Liang在伯克利读博,导师是乔丹和Dan Klein,后来创办了斯坦福基础模型研究中心。北京大学的张志华、清华大学的龙明盛、香港中文大学的徐雷,都在他主页"过往博士生和博后"的名单上。 还有两个和OpenAI沾边的名字。 他的博士生Robert Nishihara和Philipp Moritz在伯克利做出了一个叫Ray的工具,能把一个大计算任务拆给一大群电脑一起算。2018年Ray的论文,作者里也有乔丹。2019年他们成立公司Anyscale,官方新闻稿把乔丹列为创始人之一。OpenAI联合创始人Greg Brockman在Anyscale的大会上说过,OpenAI用Ray训练自家最大的模型,Anyscale网站上他署名的推荐语写得更直接:包括ChatGPT。 另一位是Alexander Wei。2015年,他代表美国队在IOI(国际信息学奥赛,信奥的最高赛场)拿了金牌,全球第18名。后来他在伯克利读博,导师之一就是乔丹,2023年毕业去了OpenAI。2025年7月19日,正是他在网上宣布:OpenAI的一个实验模型做2025年国际数学奥赛(IMO)的题,拿到42分里的35分,达到金牌线。 乔丹主页上列着163位过往博士生和博后,头衔里带"教授"的有九十多位,斯坦福、MIT、卡内基梅隆、普林斯顿都有。 2016年《Science》那篇报道里,乔丹回应排名时说,科学史上总爱围着个别人造神话,可他相信,最能预测一个研究者有多大成就的,是他身处的那张人际网络: 我自己的网络里,全是有好点子的厉害人。 打鼓、学语言、每本书读三遍 乔丹会好几样乐器,主攻架子鼓。打鼓里有个让他着迷的问题:手脚常要同时落下,可脚离大脑比手远,大脑得先给脚发信号、再给手发信号。人自己根本不用想,大脑就把这个时间差算好了。他读博时研究的,正是人怎么控制、怎么学会肢体动作。 2014年一家科技媒体在标题里称他"大师",他在博客里回应:通常没人管鼓手叫大师,所以这点夸张他就不抱怨了。 他的母语是英语,西班牙语、法语、意大利语,都是自己读小说、查词典学会的。 2014年他在Reddit上回答网友提问。有人问他一天怎么安排,他说:每天一半时间在减少熵,一半时间在增加熵。熵是统计里衡量混乱程度的量。减少熵,可以理解成把事情理出头绪;增加熵,是去打开新的可能。他还补了一句:这个比例调得准不准,决定他开不开心。 清华大学的龙明盛在伯克利跟他做研究时,写了第一篇论文。实验室去圣克鲁兹海边开两天务虚会,乔丹就在论文的源文件上一处一处地改,大到基本概念,小到遣词造句,改了上千处。 2022年,当时在宾夕法尼亚大学任教的苏炜杰对澎湃新闻说,66岁的乔丹还保持着睡前读其他学科专著的习惯,那几年读得最多的是经济学。 同一场Reddit问答里,有人问起他给学生开的书单。他说这份书单是给伯克利刚入学的博士生的,每本最好读三遍:第一遍几乎看不懂,第二遍开始明白,第三遍觉得全都是明摆着的事。 他不信"AI会毁灭人类" 乔丹做了一辈子机器学习,却一直在给"AI"这个词泼冷水。 2021年他对IEEE Spectrum说,很多人以为计算机里有某种会思考的智能,在推动进步、在和人类竞争:"我们没有那种东西,但人们说起话来好像我们有。"2025年拿BBVA奖时他说:"我想让人变得更强,而不是让AI来告诉人该做什么。" 2026年10月4日,法国《解放报》登出对他的长篇采访。记者问:Hinton和Bengio也在警告超级智能的风险,你怎么看?他说Bengio不太一样,人家在实打实地做安全方面的工作;而Hinton从没创办过一家为真实的人提供真实服务的公司。Hinton的推理是:我们已经弄懂了大脑怎么工作,能把它复制到硅片上,复制任意多份,再把各份学到的东西合起来,就会指数增长,变成超级智能。乔丹说,这个推理的每一步都站不住,"我们这是到了科幻的地盘"。 他在这篇采访英文版的前言里,记下了一句他在类似讨论里听年轻人说过的话: 我不打算要孩子,因为人类灭绝的风险太高了。 他说,那些觉得权威人物大谈"人类灭绝风险"无伤大雅的人,应该想想这句话。 采访里他还说,任何做过教育的人都知道,大多数时候孩子不喜欢坐在电脑前,他们想要一个有血有肉的老师。 B超上的几个白点 还是2018年那篇《人工智能:革命尚未到来》,第二年登上了《哈佛数据科学评论》的创刊号。乔丹在文章里说,机器学习系统正在替全世界的人做判断、做决定,可造这种系统需要的原理,他在自己受过的所有教育里都没找到。 这篇文章开头讲的,是他自己家的事。 那是写这篇文章的14年前,他妻子怀孕,去做B超。诊室里的遗传学家指着胎儿心脏周围的几个白点说:这是唐氏综合征的标记,你们的风险升到了二十分之一。要确认,可以做羊水穿刺;可穿刺本身,大约有三百分之一的概率会让胎儿保不住。 乔丹是统计学家。他决定先弄清楚,这些数字是从哪来的。 数字出自大约十年前英国的一项研究,那项研究确认了这些白点能预示唐氏综合征。可他注意到,自家医院这台新机器,比那项研究用的设备每平方英寸多出几百个像素。旧机器拍不出来的白点,新机器拍得出来。这些白点,很可能只是噪声。 他把这个发现告诉遗传学家。对方说:难怪唐氏综合征的诊断,是从新机器到货那时起变多的。