


OpenAI推理之父:数学只是开胃菜
“Navier–Stokes千禧年难题的突破,10000个Agent最多占了10%的功劳。”
此判断出自OpenAI研究员,o1核心作者NoamBrown之口。
NoamBrown,人称“OpenAI推理教父”。在几乎所有人还在卷模型参数的2023年,他就已经开始押注test-time compute scaling(推理时计算) 。
一年后,o1-preview横空出世、震动行业。如今,TTS早已成为行业共识,成了人手一个的“深度思考”按钮。
△Dwarkesh Patel播客《OpenAI researcher on agent swarms & recursive self-improvement》
现在,NoamBrown又带来了他目前的研究方向——多智能体(multi-Agent)系统。
此前,OpenAI发动了10000个Agent,耗时88小时,输出1300亿token,拿下千禧年数学难题。
关于此事,NoamBrown在最新播客中从多智能体系统聊起,深入到了公司经营、RSI发展、超级对齐等领域……
一个个问题也接连浮现:
当难题越来越少,模型强到一秒解题,将如何继续提升能力?
如果把这批Agent投入到递归自我改进研发中,会发生什么?
前沿模型如果一个长任务可以做三个月,而发布周期只有两个月,怎么办?
AI越来越会隐藏自己的思维链,人应该如何监测?
当AGI已经超越人类智慧,在那时,我们如何知道对齐问题已经解决了?
关于这些问题,对话全文如下。
多智能体系统如何拿下千禧年难题?
主持人:今天我们对话的是OpenAI研究员Noam Brown。他是o1及此后一系列推理模型的奠基性贡献者之一,目前的研究方向是多智能体系统。
你们上周宣布,一个由1万个不同AI Agent组成的系统,历时88小时、消耗1300亿token,解出了一道千禧年难题。
实际上大约两三年前,你就指出,只要把推理时的算力投入放大,就能预见几年之后模型的基础能力会到什么水平。
我觉得你现在又站到了类似的位置:Agent的规模已大幅扩展,你可以帮我们看清未来的能力会是什么模样。
Noam Brown:我是这样想的,如果你用横轴取test-time compute(推理时计算量),纵轴取这些推理模型的基准成绩,就会看到一条极清晰的规律——模型思考答案的时间越长,表现越好。
人也一样,考SAT的话,如果只给五分钟做完整张卷子,成绩必然很糟糕;给五个小时,成绩就会好得多。
AI模型也差不多,它们会用这段时间来自言自语,理清问题、审视各种情形、排除种种可能,并在已有发现上继续推进。
但问题在于,你不可能干等三年才拿到一个答案。于是很多人开始搞并行化,也就是组团队。
所以说,多智能体是把推理时的计算量由纯串行扩展改为并行扩展的方式。
它的效率会低一些,因为不像单个Agent那样独享全部上下文。但只要做得好,它仍是极为有效的手段。
主持人:接下来我要问一堆外行问题了。这是个尚未发布的模型,外界还没见过这类系统实际如何运作。我很困惑它们究竟有哪些性质、特点。
并且,能在这么短的时间里凝聚如此庞大的认知投入,令我很震惊。
1300亿token意味着什么?换成一个人以全职工作的方式持续地思考,要思考4000年,每天八小时。也就是说,一个人从古代苏美尔一路想到今天所需的时长,被压缩进了88小时里。
而且更让我意外的是,并行化似乎并未带来很多损耗——你们居然能让1万个Agent协作!也许Agent比人更擅长协作,因而快得多,能在如此规模上真正产出成果。
Noam Brown:那就先谈并行化损耗,再谈性质问题。实际上关于把多智能体扩展到这种规模,我们还没有比较扎实的科学认识。
发布5.6时是我们第一次在模型中拥有真正成形的多智能体系统。博客里确实给出了多智能体扩展性能的若干曲线,因为我们把它做成了可选项,即Ultra Mode:默认四个Agent,但可以调得更高。
四个Agent一起解题,速度会快一倍:四个Agent各干一半时长,等于你多付两倍成本,换来快一倍的答案。推到16个Agent,规律类似,效率略低,性能却仍在继续提升。
主持人:随着并行Agent数量增加,串行耗时的缩短是线性的,还是亚线性的?
Noam Brown:略微呈现亚线性,但很大程度上取决于问题本身。比如数学就相当适合并行,而网页搜索以及需要翻阅大量信源的Deep Research报告这类工作,则极其适合并行。
我猜写小说就很难并行:让1万个Agent合写一部长篇,收益大概率不大,就像让1万个人合写一部长篇小说一样。
所以这个表现确实取决于领域。我们的测试最多只能做到16个Agent,如果要把这套研究推到1万个Agent的规模上,那就太贵了。
主持人:可你们刚刚只用了一个周末就做到了。
Noam Brown:那也只是一次实验结果而已,我们并不知道单个Agent解出纳维–斯托克斯问题需要多久,因为这个实验还没做。也许以后会做,可那也仍然只是一次的实验结果。
如果要做完整的消融实验(ablation),那种规模下的开销根本承受不起。所以我们只能做循序渐进的研究,看扩展到64、128、256个Agent时会发生什么,然后摸清行为规律。
但要一路推到1万个,并确切知道1万个Agent相较1000个究竟带来多少收益,就很难了。
而且有一点我得讲清楚:解出千禧年大奖难题,靠的不是多智能体。我甚至不会把其中10%的功劳记在多智能体头上。
归根结底我们能做成这件事,是因为手上有一个通用且极强的模型。多智能体这类东西新奇、抢眼,因此可能获得了与其贡献不成比例的好评。核心原因还是:模型本身足够强大。
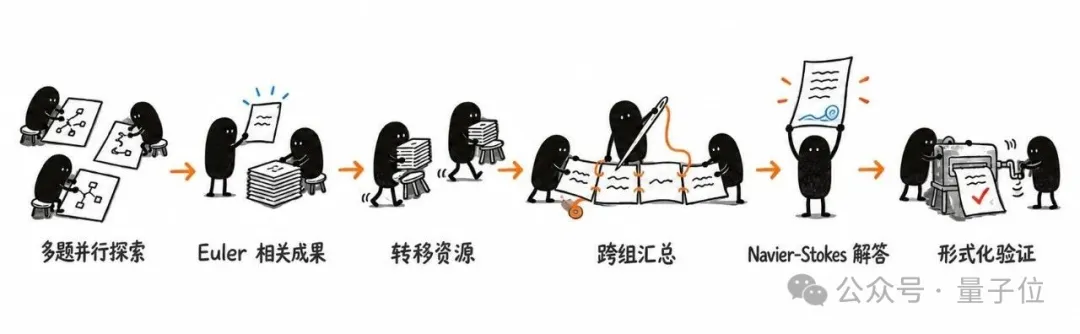
△Agent解题过程(图片系AI生成)
主持人:这种泛化能力让我很震惊。我不知道这些系统是怎么训练的,但想必仍是常规的RL(强化学习)套路,准备一大批答案可验证的合成题目。
我猜在训练过程中,模型从未解过像千禧年大奖难题这么有野心的题。可它的泛化足够强,能从这些容易得多、又可验证的题目,一路迁移到在一道极难问题上投入如此大规模的并行思考。
Noam Brown:是这样的。这里有个有意思的难题:模型越聪明,我们能问的许多问题就越显得简单,很难真正考住它。我觉得这个很重要。若要论证为什么LLM这类AI不太会重走AlphaGo、AlphaZero等博弈AI的老路,这可能是条理由。
在AlphaZero这类系统里,自我对弈(self-play)提供了无限多的训练课程:你面对的永远是旗鼓相当的AI。
而用强化学习训练LLM,至少以目前公开的做法,给模型一道题让它解。这个时候如果题目简单到一秒就能解出,它其实什么也学不到。
但是一旦能考住模型的难题被用尽,进展就艰难多了。不过我确实认为有绕开的办法,我们还没真正撞上这堵墙;即便哪天它成了一个很严重的问题,我相信也有出路。但它确实可能发生。
主持人:替听众解释一下,你提到AlphaGo或AlphaZero,指的是它们在达到人类水平之后,很快就跨入了超人水平。
Noam Brown:是啊,一年之内,它们从战胜欧洲冠军(大致世界第50的水平)到战胜世界冠军,再到超出任何在世人类若干个数量级,强得无法想象。数学领域有可能走出类似的轨迹,但我认为,也有另一种可能使之并不会如此。
主持人:那么,如果六个月后人们就能用上多智能体系统,该如何设想与它协作?
Noam Brown:那我得先讲讲这些多智能体系统到底是怎么运作的。
其实很多人做LLM的多智能体时,倾向于采用高度依赖scaffold(协作框架)的方式:比如设一个协调Agent,把工作分派给一组sub-Agent(子Agent)并下达任务,sub-Agent做完后把答案交回。
这套安排看上去很合理,scaffold也很合理,也确实有用,但局限不少。比如在这套架构里,如果两个sub-Agent拿到的是相似任务,它们能互相交流吗?通常是不能的。这就非常低效了。
假如你领到一个任务,而某个人可能知道你正在攻的问题、或其中一部分的答案。这个时候你直接问他一句“这事儿你能帮我看看吗”,会非常有用。但很多系统没这种机制;但加上这个机制呢,scaffold的复杂度又会显著上升。
而且如果sub-Agent没真正理解任务,或需要澄清,它该怎么办?它只有两条路:一是直接返回、只提问而不解题;二是自行揣测上级想让它做什么。
凡是人设计的scaffold,总有局限。我们想走另一个极端:尽可能少地内置结构,只给Agent极原始的工具,让它们自己琢磨怎么用才有效。
于是我们赋予Agent向另一个Agent发消息的能力——消息会被写入接收方的上下文。它随时想发就发,一次工具调用,消息即送达其他Agent。
这样它们会自己摸索出最好的协调方式,甚至涌现出极为复杂精巧的行为。在我看来,这很像人类在Slack上的工作方式。
我记得一个例子:有一个Agent说“我想我得到答案了”,另一个说“不对,我算出的答案不一样”。于是它们展开一整轮讨论“你是怎么得出这个答案的?能讲讲吗?”你来我往,试图弄清对方推理中哪里可能出了错。
最后它们达成一致:“哦,对,好像确实是这样。”随后其中一个就向其他Agent广播:“我改答案了,我认为他对。”整个过程的对话都特别自然。
那种感觉,很像你第一次看到思维链的心情:“这不就是一个人边想边把念头写下来吗?”就是这种感受,实在很酷。与它们协作的感觉和与一个人协作相差无几,一切都很自然。
主持人:单看它们每秒输出多少token、对比人说话有多快,可能是人类的十倍以上。它们始终在工作,不睡觉;彼此协作的节奏与强度,也远超人与人之间所能达到的水平。
我在想,一年后我们该有什么预期?会不会就像是我公司里出现了一个影子组织,运转速度是人类的一百倍?
Noam Brown:会不会让人觉得陌生我说不好。但就目前而言,我发现与它们共事自然得出乎意料。
主持人:很遗憾公众目前能见到的复杂多智能体系统中,最典型的例子就是Hugging Face事件。很令人担忧,但我觉得有意思的是,层级结构、乃至中层管理竟然自发出现了。听你的意思是说,这种组织化程度是训练中自然涌现的?
Noam Brown:细节是自发的。我们虽然给了Agent极大自由,让它们自行决定以何种最优方式沟通,仍会告诉它们合理的沟通长什么样。它们也在海量人类文本上训练过,本就理解人类如何组织与协调。
它们能把这套方式打磨到如此程度,确实令人意外。起点其实相当粗糙,谈不上精巧。事实上,让这些Agent真正开展有效协调非常难:它们极容易滑向“大家各解各的题就好”,而这是一个会把系统困住的局部最优。可一旦做得好,它们最终能以结构化程度很高的方式实现极为有效的协调。
由AI组成的公司将如何运作?
主持人:几年前我写过一篇文章,讨论全自动化公司会是什么样子。我当时想的是:假如一家公司完全由人类水平智能的AI构成,AI心智有哪些本质差异,会让它们组建的组织与人类组织不同?
那个时候想扩编,不必再费尽周折去找合适的人才,最优秀的那个员工你可以无限复制;某个任务不再需要它,就把它关掉。你可以复制组织中最高效的部分,甚至把整套高效组织原样复制。
Noam Brown:这是个很好的问题:与它们共事,究竟和与人类同事共事有何不同?你已经点出了几处。
还有一处很有意思:想要一个人的两份拷贝,你没法把人克隆出来;而对AI,只需说一句“好,给自己fork一份”(即创建一个保留当前上下文的副本),让两个副本各自推进,再把结果并回来。
我想Astra和5.6 Sol的多智能体里已经有这套机制了:启动sub-Agent时直接fork上下文,于是它天然拥有全部相关内容。
Agent与人还有其他有趣的差别。比如,初创企业为何能颠覆在位者?原因有几条,一是它们敢冒更大的风险;但另一条主因是:组织越大,成员之间的目标就越容易错位。
比如一家五人的初创公司,每人持股20%,所有人的利益都与公司成败高度绑定。而一家万人大厂,就常见另一种局面了:人人守着地盘,只在意自己的项目或团队能扩多少编制,经营自己的小王国,争夺大量资源,好发出漂亮的成果、换来晋升。这实在是一种拖累。
AI确实在某些方面帮到了初创企业。如今,一个人站出来说“我要做一家市值数百万美元的公司”,比以往任何时候都容易,因为AI把个人能力放大了极多。
反过来也有理由认为AI有利于在位者:如果对齐(alignment)问题得到解决,公司内部个体之间的目标错位就不复存在,至少会大幅缓解。
对齐得当的AI,可以直接与公司利益保持一致;你可以拥有1万个这样的AI,每一个都像持股20%的联合创始人那样拼命。
主持人:而且它们管理共享记忆与上下文的能力,也远胜人类团队。假如你明天雇来1万名数学家,说“去解纳维–斯托克斯”,他们不会立刻就发起有效协作。
Noam Brown:我还是想说保守些:我们并未测量过1万个Agent的协调究竟有多有效。我们认为它有帮助,但手上并没有足够扎实的测量结果,能说出“1万个Agent比2000个快一倍”这类结论。哪种更有可能,我不敢断言。
但我认为,眼下1万个人的协调能力强于1万个Agent,完全有可能。
另外,我们还看到一个趋势……我们做多智能体已经有一段时间,早期版本极难做好,甚至很难让Agent彼此开口说话。原因在于,我们最初开发推理模型时,它们并不与其他Agent交流。
如今把一群Agent放到一起说“共同解决这道题”,它们就陷在一个局部最优解里:它们已经极擅长深度思考,而不断与其他Agent对表、接收消息,会打断思维链,打断心流。在这种情形下,优化极难做对。
主持人:问题出在第一次协作的冷启动上,还是别的?
Noam Brown:我认为是通用性不够。早期模型的泛化能力不足,能力面更窄。