


英伟达 vs 存力,到底谁拿捏谁?
HBM技术演变围绕容量、带宽、成本展开:容量可通过堆高层数或增加内存数量扩大,但受工艺、良率、DRAM晶圆产能制约;带宽上位宽与速率相互掣肘,瓶颈在Base Die、中介层和封装;HBF以牺牲带宽换容量,适合低频数据。最终路线取决于AI需求卡在容量还是带宽,分层混合存储架构或成远期解。
在上篇文章中存力接棒算力,HBM为什么“脱颖而出”?,海豚君从底层技术出发,回答了AI对存力的需求为何"突然"爆发,以及HBM凭什么成为高性能GPU的首选内存,并介绍了HBM内存技术的核心概念与逻辑。那么随着AI技术的发展,内存技术又将如何演变,以实现更大的容量和更快的带宽?
恰巧,近期业内也出现了两个看似矛盾的信号:一边是HBM路线图继续加码,堆叠层数从12层走向16层、20层;另一边据SemiAnalysis,英伟达下一代Rubin Ultra的HBM可能从16层一路砍到8层,同时以闪存颗粒为基础的HBF,也在试图从HBM手中分走一部分容量需求。
HBM是否会被取代,还是会更加稀缺?HBM究竟该不该继续堆高?本篇我们就沿着上篇结尾留下的容量、带宽和成本三条线索,主要讨论以下几个问题:
1)要继续扩大内存容量,行业有哪几条路可走?各自的代价是什么?为什么HBM的层数反而可能不增反减?
2)为什么带宽比容量更难提升?瓶颈卡在哪里,后续又有哪些突破口?
3)不同的场景下,哪条技术路线更可能被选择?对产业链以及内存厂商的话语权会有何影响?
一、扩大容量,有哪些途径?
先从如何继续加大内存容量的问题出发,目前业内有两个并行的方向:一是突破工艺上限,把单颗内存做得更强,代价是更复杂的工艺、更高的成本和可能更低的良率;二是更侧重性价比,不追求单颗性能,转而以数量取胜,用不同规格的产品匹配不同层级的需求。
1.1、路径一:更强的单颗性能
a. 继续堆更多层
最直接的方法是沿着现有路径继续增加堆叠层数:HBM3E为12层,部分HBM4/4E将做到16层,HBM5路线图则指向20层。
但加层并没有说起来那么简单。HBM与XPU共同封装、共用底座和顶盖,因此内存堆的总高度是受限的:HBM3E及之前的规范上限为720um,HBM4放宽到775um。
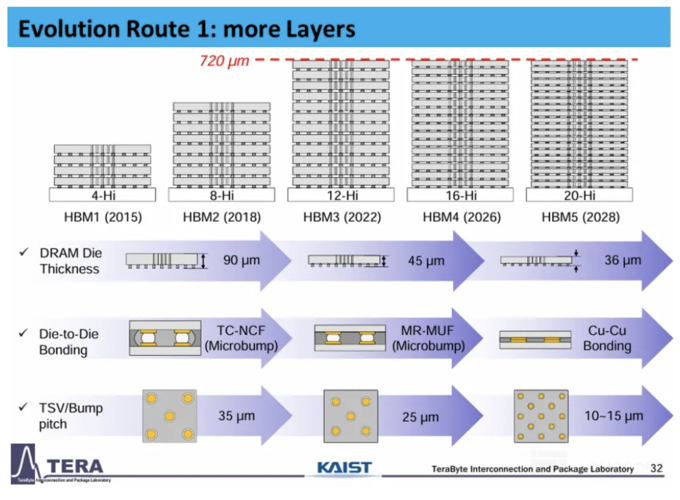
限高之下要塞进更多层,只能:① 把单层DRAM颗粒削薄;② 压缩层间空隙,把微凸点(micro-bump)做小,甚至去掉微凸点,让上下两层的铜触点直接做铜铜键合(Cu-Cu Bonding)。
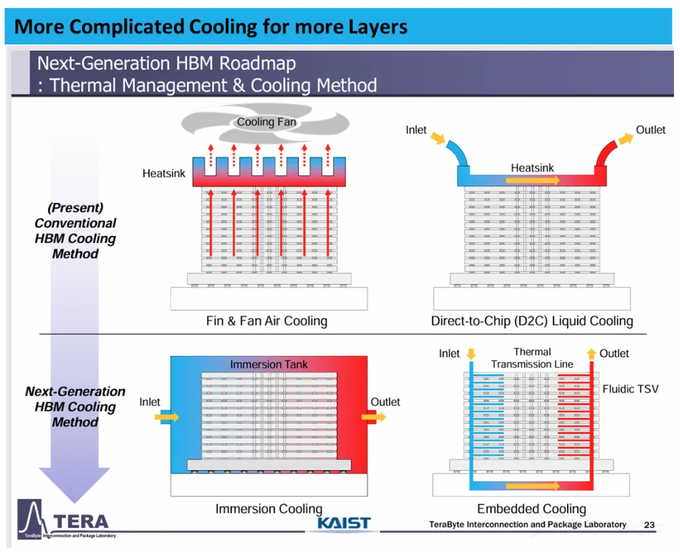
但更精密的工艺意味着更高的成本和更低的良率:① 削薄后的硅片强度下降,更易翘曲或在堆叠中损坏;② 层间空隙缩小,散热和绝缘填充都更难,热压工艺(TC-NCF)已难以胜任,需转向海力士的回流焊(MR-MUF)或混合键合;③ 层数越多,对供电、传输和散热的要求越高,TSV需要做得更密、孔径更窄。
简单来说,这条路径是用更难的工艺和更高的成本换单颗容量,对内存厂的要求更高,好处是新增的容量都能享受首排内存的高带宽。
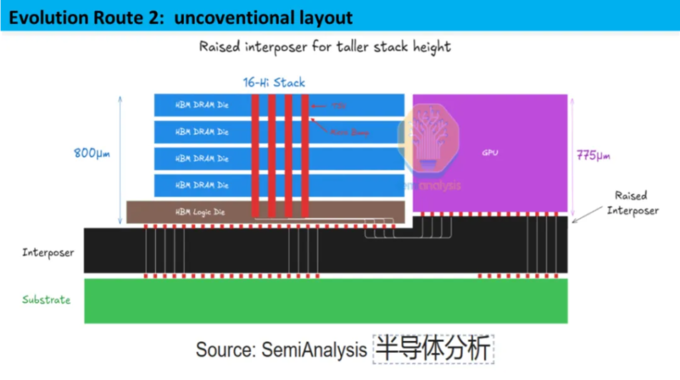
b. 绕过限高的偷懒方法
另一个“走捷径”的办法是变相加高堆叠高度:如下图,把GPU下方的中介层垫高,在两者顶部仍然齐平的前提下,让内存堆可用的高度提升到约800um。
这样可以少削薄甚至不削薄颗粒就多塞几层,省下复杂工艺带来的成本和良率损失。但能挤出的空间有限:从720um到800um,按每层宽度只比45um略有减少,最多只能再多放2层。
1.2、路径二:多放存储,以量取胜
a. 多排内存:前排保速度,后排给容量
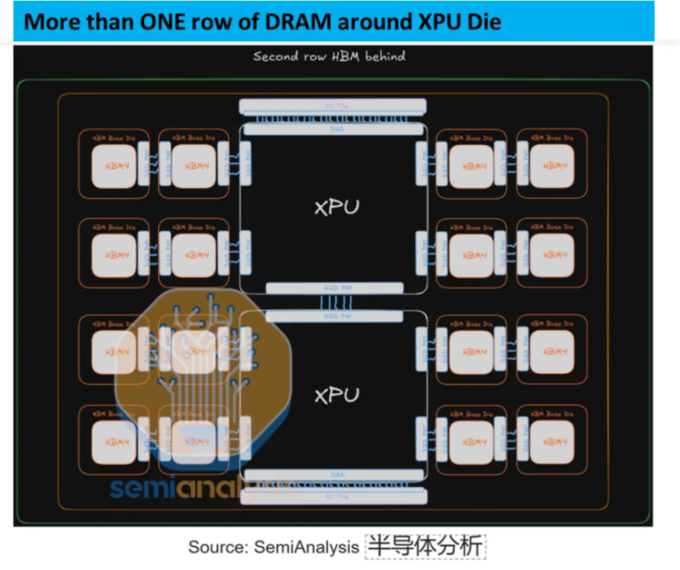
另一条路是增加内存的数量。由于紧贴XPU的位置有限,新增的内存大概率只能放在后排:这省去了加密堆叠的工艺难题,代价是后排内存的带宽势必更低。
这里后排用什么内存、怎么封装都有选择:① 规格上,除了下图中的HBM,也可以用普通DDR,乃至基于NAND的HBF(后文展开),单位容量成本更低;
② 封装上,后排既可以和XPU一起放在硅中介层上(速度快,但贵且中介层面积有限),也可以放到次一级的基板甚至PCB上(速度慢,但便宜、空间充裕)。
③ 但后排不能无限加,带宽是最大的瓶颈:因后排内存的数据需前排内存中转,整个多排内存的最大带宽,受限于首排HBM和XPU间的带宽。如下图的示例,若首排HBM与XPU之间的带宽为4TB/s,在扣除自身需要和XPU通讯占用的2TB/s带宽后,能用于替后排内存中转传输的带宽就只能有2TB/s,若再加第三排内存就依次减少。
b. HBF:更便宜的选择?
前文已提到,为了降低单位存储的价格,行业有考虑用其他规格存储来代替HBM,其中一个重要选项是HBF—即高带宽闪存(High Bandwidth Flash)。正如其名,它的结构基本是HBM的复刻:多层堆叠、TSV贯通连接上下、与XPU共同封装,只是把DRAM颗粒换成了NAND颗粒。
值得一提的是,NAND本身就是3D结构,为什么HBF还要像HBM一样多片堆叠?
原因在于,NAND的“3D”是存储单元层的堆叠,只加容量、不加读出通道:同一串单元共用一套读出电路,每次只能读其中一层。
HBF的额外带宽来自并行:单片die内部划分成大量小阵列同时读出(下图右),再用TSV把16片die堆叠起来同时输出。普通NAND 3D架构虽然也叠容量,却挂在同一条总线上轮流传输(具体情况请见海豚君对NAND的研究)。
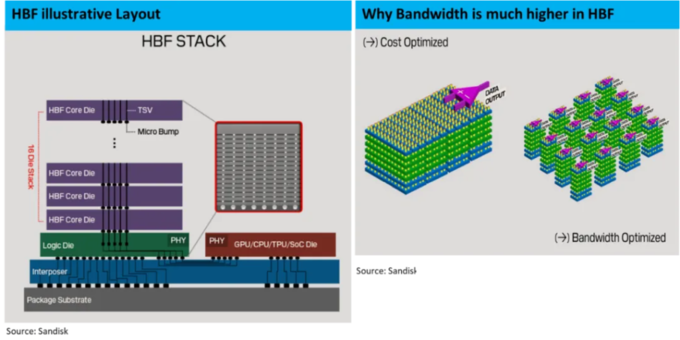
与HBM相比,HBF的优劣势都很鲜明:
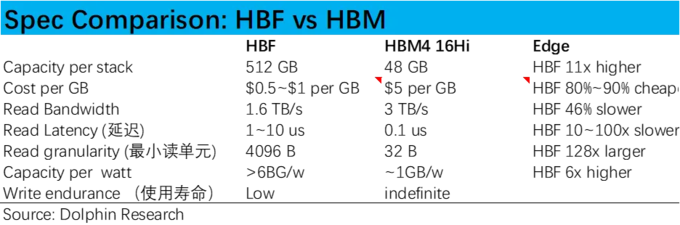
① 优势--容量大、便宜、省电:计划于2026年末至27年初推出的HBF Gen1(16层堆叠),单堆容量可达512GB,而16层HBM4只有48GB;HBF单GB价格据调研可能只有HBM的1/5~1/10左右。且NAND颗粒天生功耗和散热需求相对更低。
② 带宽做到同一量级:凭借类似的堆叠和共同封装工艺,据公司披露HBF Gen1读取带宽可达1.6TB/s(写入慢很多),约为HBM4规范最高带宽的55%。
③ 但NAND天生延迟高、写入慢、按块读取、擦写寿命有限,注定无法取代HBM:其读取延迟约1~10us,DRAM仅约0.1us,写入还要再慢10~100倍;按块读取则意味着每次都会夹带不需要的数据,实际有效带宽要打折扣。
因此HBF只适合不需要频繁读写的数据,如全量模型参数(非激活)、压缩后的上下文缓存、暂未调用的MoE专家参数等。
c. 混合架构,最可能的结局?
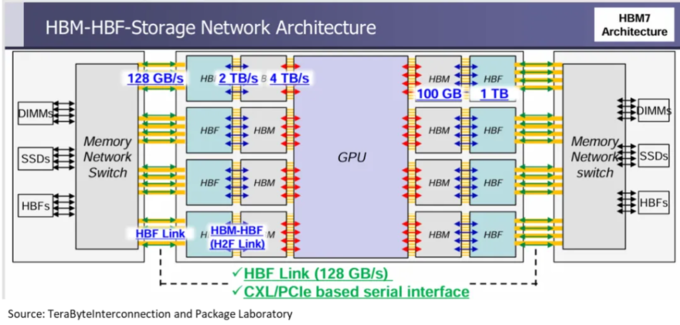
以上讨论的各种方法,在传输速度、容量、成本这三者上都无法兼备,因而目前业内展望的一个最可能的远期解是,采取多级、混合的存储架构。例如在XPU芯片的一侧共同封装HBM提供高传输速度,负责需高频读写的数据,另一侧封装HBF提供更大的容量,负责相对更低频的数据。
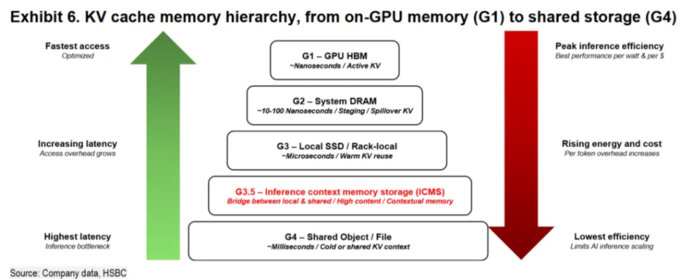
更远期的HBM7设想中,还会再加一层走PCIe协议的池化存储,让每颗XPU都能共享调用整个系统的DRAM、SSD和HBF。各级存储各司其职:HBM放最常用的参数和KV缓存,DDR和HBF次之,SSD等池化存储存放不太被调用的“冷”数据。
1.3、HBM层数会不增反减?
近期另一个热议的市场观点:HBM的层数可能不增反减。起因是英伟达下一代Rubin Ultra:每个计算核心配4颗HBM,最初规格为16层,后据供应链反馈降为12层,最近又传出可能改为8层。