


雷军紧逼马斯克:Grok刚上桌,MiMo就来了
今天 AI 圈出现了一个很巧的场面。马斯克刚把 Grok 4.7 端上桌,雷军这边的小米 MiMo-V2.6 也紧接着正式发布。
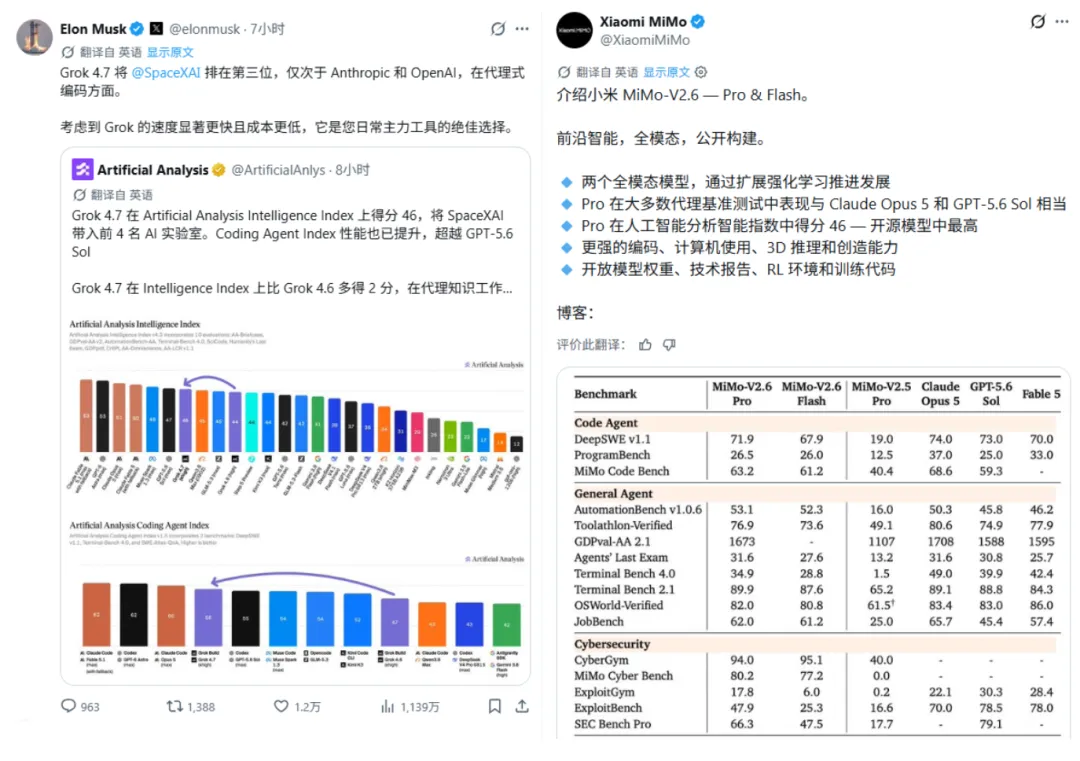
马斯克和小米,几乎前后脚交卷
一个是 SpaceXAI 的新旗舰,一个是小米刚直播烧了 6 天钱练出来的新模型。两边几乎前后脚交卷,做的事情居然也越来越像:别光坐在聊天框里陪人吹牛了,出去把活干完。
但仔细看完两家的发布,我发现更有意思的地方来了。马斯克和雷军,给 AI 选了两条不太一样的成长路线。一个在培养更能熬的超级员工,另一个,开始逼 AI 学会自己练级。
马斯克:先把 AI 练成耐操的打工人
Grok 4.7 这次最大的变化,可以浓缩成两个字:能熬。SpaceXAI 换了一个更大的基础模型,还专门把训练任务拉长,很多任务需要连续干几个小时。
模型得自己读代码、改文件、调用工具、检查结果,发现搞错了还得回头返工。这就很像真实上班:写一段代码容易,难的是下午两点接到需求,晚上九点还记得自己最开始到底要改什么。
Grok 4.7 重点补的就是这个。比如 Terminal-Bench 4.0,这项测试专门折腾模型的终端操作能力。Grok 4.6 只有 20.3%,到了 4.7 直接干到 38.0%,接近翻倍。
CursorBench 4.0 也从 40.4% 涨到 46.3%,DeepSWE v1.1 则做到 71.0%。这些数据均来自 SpaceXAI 官方发布页。
翻译成人话:马斯克这次没急着让 Grok 更会聊天,先解决了一个职场老大难——别干半小时就开始失忆。
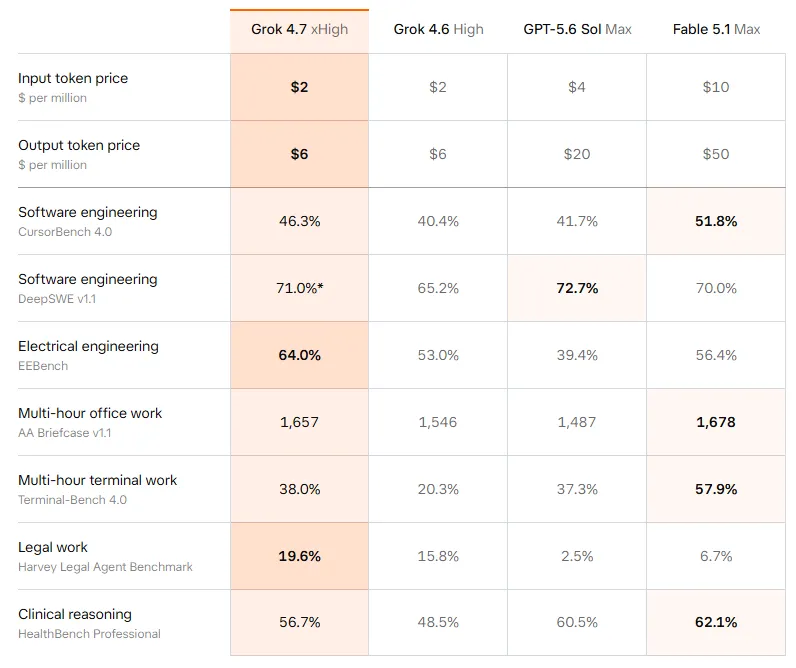
更狠的是,标准版还没涨价。每百万 Token 输入 2 美元、输出 6 美元,和上一代保持一致。
所以 Grok 4.7 的路线很直接:换个更壮的脑子,塞进 Cursor、Grok Build 这些工作环境里,狠狠干“把事情做完”这件事。
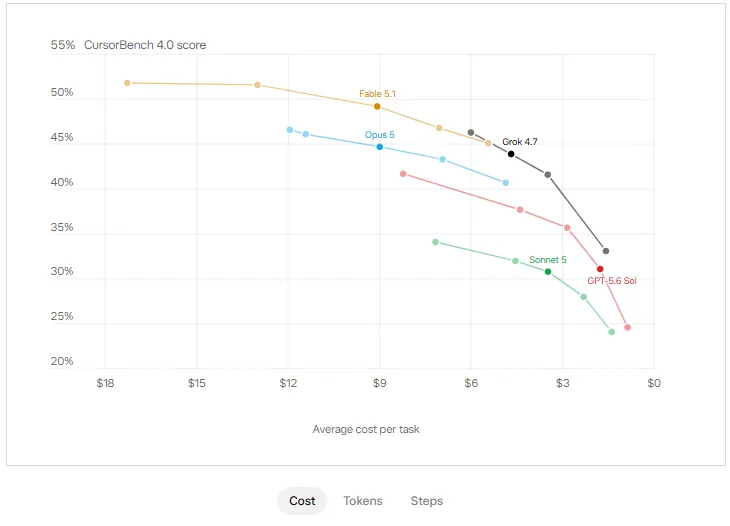
能力往上走,标准 API 单价没有跟着涨。
雷军:前几天烧的钱,今天出成绩了
小米这边的剧情就更有意思了。前几天大家还在围观罗福莉团队直播训练 MiMo,Token 在跑,模型在练,旁边的钱也一直在烧。现在直播结束,终于可以查成绩单了。
MiMo-V2.6-Flash,不到 6 天训练大约花了 85 万美元。Pro 更猛,约 262 万美元。两条线加起来:347 万美元。
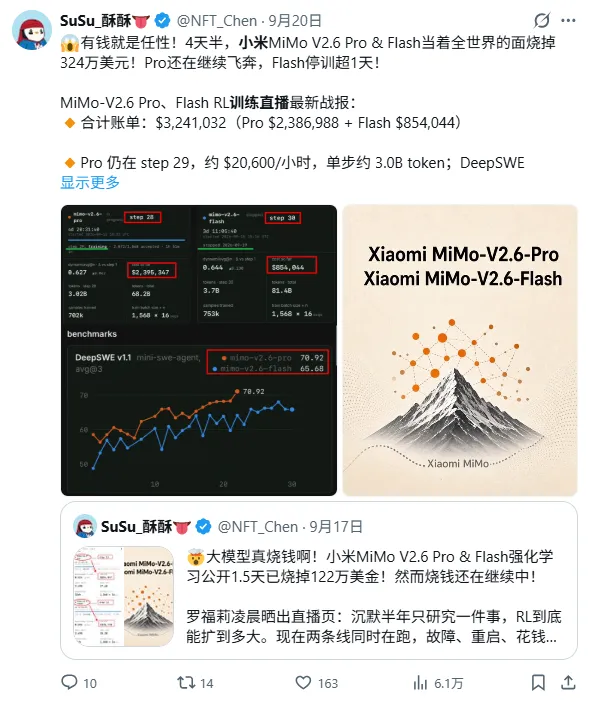
而且这只是短短 6 天。两款模型分别完成 30 步训练,累计大约 75 万条轨迹。上述训练成本和过程数据均由小米官方公布。
前几天还在直播烧钱,现在成绩单出来了。
雷军的钱烧完以后,模型确实涨分了。DeepSWE v1.1 上:Flash 从 48.8 涨到 65.7;Pro 从 58.4 涨到 72.6。
但这里有一点需要注意:这是小米自己在训练过程中跑出来的评测结果,不宜直接和其他厂商不同环境下的 DeepSWE 数字硬做减法。这组数字更值得看的,是同一套训练前后到底涨了多少。
而小米真正想证明的,也显然不只是:“347 万美元可以买多少 Benchmark 分”。他们盯上的是一个更激进的问题:如果不断给 AI 任务、环境、反馈和奖励,它能不能在训练过程中自己越练越强?
这就是小米这次反复强调的 RSI——递归自我改进。名字听着挺吓人,翻译成人话其实很好理解:以前人类把模型训练完,模型就毕业了。
现在小米想干的是:毕业以后别闲着,自己接着上自习。
马斯克让 AI 加班,雷军让 AI 自习
所以把今天这两场发布放在一起看,就很有意思。Grok 4.7 的路线是:更大的基础模型、更长的任务、更强的自检、更深地融进工具和工作流。
目标很清楚:这个员工坐在电脑前几个小时,尽量别跑偏,把活交出来。MiMo-V2.6 则是在另一头狂堆强化学习。
更大的 Batch、更多任务环境、更复杂的评分机制,还把模型权重、训练环境和 RL 框架一起开源。它想验证的是:员工除了干活,还能不能从一次次干活里学会怎么干得更好。
一个在练持续执行,一个在练持续进化。当然,这两条路线最后大概率还是会汇合。因为真正好用的 Agent,既不能干两个小时就把需求忘了,也不能每次撞墙都原地再撞一次。
它既得能熬,还得会长记性。
更有意思的是,它们已经开始抢同一份工作
看完两家的功能清单,我反而觉得跑分已经没那么有意思了。因为 Grok 和 MiMo 的“岗位说明书”,正在变得越来越像。
Grok 已经盯上代码、文档、PPT、法律、医疗和工程任务。MiMo 更夸张:写代码、做 PPT、画 Figma、剪视频、做 3D、操作电脑,甚至还能帮研究人员筛材料、做数学证明。