


实测Jev:当AI判断被卖成零件
2026年上半年,贵州茅台营业收入907亿元,涨了不到两个百分点;归母净利润445亿元,降了两个百分点;经营现金流707亿元,涨了将近5倍半。
如果把这段话放进一场考试,给5个描述让你选最贴合的那个,你会选什么。
9月15日,美国创业公司TypeSafe AI结束了两年隐身期,发布了一个叫Jev的模型,点燃了硅谷和AI圈的目光。
上手之后,我们把上面这道题喂给它,它连选三次,每次都选同一个描述,每次都满格把握。整道题花了不到0.001美元。
这个模型特殊性在于,它不写任何一个字,不解释为什么,不写代码或聊天,给它一段材料和几个备选描述,它只在其中勾一个,再报一个数字表示自己有多大把握。
这么一个只做减法的东西,一周内被OpenRouter等多家开发者平台和模型网关接入,几天内还有人做出了开源仿制版,引发了硅谷和AI圈的躁动。
Jev创始人Diogo Almeida在OpenAI做了4年研究,参与的InstructGPT是后来ChatGPT的前身。DCVC领投了4000万美元种子轮。模型名取自19世纪经济学家杰文斯,这个名字里藏着公司的全部赌注。
回到开头茅台那道题会发现,几个正确选项几乎把材料的事实复述了一遍,这道题本身没有多难,但真正值得问的是:一个连字都不写的AI,最终能引起这种热度,凭什么。
一. 从顾问换成开关
做过AI产品的人,都清楚一个日常困境。
一家公司的系统每天做着大量琐碎的判断,这封邮件算不算投诉,这份公告有没有提到诉讼,这笔退款该不该自动批。
最常见的方案是每次都请一个大模型来回答,但大模型的核心工作方式是生成,需要一字一字写,你问它一个“是或否”,它可能先写三段分析再给结论,按字数收费,等上几秒甚至几十秒,回来的文字还需要程序去拆解和校验,格式不对就得重来。
更麻烦的是,大模型说“我很确定”的时候,这句话本身并不附带刻度。
有时候“很确定”如同传统烹饪时的“少许”,究竟是7成还是9成,预制对应的那1-3成不确定落在哪个错误方向上,都无从得知。
于是,大量本该由机器自动完成的判断,卡在了某种两难里:用大模型太贵太慢,靠写死的规则又不够灵活。
Jev对此做了件看上去很简单的事:把答案提前写好,让模型只负责挑选。
把材料和备选答案一起丢给它,它同时给每个选项打出一个支持程度,选出最高的那个返回。因为不用逐字生成,速度快了不止一个数量级;因为只按读入的材料字数收费,不收输出费,每次判断的价格几乎可以忽略。
这里面最关键的商业差异,是计价单位变了。
大模型卖的是“字数”,Jev卖的是“一次判断”。
字数是服务的计价方式,一次判断是零件的计价方式。零件可以进采购清单,可以算单位经济账,可以塞进一行代码里跑上万次。如果这个零件足够便宜,软件里会冒出大量此前根本不值得调用AI的判断点。
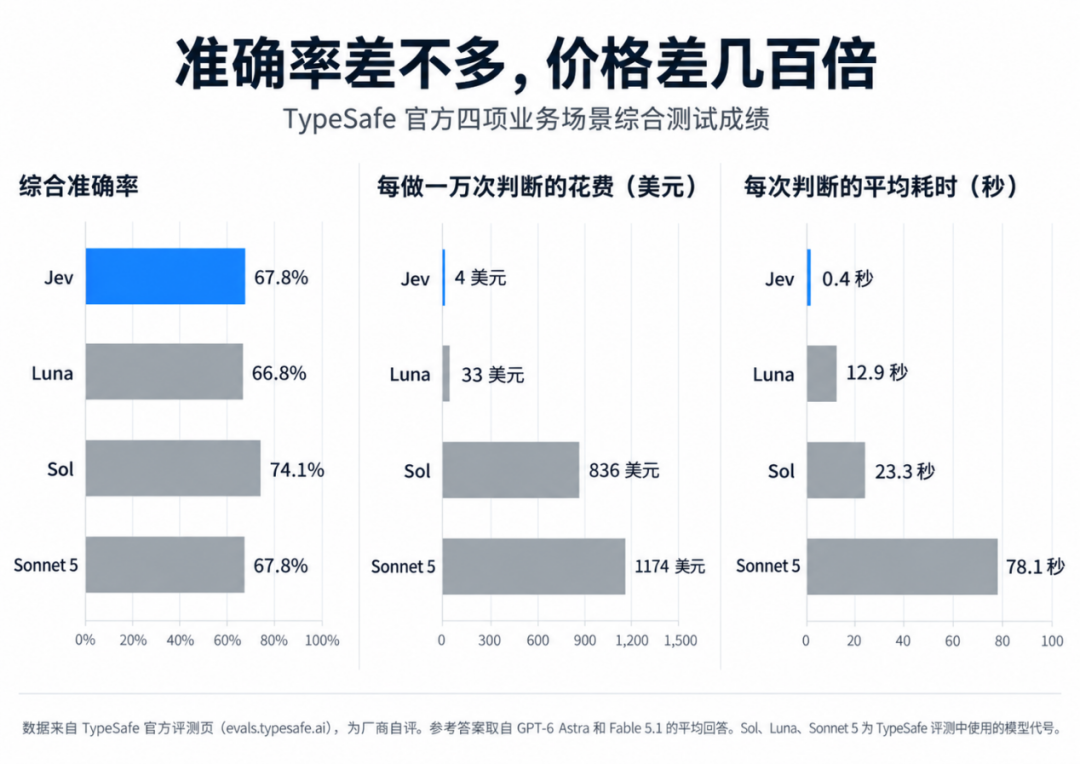
TypeSafe自己做过一组评测,在5个业务场景里把Jev和几个大模型工作流做了对比。
准确率上,Jev只追平了中档水平,比最强的那个低了6个百分点。全部优势集中在单价和速度上:每次判断便宜几百倍而且快几十倍。
另一个常被提起的卖点是“不会胡编”。
严格地说,Jev的答案只能落在你给定的选项里,所以它编不出一个凭空的概念或数字。
但它可以很有把握地选错,错误的形态从“写出一段不存在的话”变成了“自信地勾错一个选项”,后者更不容易被察觉。
创始人自己也承认,高把握下答错是可能的。
TypeSafe还做了一件在AI公司里不太常见的事——在说明书里列出了自己模型的所有已知短板。它写到,Jev读日期像读普通文字,不擅长做算术,材料里塞进无关内容会分心,英语表现最好,中文能用但弱一些,并建议非英语场景下先用自己的材料测试。
这份说明书之所以值得写,是因为它正好定义了我们接下来要做的事。
二. 面对猪周期,它犹豫了
TypeSafe的说明书写明中文弱于英文,并建议用户先自测。
Jev发布以来,公开可见的中文实测极少。所以我们解决了API后,用国内的财经场景材料做了一轮测试。
规矩定得很简单,材料取自监管部门、各公司的中报原始公告,用Wind做了交叉核对。每道题的参考答案在调用模型之前写好封存,写完一个字没改。
每道题反复问三遍,看它会不会自己改主意。
我们准备了15道题,覆盖从“两新”政策到降准降息、从煤炭供应冲击到汽车芯片短缺、从光伏到生猪周期,再加上宁德时代、比亚迪、万科、腾讯、茅台、美团、京东、泡泡玛特、安踏九家公司的中报。
45次判断,全部命中,每道题3次答案完全一致。
这张成绩单最没意思的部分就是那个满分,有意思的是第15题。
2021年8月的生猪存栏同比增了将近3成,养殖户每头猪平均亏损上千元,能繁母猪的存栏同比还在涨,尽管环比已经下降了,过剩还没结束,产能收缩的信号已经出现,这道题正好站在拐点上。
Jev3轮都选了“从过剩走向再平衡”,但这是15道题里唯一一道把握没有拉满的,三轮分别报出85%、88%、85%。剩下那一成多不确定,它给了“仍然过剩”,没有给别的错误方向。
一串满格把握什么也说明不了,这个犹豫说明它仍然形成一定的判断力。
满分的原因和测试题目有关。
比如增长率,“同比增长54.80%”“同比下降7.13%”,都是提前算好递给它的,它从头到尾没做过一次加减法。
TypeSafe自己的评测里,Jev最差的一项是发票核对,要比对金额、数量和交货日期,只拿了61.8%,TypeSafe的说明书也写着:算术请留在代码里。
我们相当于照着说明书出了一张卷子,把它已知短板都绕开了。
一个模型表现好坏与否,更取决于给它出题的设计,这也意味着,围绕它做产品的人,核心竞争力可能落在选项设计和数据预处理上。
接着我们做了第二轮测试,把算账的活还给它。
三. 同一道除法,连错10次
第二轮选了3家公司,出了26道题,每道反复问5遍,题目和我们预测一样,在调用之前全部封存。
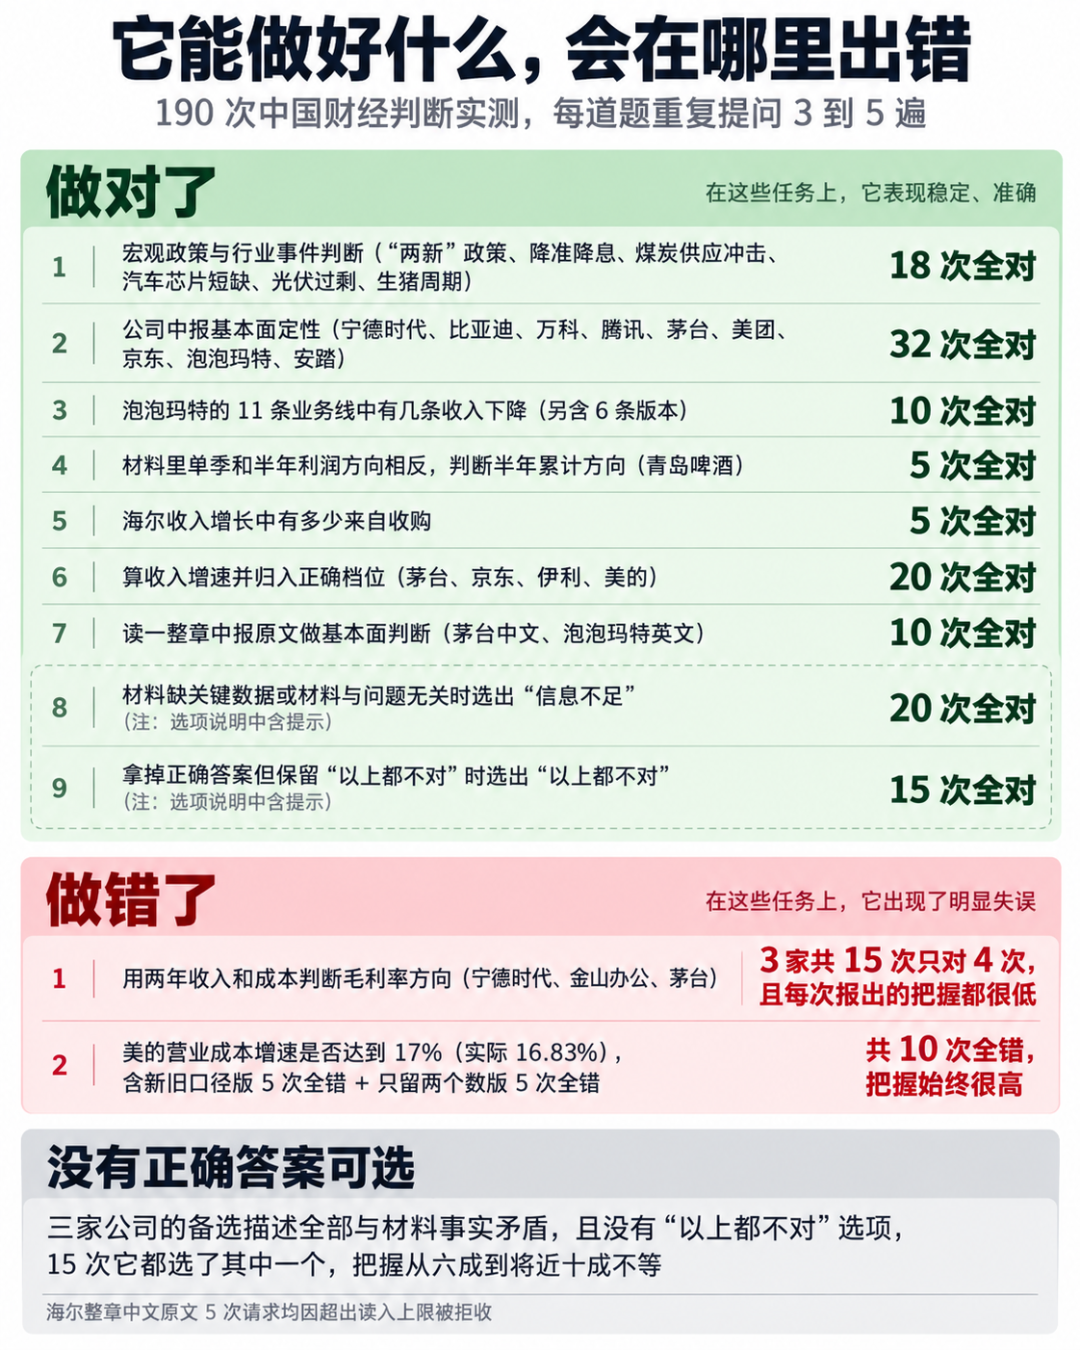
我们押了13处它会失手,最后只中了两处。
例如它数数居然数对了,泡泡玛特半年报里11个IP和业务线的收入两列中,数出其中几个下降了,它5轮给出的区间都是对的,只是列表越长越不确定。TypeSafe的说明书说它不会可靠计数,这道题它做到了。
青岛啤酒的二季度利润在降,上半年累计利润在涨,方向相反地混在同一段材料里,5次都没被单季数字带偏;海尔2024年的收入增长有多少来自年底完成的3笔收购,有多少来自自身,需要用总增量减去收购贡献再算比例,它5次都归对了。
4家公司的收入增速分档题也全部答对,比如针对伊利业绩,实际增速4.13%,分界线定在4%,只差0.13个百分点,这道题给了97%的把握。