

震撼,谷歌破解了RSI?
谷歌,可能已经破解了RSI!
就在刚刚,谷歌联合 Google DeepMind、马里兰大学及弗吉尼亚大学,发表了一篇重磅论文。
这一次,他们展示了一条完全不同的RSI路线:AI自我进化,居然可以靠做梦?
这一次,谷歌是让智能体把自己走过的每一步存成一棵树,然后在树里「做梦」。
在梦里练出更优的探索策略,再回到现实继续干。
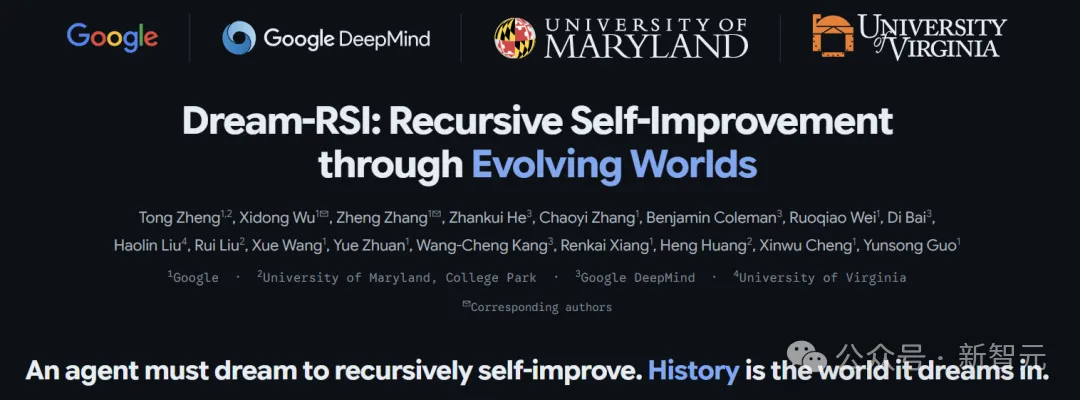
论文地址:https://arxiv.org/abs/2609.14858
Dream-RSI的效果可以说是相当震撼:
算法优化任务,主流进化搜索系统需要跑51200代,Dream-RSI调用317次就达到了同等水平。
圆填充问题,追平谷歌自家AlphaEvolveV2的最强纪录。
GPU内核优化,达到同等性能,生成次数暴降2.43倍。
底层权重一字未改,Gemini 3.1 Pro和3.7 Flash均可套用。
此外还有一个更有意思的结论,人给AI指方向,反而比不指更差。
论文一挂上arXiv,X上先炸了。网友Mark Kretschmann高呼:「谷歌可能刚刚破解了递归自我改进」!
论文一作Tong Zheng是马里兰大学二年级博士生,今年夏天才以学生研究员的身份进入谷歌。他身后是17人的作者团,包括DeepMind研究员与讲席教授。
要实现递归自我改进,智能体必须学会做梦。而历史,就是它们做梦的世界。
Tong Zheng在Hugging Face上留下这样一句话,它也是整篇论文的内核。
历史,就是它做梦的世界
Dream-RSI要解决的,是整个进化搜索领域最卡脖子的一环。
以AlphaEvolve为代表的系统早已证明,让编码智能体跑进化搜索,能发现人类没找到的算法。但它们有一个死穴,探索策略全靠人手写死。
哪个分支该多分配算力,哪个分支该尽早剪掉,什么时候该开并行,全靠工程师预先定好。搜索空间一大,固定策略就会把算力砸进死胡同,而且还不长记性。
那让策略自己进化行不行?理论上行,但问题出在评估成本上。
评估一段候选代码,跑一次就知道好坏。而评估一套探索策略,则需要让它带着智能体从头跑完几百上千轮,看最后挖出来的东西好不好,才能给这套策略打分。每改一版策略,就要重跑一遍整个发现过程,等几天出一个分数,没人耗得起。
对此Dream-RSI的解法是,跑过的过程存下来,评估新策略时不再重跑,直接拿旧过程回放。
具体来说,它把「干活」和「决定怎么干」拆成了两层。
-底层是负责执行的「发现智能体」(Discovery Agent),由Gemini 3.1 Pro或3.7 Flash驱动。它每次接过一个工作区,读取上下文,改出一版新候选代码,交由评估器打分。
-顶层是轻量的编排层,里面装着「探索策略」(一段Python代码),决定每一轮从哪个节点继续、一次开多少个并行尝试、何时止损。
底层模型不动,自我进化的对象只有这段策略代码。
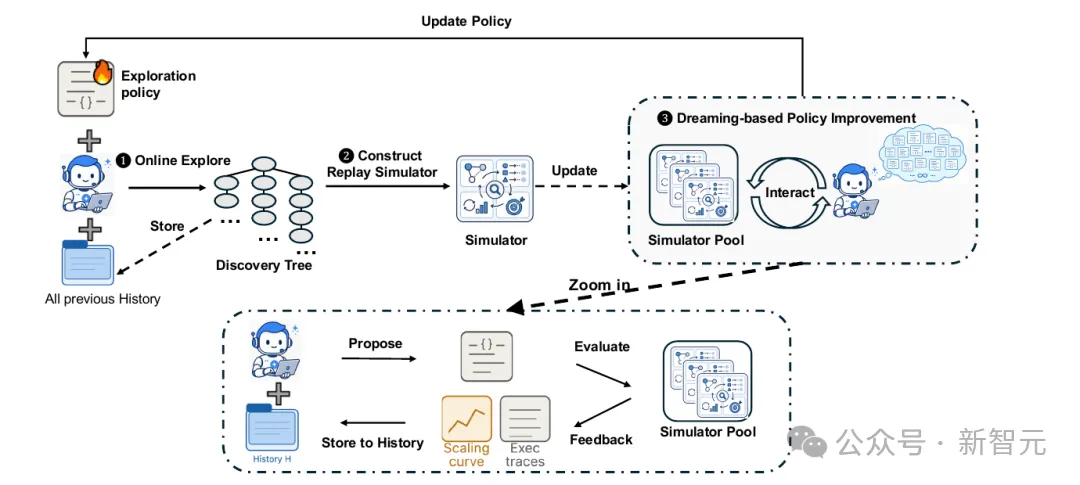
每一次真实探索的结果都会存进一棵「发现树」。根节点是初始工作区,每个子节点记着一次尝试的完整现场,包括文件系统快照、生成的产物、评估诊断和得分。
这棵树,就是模拟器。
策略要做的决定只有一类,从哪些节点继续、一次开几个。而每个节点往下走会得到什么结果,树里已经记着了。
所以策略要迭代时,不用再去真实环境跑代码,直接在长好的树上重走一遍历史就行——
想试「这条路多走两步」,就读取树里对应的记录;想试「那条路早点放弃」,就少读几个节点。
整个评估过程不调用一次模型,不跑一行代码,只读历史。
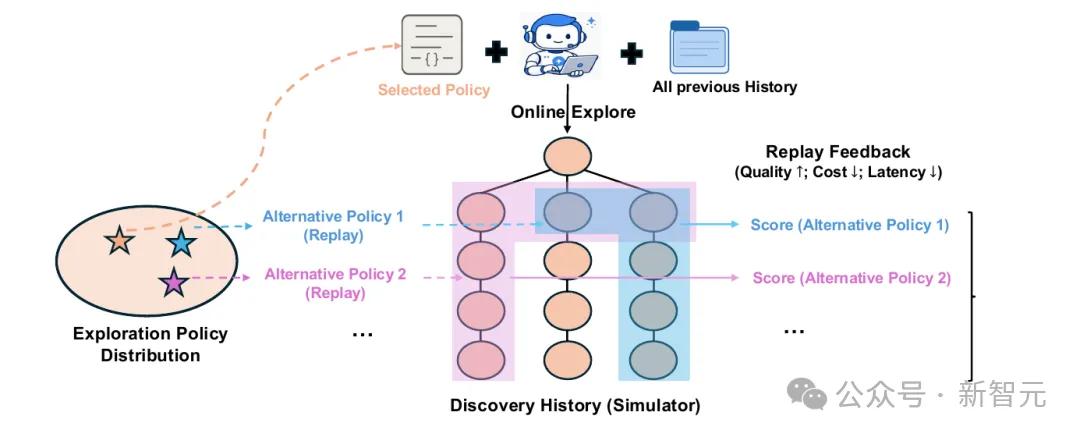
论文把这种机制叫做「做梦」。就像棋手复盘,不需要重新摆盘再下一遍,翻棋谱就够了。