

AI时代,光互联和光芯片越来越重要
当前,全球都在大规模建设AI基础设施。大家最容易比较的是“算力”。但算力究竟由什么决定?“第一,你有多少GPU;第二,每一颗GPU自己的计算能力有多强;第三,这些GPU之间能不能高效率协同计算。”中国工程院外籍院士常瑞华8月18日在科技创新院士报告厅第20期发表演讲,她认为,不管是在AI计算中心内部,还是机器人、汽车和各种智能设备上,光互联和光芯片都会越来越重要。
本次活动由深圳创新发展研究院、深圳中国科学院院士活动基地、中关村产业转型升级研究院等机构共同主办。
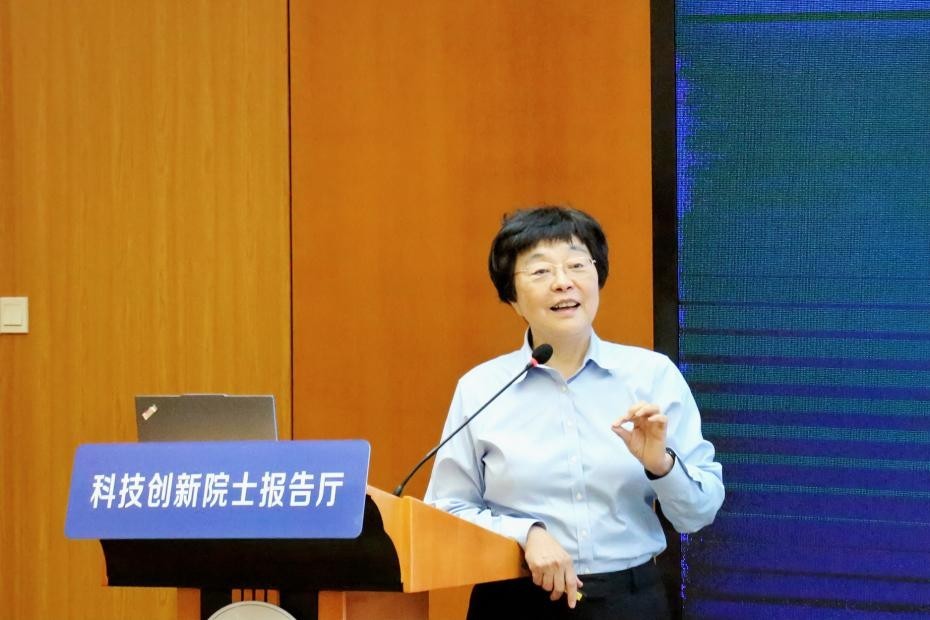
中国工程院外籍院士常瑞华发表演讲。
以下内容根据常瑞华院士演讲记录整理,经本人审订。
人工智能其实并不是这几年才出现的。作为一个研究领域,它从20世纪50年代开始逐渐发展,后来经历过几次高潮和低谷,也经历过所谓的“AI寒冬”。过去有过好几次“狼来了”,大家听见楼梯响,却一直没有真正看到那个“人”走下来。
真正改变公众认知的一个标志性事件,是ChatGPT。从ChatGPT开始,普通人第一次能够非常直接地操作一个具有高度通用性的AI系统,切身感受到它究竟能够做什么。推出后短短几年时间,AI就在全社会获得了非常快速、非常大规模的应用。
与此同时,AI的基础设施,也就是我们通常所说的人工智能智算中心,正在爆发式增长。在这样一个时代里,我们通常关注的是GPU、CPU这些电子芯片,但是我们做的不是传统意义上的电子计算芯片,而是光芯片。所以我今天希望回答一个问题:在AI时代,光芯片究竟扮演什么角色?
一、光芯片如何走进现代信息世界
(一)从铜到光:光纤开启高速通信时代
如果一定要给现代光纤通信找一个非常重要的起点,我认为可以追溯到1966年,华裔科学家高锟(K.C.Kao)联合他的同事乔治·霍克汉姆(G.A.Hockham),发表了奠基性的论文《光频率介质纤维表面波导》,他们指出:如果能够把玻璃中的杂质降低到足够程度,那么光就可以在一根像头发丝一样细的玻璃纤维中,以足够低的损耗传播很长距离,从而用于通信。
今天我们的信息可以通过海底光缆跨越太平洋,也可以穿越整个大陆,但是在那个年代,大家理解的“玻璃”就是我们身边的玻璃杯、玻璃窗。没有多少人会相信,玻璃有一天能够取代大量铜线,成为现代信息通信最重要的基础载体之一。所以这是一个开创性的贡献。
从历史上看,我们先有电报,后有电话。到20世纪中期,大量通信依赖同轴电缆。它本质上仍然是一种铜导体,只是结构经过特别设计,可以承载更高频率、更大容量的信号。后来又发展出微波通信。大家可以把它和今天的无线通信作一个直观类比,比如Wi-Fi也工作在微波频段。但是无线局域网和微波链路存在传播距离、频谱资源等方面的限制。
于是人们开始寻找新的传输介质。以前述1966年为起点,现代光纤通信的大门真正打开了。
后来又出现WDM(波分复用)、SDM(空分复用)等技术,使我们可以利用不同波长或者不同空间通道,同时传输大量信息。
(二)光纤与光芯片:共同造就现代光通信
光纤本身只是一种传输介质,就像铁路的轨道,真正承载信息在里面跑的,是光。现代高速光纤通信中最重要的光源,是半导体激光器。
激光有几个重要特征:一是方向性非常好,发散角很小;二是光谱可以非常窄,通俗讲就是“颜色很纯”;三是具有很好的相干性。这些性质使激光特别适合高速通信、精密测量、工业加工和医疗等应用。
早期激光器有一个共同的问题:体积比较大,制造也不像芯片那样可以大规模复制。因此,如果希望激光像电子器件一样走进千家万户、走进每一台计算机、每一个数据中心,就必须把它做成芯片。
传统的硅芯片主要以硅为基础。硅当然是一种非常优秀的半导体,但它是间接带隙半导体,本身并不适合作为高效率发光材料。而砷化镓、磷化铟、氮化镓等化合物半导体,则可以非常有效地发光。比如大家熟悉的蓝光LED,就大量采用氮化镓材料体系。在国内产业界有时候也会把砷化镓、磷化铟称为第二代半导体,把氮化镓、SiC碳化硅等称为第三代半导体。
半导体激光器的发明是一个非常关键的转折。半导体激光芯片的出现,相当于给光纤这条“高速铁路”配上了可以规模化制造的“列车”。光纤与半导体激光器结合在一起,才真正造就了今天的信息世界。
赵梓森院士长期在武汉邮电科学研究院工作,是我国光纤通信事业的重要奠基人之一。20世纪70年代,他就开始推动中国自己的光纤研究。1976年前后,我国研制出了自己的石英光纤,后来又不断降低损耗,逐步建立起自主的光纤通信技术体系。所以,中国在光纤通信领域走得也非常早,而且走的是一条坚持自主研发的道路。
(三)从通信到计算:光芯片支撑高速互联
我们把时间放到2000年前后,最早的光纤主要是铺在城市之间、国家之间,用来做电信通信。
但是随着计算机越来越快,铜线在计算机内部和数据中心内部也开始不够用了。2002年前后,日本电气公司的“地球模拟器”超级计算机内部仍然主要依赖电子互联。
到了2000年代中后期,大型超级计算机已经开始大规模采用有源光缆和光纤互联。比如IBM“走鹃”超级计算机系统中,我们已经可以明显看到大量光纤互联。在这些短距离多模光纤链路背后,有一个非常重要的激光光源,就是VCSEL(垂直腔面发射激光器芯片)。
这背后有一个产业背景。计算速度对于金融交易尤其重要,在高频交易中,毫秒甚至微秒级的时延差异都有可能对应非常大的经济价值。所以很多最先进的计算和高速互联技术,往往会首先出现在那些对时延极其敏感的领域。后来谷歌公开了大型数据中心的内部照片,大家才更直观地看到:一个互联网公司的核心基础设施,其实不是简单的搜索引擎,而是后面的计算、存储和光纤网络。
一台计算机,从最基本的角度看,有三件事情特别重要:计算、输入/输出、内存/存储。今天我们讨论AI智算中心,讨论英伟达,本质上仍然绕不开这三件事情。
传统数据中心内部不是所有距离都一样。一个机架里面有很多服务器,上面通常有机架顶部交换机。不同机架之间还要通过更上层的汇聚交换机或者骨干交换机继续互联。所以,数据中心里的链路有短有长。
在几十米到一百米的中短距离内,VCSEL(垂直腔面发射激光器芯片)加多模光纤,一直是非常重要的解决方案。距离再长,就更多使用单模光纤,配合边发射激光芯片或者硅光子技术。
这里需比较下几种常见的光源。
1.LED(发光二极管)
以蓝光LED为例,主要使用氮化镓材料。LED的优点是制程成熟、成本低,而且天然适合做大面积二维阵列。但LED不是激光,它的光束发散比较大,光谱也比较宽,因此要把它高效率地耦合进一根很细的光纤并不容易。它的高速直接调制能力与最先进的高速激光器相比也存在明显差距。
2.Edge-Emitting Laser(边发射激光芯片)
传统边发射激光芯片的光,是从芯片侧面出来的。经过几十年发展,这类工艺已经非常成熟,而且它在远距离、高速通信里仍然极其重要。但是从器件结构上,它天然不如面发射器件适合做大型二维阵列。
3.VCSEL(垂直腔面发射激光器芯片)
那么,有没有一种激光器,既具有激光的高速、高效率、容易耦合的优点,又能够像LED一样从晶圆表面出光,便于晶圆级制造、测试,并且可以很容易做成二维阵列?
这就是垂直腔面发射激光器芯片,它是从晶圆表面垂直出光的。通过特殊的外延结构和光学谐振腔,它能够产生窄光谱的激光输出,还可直接调制(通俗讲就是让光的强弱按照数据高速变化,把电信号转换成光信号。)。调制越快,单位时间内能够传输的信息就越多。而高速激光器能够做到的调制速度,是普通LED很难达到的。
VCSEL还有几个重要优势:晶圆级制造;晶圆级测试;和多模光纤的耦合效率比较高;可以做到很低的系统功耗;天然适合形成二维阵列。
传统边发射激光器能够集成几个通道已经很有意义,但是VCSEL天然就是表面出光,我们可以很容易地在二维平面上布置几十个、几百个甚至更多的发光点。因此,我一直认为,在AI时代,VCSEL会出现新的机会。
二、AI智算中心里的光互联
(一)互联正在成为算力的一部分
现在全球都在大规模建设AI基础设施。大家最容易比较的是“算力”。但算力究竟由什么决定?
第一,你有多少GPU,所以媒体经常讲“万卡集群”“十万卡集群”;第二,每一颗GPU自己的计算能力有多强;第三,这些GPU之间能不能高效率协同计算,真正的大模型训练,需要成百上千颗,甚至上万颗GPU协同工作。
所以互联本身,就是计算系统的一部分。
以英伟达的NVL72机架级系统为例。这个“72”指的是72颗Blackwell GPU,同时配有36颗Grace CPU。整个系统通过英伟达高速GPU互联技术和NVSwitch(NVLink交换芯片)来完成高带宽GPU互联,其中一套NVL72机架里使用18颗NVSwitch。下一步,要把几十、几百乃至上千颗加速器组成更大的超节点,就越来越需要光。
华为超节点也说明了这一趋势,国内也走得非常快。比如华为此前推出的升腾384超节点,已经将数百颗AI加速器组成一个统一的计算系统,其中大规模使用高速光互联。到2026年7月,华为又公开展示了升腾950超节点的1024卡集群。
这里我想强调的是384、1024这些数字背后的趋势:一个计算节点里协同工作的AI处理器数量正在迅速增加。
假设一颗GPU可以看成一个“大脑”,那么10个大脑协同、1000个大脑协同、1万个大脑协同,整个系统能力当然不是一个概念。所以这个数字还会继续增加。而处理器数量越多,对互联的要求就越高。因此,我认为AI算力的下一场竞争,很大程度上也是互联能力的竞争。
(二)AI推动光互联架构重构
是不是把所有铜线换成光纤就解决问题了?没这么简单。
随着GPU数量增加,一套AI系统需要的光链路数量可能是传统数据中心的十倍甚至更多。与此同时,每个通道的速率也越来越高。从53 Gbps,到106 Gbps,再到212 Gbps,现在整个产业正在向更高速率演进。即使光本身适合高速传输,如果我们完全沿用传统可插拔光模块的体系,系统的功耗和成本也会变得非常大。
英伟达曾经用一个大型AI工厂示意场景说明这个问题:在相同服务器规模下,AI系统对高速光互联的数量和功耗需求,可以比传统云计算数据中心高出一个数量级。这个数字不是说所有AI数据中心都固定消耗这么多电,而是说明一个趋势:按照过去的办法简单堆光模块,未来也可能承受不起。所以我们必须重新设计整个光互联架构。
今天AI计算中心里常常会听到两个词。Scale-up(纵向扩展,也可理解为节点内高带宽扩展)和Scale-out(横向扩展,也可理解为节点间扩展)。Scale-up更强调把大量GPU通过极高带宽、极低时延的网络紧密地组织在一起,让它们尽量像“一台机器”一样协同工作;Scale-out则是在更大的范围内把不同节点、不同计算域继续连接起来。