


论文不只用来读,还能直接跑
将科研论文重新构想为可交互、可靠的AI智能体 Reimagining research papers as interactive and reliable AI agents
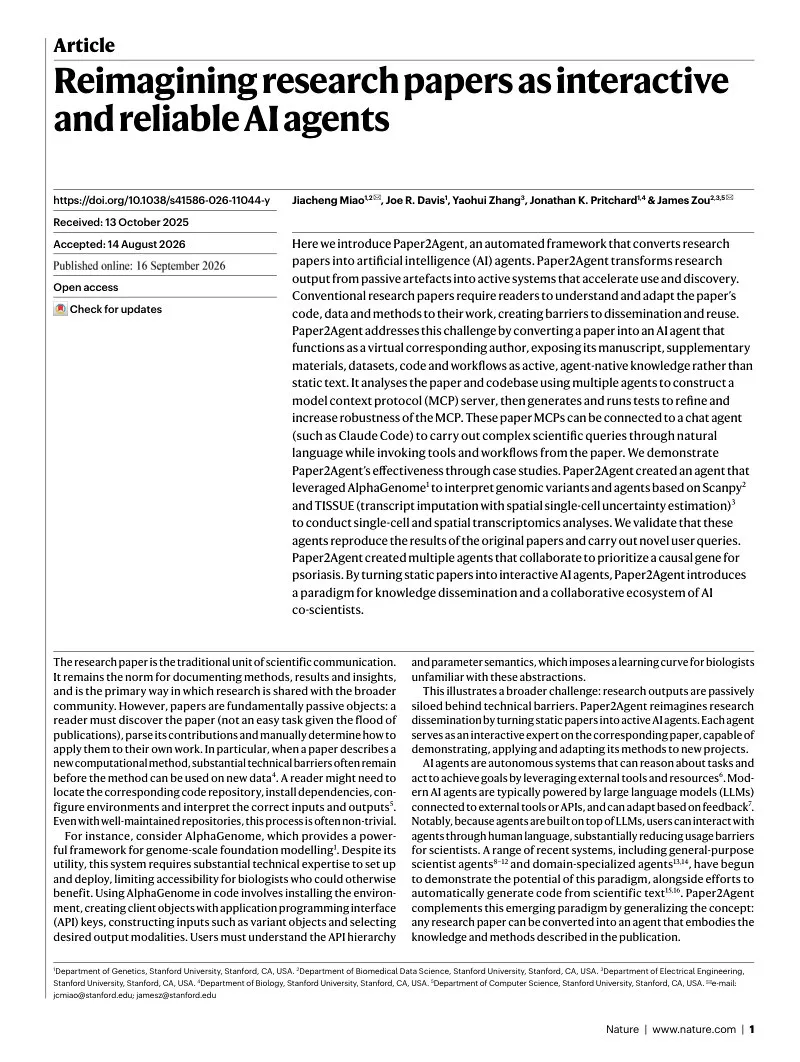
原论文首页 原题、作者与摘要。 来源:Miao等,Nature,doi:10.1038/s41586-026-11044-y,PDF第1页。原图保留,中文图注据原文译述。 作者:Jiacheng Miao1,2,✉,Joe R. Davis1,Yaohui Zhang3,Jonathan K. Pritchard1,4,James Zou2,3,5,✉ 1 斯坦福大学遗传学系(Department of Genetics) 2 斯坦福大学生物医学数据科学系(Department of Biomedical Data Science) 3 斯坦福大学电气工程系(Department of Electrical Engineering) 4 斯坦福大学生物学系(Department of Biology) 5 斯坦福大学计算机科学系(Department of Computer Science) 期刊:Nature,Article DOI:10.1038/s41586-026-11044-y 通讯作者:Jiacheng Miao、James Zou 摘要 Abstract · 原文第1页 本研究介绍Paper2Agent,一个将研究论文转化为人工智能(AI)智能体的自动化框架。它使研究成果从被动的材料转变为能够促进应用与发现的主动系统。传统论文要求读者自行理解并改造其代码、数据和方法,才能用于自己的研究,这给知识传播与重复利用带来了障碍。 Paper2Agent通过构建充当“虚拟通讯作者”的论文智能体,应对这一挑战。它将论文正文、补充材料、数据集、代码和工作流程转化为智能体可直接使用的知识,而非仅作为静态文本保存。系统使用多个智能体分析论文及代码库,构建模型上下文协议(MCP)服务器,再生成并运行测试,以改进服务器的稳健性。这些论文MCP可以连接Claude Code等对话智能体,使用户通过自然语言提出复杂科学问题,并调用论文中的工具和流程完成分析。 作者通过多个案例展示其有效性:基于AlphaGenome构建的智能体解释基因组变异;基于Scanpy和TISSUE构建的智能体完成单细胞与空间转录组学分析。这些智能体既能复现原论文的结果,也能处理新的用户查询。多个论文智能体还可以协作,为银屑病优先筛选候选因果基因。作者据此提出,将静态论文转化为可交互的AI智能体,可以形成新的知识传播方式以及协作式AI共同科学家体系。 01 引言 Introduction(原文引言无独立标题) · 原文第1–2页 研究论文是传统科学交流的基本单元,也是记录方法、结果和认识,并向更广泛群体传播研究工作的主要方式。然而,论文在本质上仍是被动对象:读者首先要在大量出版物中发现相关论文,再解析其贡献,并自行判断如何将这些成果用于自己的工作。 当论文提出一种新的计算方法时,将其用于新数据之前,往往还存在明显的技术门槛。读者可能需要寻找代码仓库、安装依赖、配置环境,并理解正确的输入和输出。即使代码仓库维护良好,这个过程也未必简单。 AlphaGenome就是一个例子。它提供了基因组尺度的基础模型,但使用者需要安装环境、利用API密钥创建客户端对象、构建变异等输入对象,并选择所需的输出模态。用户还必须理解API的层级和参数含义,这给不熟悉这些程序抽象的生物学研究者带来了学习成本。 这些问题反映出更普遍的障碍:研究成果被技术门槛隔离,难以直接复用。Paper2Agent将静态论文转化为主动的AI智能体,使每个智能体都成为对应论文的交互式专家,能够演示、应用并调整论文方法,以服务新的项目。 AI智能体能够围绕任务进行推理,并借助外部工具和资源采取行动。现代智能体通常由连接外部工具或API的大语言模型驱动,并能够根据反馈调整行为。用户可以用自然语言与之交互,从而降低使用门槛。Paper2Agent在通用科学家智能体、领域专用智能体,以及从科学文本自动生成代码等工作的基础上,进一步提出将研究论文本身转化为包含其知识与方法的智能体。 其核心思路是将论文表示为MCP服务器。MCP是一种标准化协议,使结构化API与工具能够被大语言模型和智能体框架直接访问。转换过程识别论文的关键贡献,将其封装到MCP服务器中,再连接基于大语言模型的智能体,以支持自然语言查询和自动执行。例如,用户不必亲自克隆AlphaGenome仓库并配置依赖,而可以直接询问:“解释这个变异对肌肉细胞染色质可及性的预期影响。” 可执行论文、Papers with Code、Binder、CodeOcean和论文转代码系统等既有工作,已经改善了研究结果的可复现性,但理解、定制和将代码用于新项目仍有障碍。Paper2Agent的目标不只是对论文文本进行检索增强生成,而是把正文、补充材料、代码、数据集、可执行示例及分析流程整体转化为智能体可用的研究成果。论文因此既能回答问题,也能复现分析、处理新数据,并与其他论文智能体协作。 02 Paper2Agent概述 Overview of Paper2Agent · 原文第2–3页 Paper2Agent是一个多智能体AI系统,能够以很少的人工输入,将研究论文自动转化为可交互的AI智能体。作者强调这些论文智能体的两个特点。 可交互、易于使用。 用户可以通过自然语言指令执行复杂的科学分析,无须具备编程专长。 可靠且可复现。 每个工具都使用示例数据,与参考代码库报告的结果和图像进行对照验证;通过验证后予以固定,以保障可复现性。这一设计旨在减少“代码幻觉”及代码生成随机性带来的问题。每个工具还包含原论文的代码引用,使执行过程透明、可追溯。 框架包含两个组成部分:Paper2MCP从论文及代码库中提取信息,构建远程MCP服务器;智能体层则将该服务器作为上下文提供方,形成面向具体论文的AI智能体。为便于表述,作者为每篇论文配置一个MCP服务器和一个论文智能体,但同样的方法也适用于一组相关论文。每个服务器包括三类核心内容。 MCP工具(tools)是封装论文方法贡献的可执行函数。例如,AlphaGenome工具可以接收遗传变异,预测并可视化其对基因表达、染色质可及性等模态的影响。工具配有预先配置的运行环境。 MCP资源(resources)保存静态材料,包括正文、代码库,以及数据集、表格和图片等补充资料。例如,AlphaGenome资源包含其训练数据的链接。资源采用可访问、标准化的格式,以便智能体检索与整合。 MCP提示(prompts)是从论文或代码库中提取的简明指令,用于指导复杂、多步骤的科学工作流程。例如,Scanpy提示编码了单细胞数据预处理和聚类的执行顺序,协调工具和资源,使分析更加系统、可复现。 论文MCP服务器可部署在Hugging Face Spaces等远程平台上,以减少使用端的本地依赖配置问题。兼容的大语言模型或智能体可以连接这些服务器,执行复现检查、新数据分析或图像再生成。本研究的应用使用Claude Sonnet 4;用户给出“将这篇论文的方法用于新数据集”等指令后,智能体运行流程、生成结果并提供解释。 作者使用Claude Code实现Paper2Agent。工作流程首先识别论文关联的代码库,再调用环境智能体配置软件环境,以及提取智能体将核心方法封装成工具。测试智能体运行自动检查,持续修改代码与环境,直到结果符合参考输出。测试检查预期文件是否生成、数值是否落入容差范围、图像是否与参考图一致。反复验证失败的工具会被排除。 通过验证后,工具与环境被打包为MCP Python文件并部署,随后与对话智能体连接,形成可用的论文智能体。由于MCP具有模块化特征,同一个对话智能体可以连接多个论文MCP,同时使用多篇论文的工具和资源。
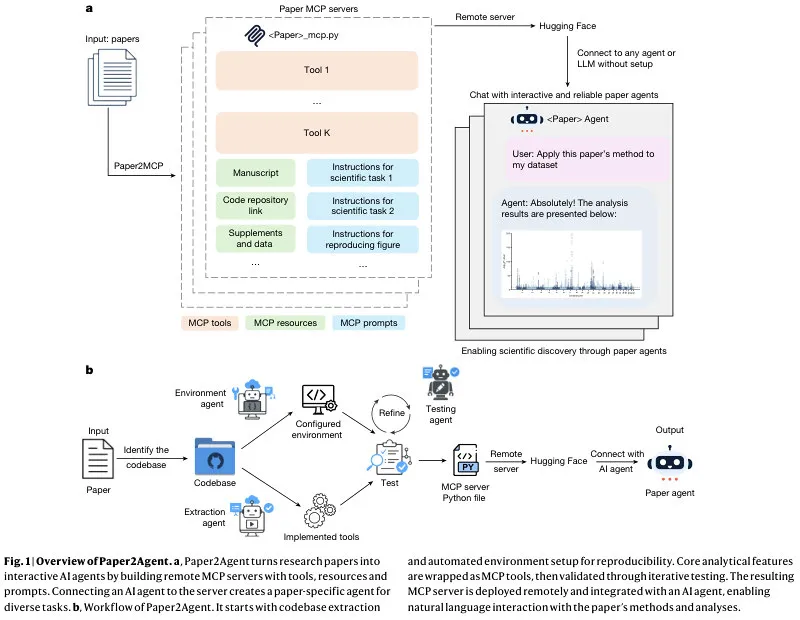
图1|Paper2Agent总体框架。 a,通过包含工具、资源和提示的远程MCP服务器,将研究论文转化为论文专用智能体。b,从代码库提取和环境配置开始,将核心分析功能封装为工具,经过迭代测试验证,再远程部署并与AI智能体连接,实现以自然语言调用论文的方法与分析。 来源:Miao等,Nature,doi:10.1038/s41586-026-11044-y,PDF第3页。原图保留,中文图注据原文译述。 03 用于基因组学的AlphaGenome智能体 AlphaGenome agent for genomics · 原文第2–5页 第一个案例是AlphaGenome智能体。AlphaGenome用于预测人类DNA序列中单核苷酸变异或突变对多种调控过程的影响。Paper2Agent将其转化为可交互智能体,使用户能够通过自然语言优先筛选疾病相关变异的候选因果基因、分析单个变异的调控作用,并为具有特定调控功能的合成DNA设计提供参考。 在一台个人笔记本电脑上,Paper2Agent约用45分钟、花费14美元,在无人干预的情况下生成了22个AlphaGenome MCP工具,全部通过自动验证。这是一次性的工具构建过程,生成的工具可在后续重复使用。工具覆盖单个与批量变异评分、序列级预测、组织本体查询,以及多种可视化功能。 例如,score_variant_effect()预测变异在不同组织和细胞类型中对基因表达、剪接及染色质可及性等模态的功能影响;visualize_variant_effects()生成相应图像。工具的输入参数可调整且有注释,使用者能够改变变异周围的序列上下文长度,或切换RNA-seq、ATAC–seq与ChIP–seq组蛋白轨迹等模态。每个工具还保留原始代码的可追溯链接。 作者将AlphaGenome智能体与人工执行得到的标准答案、可直接访问代码仓库的Claude Code(Claude + Repo),以及Biomni进行比较。评估时,Paper2Agent生成的智能体不能访问论文正文或原始仓库。两名领域专家依据预先定义的评分规则独立评判结果,评判一致率为96.7%。 在5次独立运行中,针对15个由教程衍生的查询,Paper2Agent的准确率为98.7 ± 1.3%,Claude + Repo和Biomni分别为82.7 ± 3.4%与37.3 ± 4.0%;针对15个新查询,三者分别为100.0 ± 0.0%、78.7 ± 4.4%和56.0 ± 3.4%。图2中的误差项为标准误(s.e.m.)。 针对30个研究者式开放问题——需要组合多个工具,并形成生物学综合判断——Paper2Agent准确率为82.7 ± 2.4%,Claude + Repo为56.7 ± 2.3%,Biomni为72.2 ± 2.2%。这些提升在改变提问措辞,以及将Claude + Repo升级为Claude Opus 4.6等较新模型后仍然存在。 效率方面,以运行时间中位数衡量,在教程查询上,Paper2Agent相对于Claude + Repo和Biomni分别取得1.9倍与3.1倍的提速;在新查询上,分别为2.9倍与3.8倍。作者认为,预先构建的论文工具在这些任务上提高了可靠性与执行效率。 作者还使用原AlphaGenome论文中的例子,分析变异chr1:109274968:G>T为何与低密度脂蛋白(LDL)胆固醇相关。智能体先制定计划,再生成输入文件、进行多模态变异评分、筛选相关组织、制作可视化,并通过行动与观察反馈不断调整分析,最终输出综合解释报告。 AlphaGenome智能体优先推荐SORT1为最可能的因果基因,而原AlphaGenome论文更强调CELSR2和PSRC1。智能体选择SORT1的依据包括:肝组织中的预测表达影响分位数得分为0.99983,以及SORT1编码的sortilin与LDL和极低密度脂蛋白(VLDL)分泌直接相关。 作者进一步查询GTEx数据,确认该变异是肝组织中SORT1的显著表达数量性状位点(eQTL,P = 1.1 × 10−65)。但CELSR2和PSRC1同样具有较高的AlphaGenome分位数得分(均为0.99998)及显著eQTL关联(P分别为4.7 × 10−46和8.5 × 10−50)。原文指出,这体现了在一个变异同时关联多个邻近基因的复杂GWAS位点上,明确归因的固有困难。 作者将这种解释差异视为Paper2Agent的一个用途:使用者可以用一条指令,调用独立的模型证据重新评估已发表结论,而不必另建分析流程。原有解释因此可以被动态地重新检视,而不是被视为固定答案。
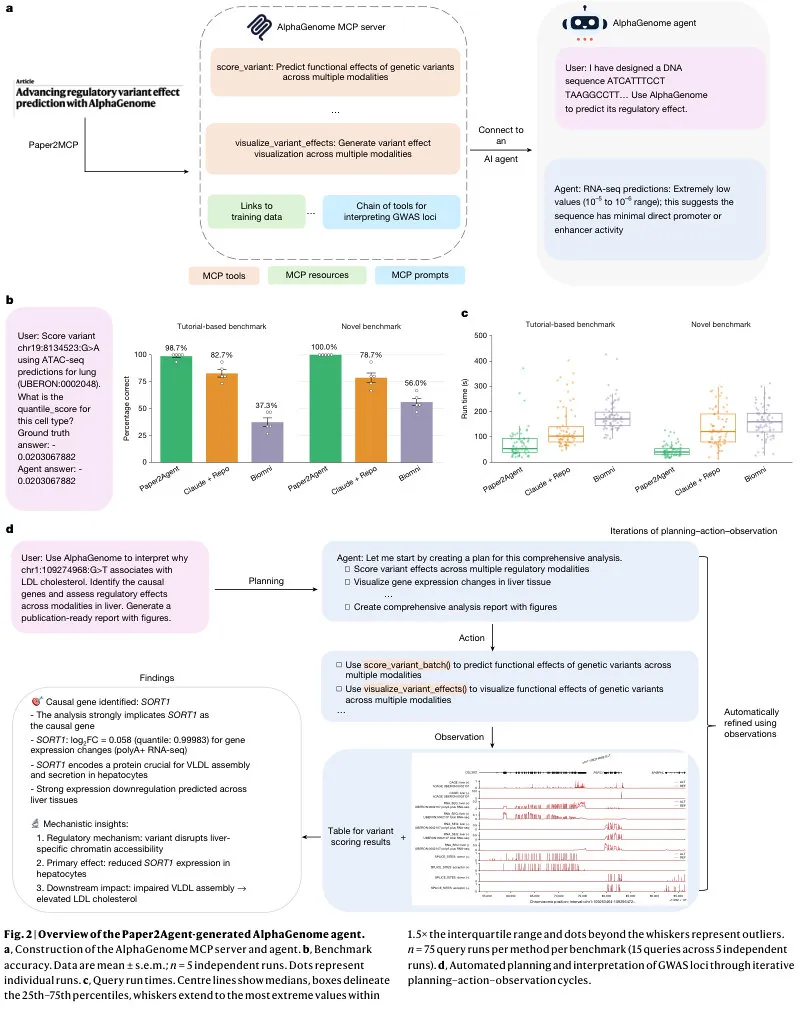
图2|Paper2Agent生成的AlphaGenome智能体。 a,MCP服务器及智能体的构建。b,基准准确率,报告均值 ± 标准误,n = 5次独立运行;点表示各次运行。c,查询时间:中线为中位数,箱体为第25至第75百分位,须线延伸至1.5倍四分位距以内的最远值,外部点为离群值;每种方法、每类基准包含75次查询运行。d,通过迭代的“计划—行动—观察”分析并解释GWAS位点。 来源:Miao等,Nature,doi:10.1038/s41586-026-11044-y,PDF第4页。原图保留,中文图注据原文译述。 04 用于单细胞分析的Scanpy智能体 Scanpy agent for single-cell analysis · 原文第5–6页 第二个案例是Scanpy智能体。Scanpy是分析大规模单细胞转录组数据的软件包,本研究聚焦其常见用途:单细胞数据预处理与聚类。在个人笔记本电脑上,Paper2Agent约用45分钟、花费13美元,生成了7个相关工具,全部通过自动验证。工具包括用于计算并可视化质控指标、筛选细胞和基因,以及检测双细胞的功能。 实际使用时,用户往往需要完整的预处理与聚类流程,而不是单独调用一个工具。要执行此类流程,智能体必须知道操作的正确顺序,或者由用户提供明确的分步指令。作者使用MCP提示解决这一问题,将执行顺序编码为标准化流程。提示由Paper2Agent直接从论文和代码库推断,无须人工整理。 Scanpy MCP提示依次包含质量控制、归一化、特征选择、降维、图构建、聚类与细胞类型注释。提示还要求智能体在分析前检查数据,并据此选择适当参数。用户只需提供数据路径,如data.h5ad,智能体即可执行流程并总结分析结果。 作者首先将其应用于4个未包含在Scanpy代码库中的公开单细胞数据集。按照同样参数处理时,智能体与人工研究者在质量控制后保留等价的细胞与基因数量,并在各聚类中得到等价的主要差异表达标记基因。为评估泛化性,作者进一步在7个不同的单细胞数据集上观察到,智能体能够依据数据特点调整参数。 原文还提供了将TISSUE论文转化为智能体、用于单细胞空间转录组学分析的案例,相关结果见扩展数据图1及补充说明。
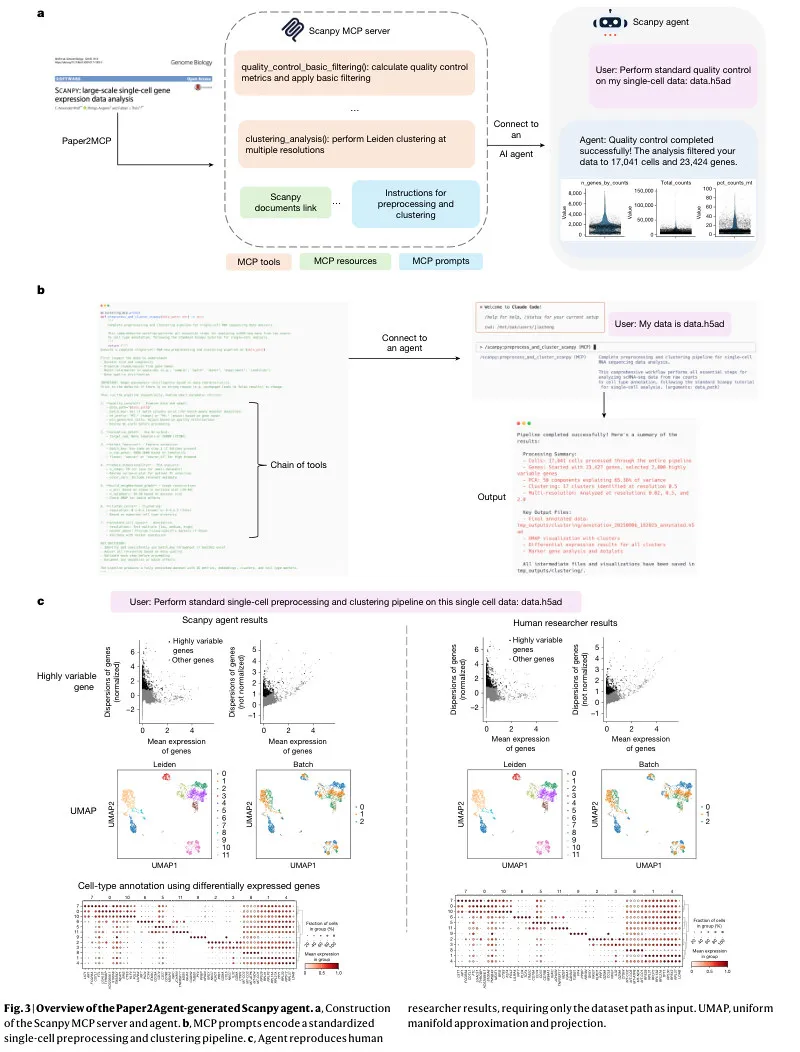
图3|Paper2Agent生成的Scanpy智能体。 a,Scanpy MCP服务器和智能体的构建。b,MCP提示编码标准化单细胞预处理与聚类流程。c,仅给出数据集路径,智能体即可复现人工研究者的分析结果。UMAP指统一流形逼近与投影。 来源:Miao等,Nature,doi:10.1038/s41586-026-11044-y,PDF第6页。原图保留,中文图注据原文译述。 05 Paper2Agent的大规模评估 Large-scale evaluation of Paper2Agent · 原文第5、7页 为检验可扩展性,作者端到端处理了三组异质论文,过程中不进行人工清理、代码修改或干预:100篇计算生物学论文、26篇以数据或发现为主的论文,以及10篇覆盖AI、统计学、计量经济学、博弈论和天体物理学的非生物计算论文。Paper2Agent为各论文建立结构化资源层;当代码库条件允许时,再构建可执行MCP工具层。 100篇计算生物学论文中,有74篇成功转化为智能体,共提出599个工具,其中593个通过自动验证。其余论文的主要失败原因包括缺少可执行代码、缺少数据或模型文件、环境与依赖失败,以及脚本无法泛化。 在300个教程衍生问题上,使用Sonnet 4的Paper2Agent准确率为91.2 ± 1.6%,高于直接访问仓库的Claude Code:使用Sonnet 4时为80.3 ± 2.3%,使用Sonnet 4.6时为86.3 ± 1.1%,两项比较均报告P < 0.0001。 Paper2Agent的每次查询成本和耗时分别为0.20美元与1.6分钟;直接使用Sonnet 4访问论文及仓库时,分别为0.38美元与4.3分钟。对于10篇非生物计算论文中的42项执行型任务,Paper2Agent在5次独立运行中的准确率为98.1 ± 0.8%,展示了超出计算生物学范围的适用性。 即使无法构建可执行工具,结构化资源层仍有用途。在26篇数据与发现类论文的100个综合问题上,资源层准确率为89.0 ± 3.1%,高于具备浏览器操作能力的Claude基线(82.0 ± 3.8%,P = 0.03);原文同时报告,其成本约为基线的1/34,速度约为基线的15倍。 附加分析没有发现生成MCP存在系统性的捷径学习证据;相关案例也显示,系统支持模型训练和自适应超参数调整。在打乱论文与问题配对的基准中,系统正确拒绝了100%的超出范围查询。 针对人为注入的依赖缺失、文件路径错误、拼写错误和弃用API等执行故障,Paper2Agent能够恢复可用的MCP服务器。作者还在没有可执行教程的仓库上生成并验证了功能性MCP,说明整理良好的教程有帮助,但并非严格必要条件。消融实验进一步表明,自动验证和多智能体设计对性能有贡献。 作者据此总结,Paper2Agent可以规模化地将异质论文转化为可查询的智能体:代码能够转换时提供可执行工具,不能转换时则提供结构化资源。 06 论文智能体协作促进发现 Paper agents collaborate for discovery · 原文第7–8页 科学合作常通过组合不同论文的认识推进,例如将新方法用于新数据集,但这一过程通常耗时且需要较多人工。Paper2Agent支持方法论文智能体与数据论文智能体直接协作,开展分析、检验假设并形成新的认识。 在GWAS位点上识别疾病相关靶基因并不容易,因为一个调控变异可能影响多个附近基因,需要超出原始位点定位的额外证据。作者以银屑病相关变异rs887314为案例,使用三个论文智能体:AlphaGenome、将大规模平行报告分析(MPRA)与单细胞CRISPR干扰(scCRISPRi)相结合的研究,以及CD4+ T细胞Perturb-seq研究。 AlphaGenome首先预测,在CD4+ T细胞中,GPR137是该位点受影响最强的基因,RNA-seq分位数得分为0.997,排名高于其他附近基因。为验证这一预测,研究者要求AI共同科学家交叉参考另外两篇论文的实验数据:一组测量顺式调控元件(CRE)扰动后的下游表达变化,另一组测量单个基因敲低后的转录变化。 智能体检查正文、MPRA耦合scCRISPRi补充表格,以及Perturb-seq差异表达汇总统计后,提出10种候选验证策略。人工研究者从中选择了表达变化特征的相关性分析,检验CRE扰动所产生的下游变化是否与某一基因敲低所产生的变化一致。 对于有敲低数据的5个最高排名候选基因,智能体在Rest、Stim8hr和Stim48hr三种培养条件下进行比较。只有GPR137敲低在刺激条件下与CRE扰动特征显著一致:Stim8hr下,Spearman相关系数为0.613,P = 3.79 × 10⁻³;Stim48hr下,相关系数为0.630,P = 4.71 × 10⁻³;假发现率均小于0.05。BAD及另外3个高排名候选基因在任何条件下都没有显著相关。 这些结果支持GPR137是该位点上银屑病的可能因果基因。不过,GPR137仅在刺激条件下显著,静息条件下的相关系数为0.29,P = 0.21,因此作者将其作用解释为依赖细胞激活状态。这一模式也与原Perturb-seq研究中不同刺激条件下调控作用存在差异的发现一致。 作者指出,将CRE扰动特征与基因敲低特征进行相关分析,是一种新的数据整合策略:它结合了两个互补数据集,而不是依赖单一读出;该跨筛选、跨模态流程并非由这两篇来源论文提出,可用于具有多个共同调控候选基因的GWAS位点。 补充说明中还介绍了另一个协作案例:连接AlphaGenome方法论文与儿童注意缺陷多动障碍(ADHD)的GWAS研究,优先筛选候选因果变异与机制,结果见扩展数据图2。作者将这些案例概括为一种协作方式:人类科学家设计AI共同科学家并参与制定高层科学假设,AI则执行和解释复杂分析任务。
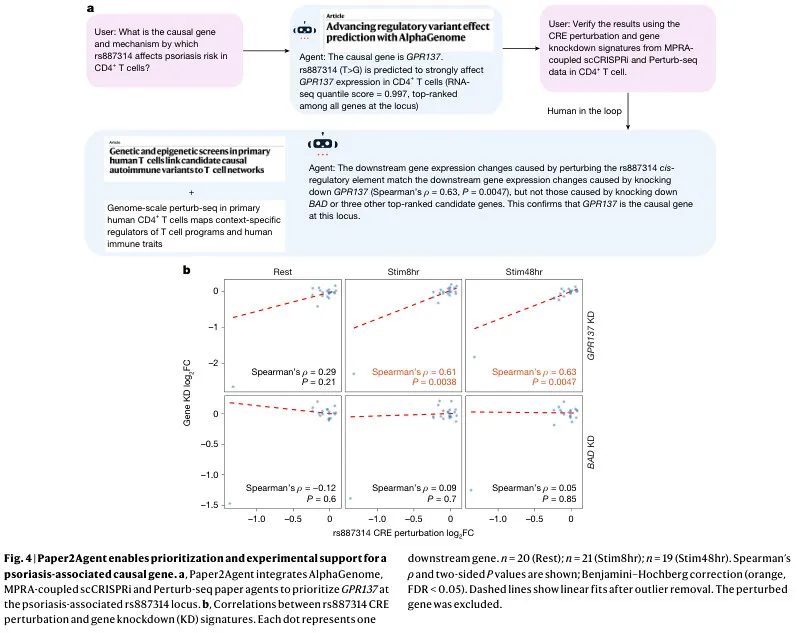
图4|为银屑病相关因果基因提供优先排序与实验支持。 a,整合AlphaGenome、MPRA耦合scCRISPRi及Perturb-seq论文智能体,在rs887314位点优先筛选GPR137。b,比较CRE扰动与基因敲低(KD)后的下游表达变化。每个点代表一个下游基因;Rest、Stim8hr、Stim48hr分别为n = 20、21、19。图中标注Spearman相关系数与双侧P值,橙色表示Benjamini–Hochberg校正后FDR < 0.05。虚线为移除离群值后的线性拟合;受扰动基因本身不纳入分析。 来源:Miao等,Nature,doi:10.1038/s41586-026-11044-y,PDF第8页。原图保留,中文图注据原文译述。 07 讨论 Discussion · 原文第7–8页 Paper2Agent将研究论文从被动出版物转化为可交互AI智能体,使论文的研究贡献能够通过自然语言直接访问。生成的论文MCP是可连接不同用户端智能体的模块化单元,有助于缩小科学发现的发表与实际应用之间的距离。更广泛地说,作者主张改变科学知识的表示和复用方式:论文不仅是静态文档,也可以成为面向智能体使用的研究对象。 但并非每篇论文都能顺利转化为稳健智能体。Paper2Agent的“执行—诊断—修复”迭代过程能够发现和纠正许多表现为运行失败的原有错误;然而,在大规模评估中,仍有相当一部分仓库因代码不完整、文档缺失或环境配置无法解决而未能完成转换。 作者认为,一篇论文能否容易地转化为智能体,本身可能成为衡量可复现性的实际指标。与清晰的数据和代码可用性要求类似,研究成果也可以进一步按适合智能体使用的形式组织。文档完善、透明的论文更容易满足这一要求。 开放式科学推理仍需人类参与,包括提出假设和解释机制。Paper2Agent可以生成假设、提出验证策略并规模化执行分析,但研究者仍负责选择方向与评价证据。作者因此将其定位为增强科学发现、提高论文可访问性、可复现性和复用性的工具,而不是自主或权威的科学结论来源。 对于开放式分析,多个答案都可能有合理依据。因此,与单一参考答案的一致程度,主要衡量的是执行是否忠实,而不应直接视为分析是否有效。评估一组可能成立的答案,对于检验AI在开放科学任务中的表现很重要。 展望未来,作者预期会出现类似数据与代码可用性声明的“智能体可用性”(agent availability)栏目,说明论文是否以及如何被实现为可交互智能体。相应的智能体研究材料,需要像代码仓库和示例notebook一样,由作者随论文共同发布和维护。 随着上游代码与依赖演化,论文智能体需要持续维护。作者认为,这是发布可执行研究成果的固有要求,而不是放弃智能体化的理由。将研究代码暴露为可执行智能体,也带来安全、知识产权和贡献归属等问题,需要妥善处理。 最后,当科学知识以主动智能体而非静态材料的形式存在时,其用途不只限于单个用户。智能体可以连接方法与数据,或组合不同领域的认识。作者认为,这样的智能体群体可能形成动态的科学智能层,促进跨领域联系与AI协作,使科学交流不仅描述研究结果,也提供体现并延伸这些研究的可交互协作实体。