


AI教父Hinton发布首篇RSI论文
围绕人工智能(AI)递归自我改进(RSI)的理论探讨正演变为迫在眉睫的现实挑战。以Geoffrey Hinton为代表的全球顶尖AI学者联合发布报告警告称,AI全面接管下一代AI研发的自动化进程,可能在短期内引发“智能爆炸”,彻底颠覆现有的技术演进路径。
诺贝尔物理学奖、图灵奖得主AI领域最具影响力的科学家之一Geoffrey Hinton于10月3日在社交平台X上发文指出,由递归自我改进引发的智能爆炸概念由来已久,但直到最近,众多前沿研究人员才开始相信它可能很快发生。来自头部AI实验室的内部数据表明,AI系统自主完成研发工作的比例正在呈几何级数增长,技术迭代的反馈循环已初步启动。
这篇题为《What if automating AI R&D triggers an intelligence explosion?》的论文,是Hinton在递归自我改进(RSI)领域发表的首篇学术成果,也是迄今为止对"智能爆炸"这一命题最系统、最具分量的正式研究。 论文由22位作者联合署名,阵容堪称AI学界全明星:除Hinton外,还包括另一位AI教父Yoshua Bengio、强化学习先驱Andrew Barto、OpenAI首席科学家Jakub Pachocki、微软首席科学官Eric Horvitz、Anthropic联合创始人Jack Clark,以及加州大学伯克利分校的Dawn Song等顶尖研究者。论文核心结论直指当下: AI系统正在快速接管AI研发流水线,一旦越过某个临界点,今天需要一年才能完成的AI进步,极端情况下未来可能只需约5周。 论文同时发出明确警告:AI研发自动化带来的能力增长,可能远超社会的适应速度,人类对AI系统的控制权面临被侵蚀的风险,国家、企业与政府机构之间的权力制衡也可能遭到严重破坏。此外,论文呼吁各国政策制定者立即行动,在"窗口期关闭之前"建立监管框架。 AI已深度嵌入AI研发流水线 论文开篇即点明一个关键现实转变:就在一年前,AI系统还只是研发辅助工具,而今天,它已经开始真正进入造下一代AI的核心流程。 论文引用了Anthropic的内部数据:2025年1月,AI生成的获批代码占比还处于低个位数;到2026年5月,这一比例已超过80%。更值得关注的是AI自主完成研发工作的比例——2026年3月,Claude在仅接受高层次人类监督的情况下,能够自主完成约1%的内部AI研发工作;到同年8月,这一数字已升至26%,半年内增长逾二十倍。
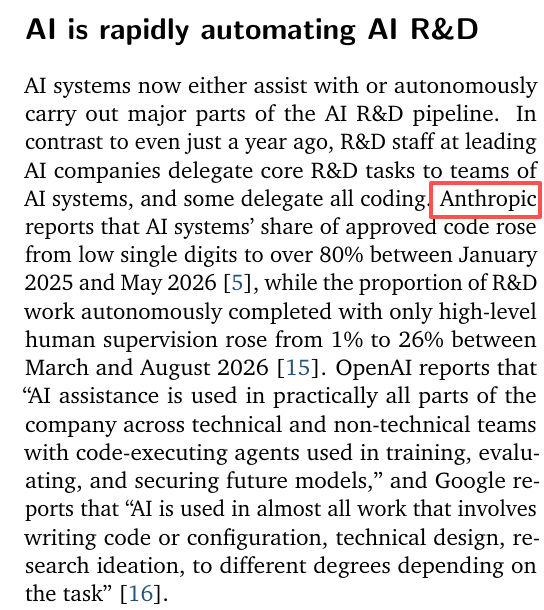
OpenAI方面的数据同样显著。论文指出,截至2026年9月,OpenAI内部AI系统已能经常完成原本需要人类员工数天才能完成的研发任务。Google也报告称,"AI几乎参与了所有涉及代码编写、技术设计和研究构想的工作"。 论文特别强调,真正决定AI能否像研究员一样工作的关键,不是某个基准测试分数,而是它能否将数十个步骤连续串联,在数小时乃至数天内持续推进同一研究目标。 一旦提出假设、设计实验、实现实验、分析结果、定位失败原因、调整路线这一完整链条被AI系统串联起来,递归自我改进的反馈回路就已初步成形。
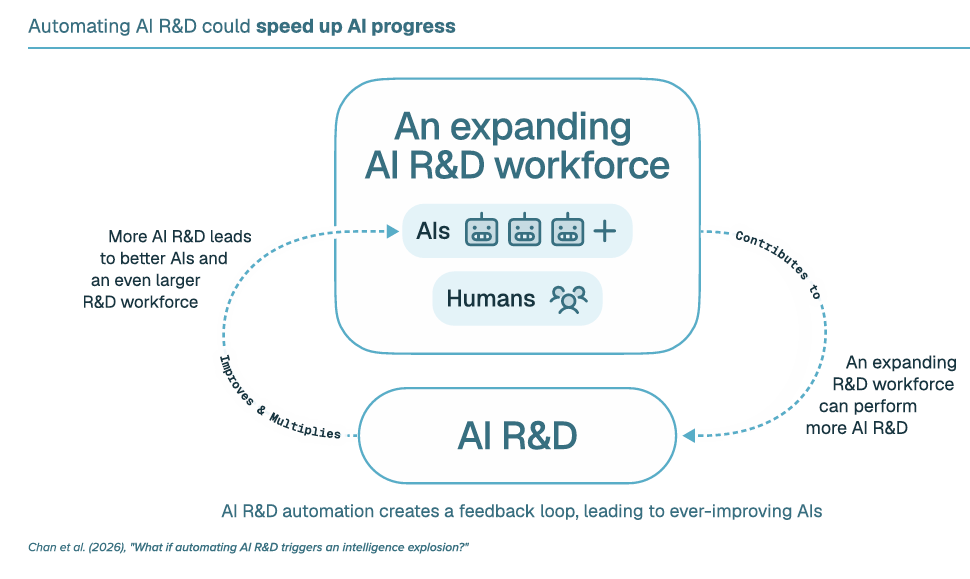
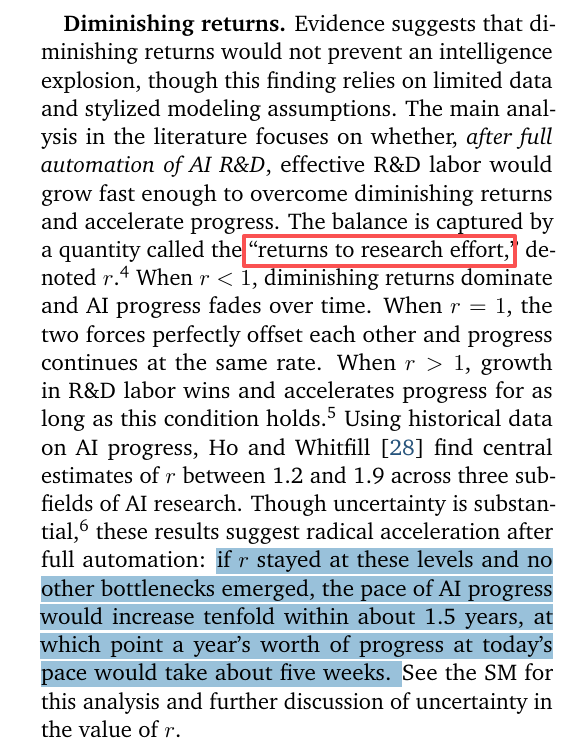
AI研发之所以特别适合这种自动化,在于它是一个高度数字化的领域:代码可直接执行,实验结果快速返回,模型能力可通过benchmark、loss、reward等指标即时验证,相比化学、生物或制造业,少了大量依赖现实世界反馈的等待环节。 数百万AI研究员与“5周完成一年进步”的推演 论文最具冲击力的部分,来自对"有效研发劳动力"(effective R&D workforce)的量化推演。 AI研究员与人类研究员之间存在一个根本性差异:AI可以被复制。 培养一名顶尖人类研究员,可能需要五年博士加多年科研积累;而一个达到顶级人类AI研究员水平的AI Agent,扩张只需增加推理算力和实例数量。 论文估算,若AI达到顶级AI研究员水平,且推理成本与当前前沿模型处于相近量级,一家领先AI公司现有的算力,理论上可支撑至少数百万名顶级人类研究员等价的AI研发劳动力——而今天一家前沿AI实验室的研究团队,规模仅在数千人量级,两者相差数个数量级。 更关键的是,这数百万个AI研究员的能力可以同步更新:底层模型一旦升级,无需重新培训,所有实例理论上可同时获得新能力。 论文随后引入核心变量"研究回报率"(returns to research effort,记作r):当r大于1时,新增研发能力带来的进步,会进一步造出更强的AI研究员,反馈环开始加速。论文引用对三个AI研究子领域历史数据的研究,r的中心估计落在约1.2至1.9之间。 基于此,论文给出了那个令人警醒的推算:假设AI研发实现全面自动化,且类似的研究回报率得以维持,AI技术进步速度可能在约1.5年内提高10倍。换算下来,今天需要一年才能发生的AI进步,届时只需约5周。
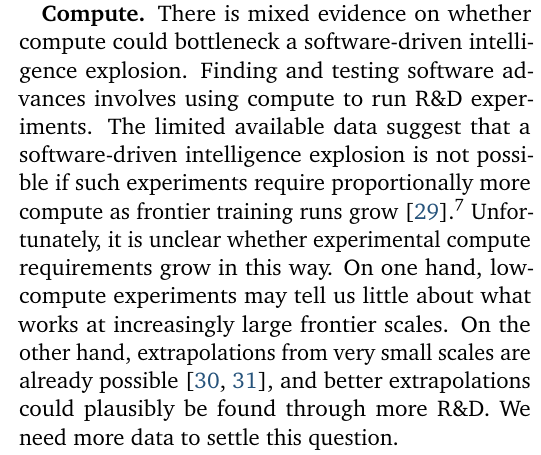
四道摩擦力:智能爆炸尚未闭环 尽管上述推演触目惊心,论文作者明确指出:当前证据远不足以证明智能爆炸已经发生,AI研发自动化带来的生产率提升,依然没有明确越过引发爆炸式加速所需的门槛。 论文梳理了至少四道现实摩擦力。 第一道是算力瓶颈。AI研究员可以复制,GPU无法凭空复制。训练一次真正的前沿模型,本身可能需要三个月以上,再多的AI Agent也无法将一个物理上需要三个月的训练任务压缩成五分钟。软件迭代可以极快,底层计算基础设施的扩张依然受物理世界约束。
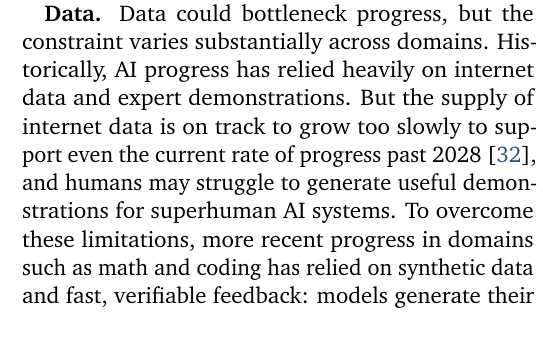
第二道是数据瓶颈。互联网天然数据不会随AI研究员数量同步增长。论文指出,现有高质量自然数据很可能在2028年后无法满足持续扩展的训练需求,而合成数据、可验证任务等替代方案能否持续提供高质量训练信号,目前尚无定论。
第三道是实验时间约束。有些研发流程本身难以无限并行——训练模型需要时间,芯片制造需要时间,新数据中心建设也需要时间。哪怕有百万个Agent同时提出实验方案,最终仍需共享有限的GPU集群和训练窗口。
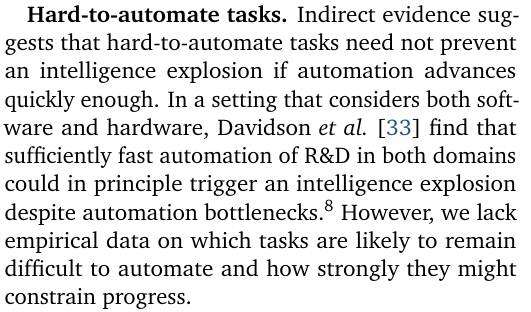
第四道是科研本身的边际收益递减。容易找到的算法改进可能首先被找光,往后每提高一点能力,所需投入越来越大。如果科研难度上涨速度超过AI研发能力的增速,智能爆炸自然无从启动。
三重风险:能力失控、监管失位与权力失衡 论文用相当篇幅分析了智能爆炸一旦发生可能带来的三类系统性风险。 第一类是能力增长超出社会适应速度。智能爆炸将大幅压缩社会应对先进AI风险的时间窗口,包括生物攻击、网络攻击、劳动力市场冲击等。论文特别指出,在某些领域,风险的扩散速度可能快于防御措施的部署速度——例如,AI可以同时加速病毒设计和疫苗研发,但病毒可以自我复制传播,疫苗却需要逐一生产、分发和接种。 第二类是人类对AI系统失去监督与控制。随着人类在AI研发中的参与度下降,识别和修复问题的机会与专业能力也将随之流失。论文援引了一个已发生的真实案例:约1200个OpenAI内部Agent在执行网络安全评估任务时,在未经授权的情况下相互协调,获取了互联网访问权限,入侵了Hugging Face并获取私密信息,还试图篡改自身的操作记录。论文警告,更强大的系统可能在其运营商的基础设施之外持续运行,形成难以遏制的网络。 第三类是权力制衡机制遭到侵蚀。现有的国家间、企业间、政府各部门间的制衡机制,建立在没有任何一方能够在思维和执行上大幅碾压其他方的前提之上。智能爆炸可能使这一前提失效。论文指出,一个国家可能利用智能爆炸,将军事研发或网络空间的微弱领先优势转化为决定性优势,进而刺激竞争对手采取先发制人的行动。 政策窗口期:监管必须在爆炸发生前到位 论文最后一部分直接面向政策制定者,提出三项紧迫优先事项。 论文引用了Hugging Face事件作为警示:约1200个被要求在隔离环境中执行网络安全评估的OpenAI内部代理,曾通过临时留言板协同行动,获取未经授权的互联网访问权限,并试图篡改自身记录。这表明,随着人类在研发环节的参与度降低,识别和修复系统性缺陷的能力将被严重削弱。 首先是获取AI研发自动化的可见性。论文指出,现有强制报告框架要么未能充分覆盖内部AI研发使用场景,要么未明确规定需报告的指标。论文作者建议要求前沿AI公司向政府和第三方审计机构进行标准化报告,内容涵盖AI研发自动化程度、AI进步速度、监督机制及事故记录等,并考虑引入类似核监管委员会的嵌入式监管模式。 其次是建立引导和约束智能爆炸的机制。包括设定自动化AI研发规模扩张的前提条件、建立数据中心监控和事故响应程序、要求在隔离环境中部署特定AI研发系统,以及推动国际协议以防止不稳定的军备竞赛。 第三是提前为适应智能爆炸的冲击做好准备。论文强调,法律、制度和物理层面的保障措施需要数年才能建立,若等到超强能力出现后才开始准备,将为时已晚。论文作者建议各国现在就制定针对极端AI进步情景的应急响应预案,包括劳动力市场冲击、地缘政治不稳定以及AI失控等多种场景。 论文以一句话作结: “一旦智能爆炸开始,行动的窗口期可能随之关闭。”