


从零开始:手撸大模型
IT技术小密圈 · 经八阕原文
从零开始手撸大模型:损失函数从哪里来?从最大似然理解 MSE 与交叉熵。
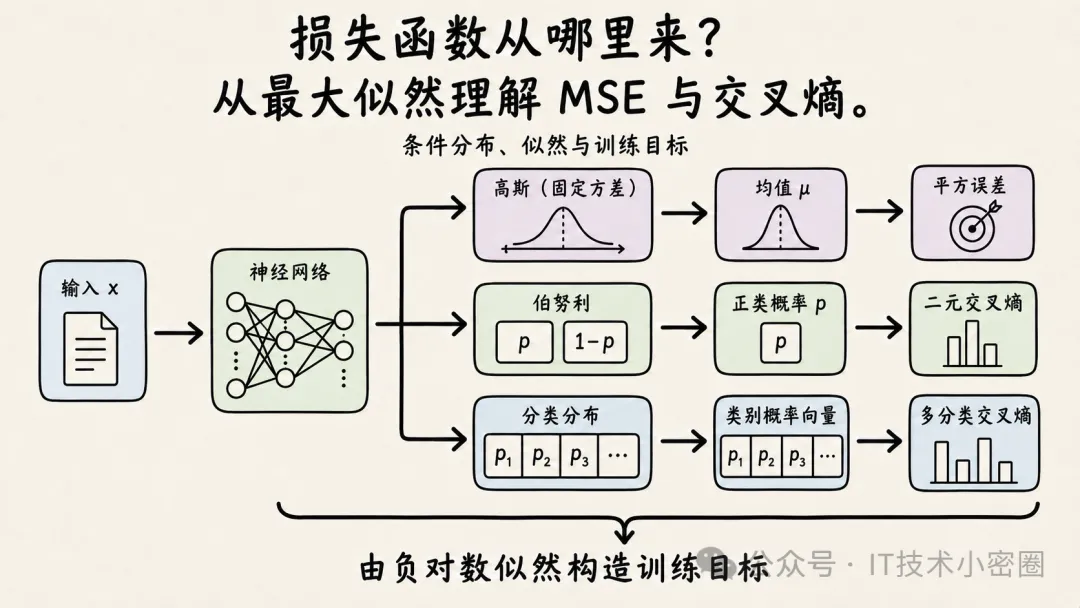
在监督学习中,神经网络定义输入到输出的映射,损失函数则定义如何评价这组输出。回归常用均方误差,分类常用交叉熵,但这些公式并不只是一组经验搭配:它们可以从不同的条件概率模型中推导出来。
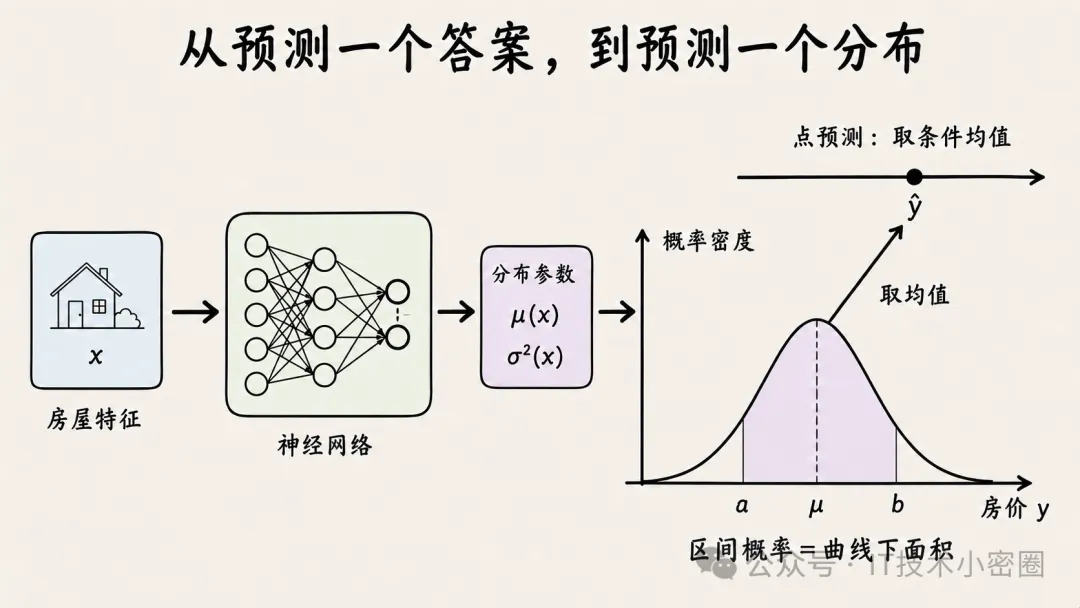
这条推导路径包含三个环节:为输出选择分布,让网络计算分布参数,再通过最大似然估计网络参数。分布不同,得到的负对数似然也不同。
下面讨论的是以负对数似然为训练目标的监督学习。它提供了一种系统的损失构造方法,但并不覆盖全部目标:当任务关心排序、间隔或特定决策代价时,也可能需要其他损失。
1. 从预测一个答案,到预测一个分布
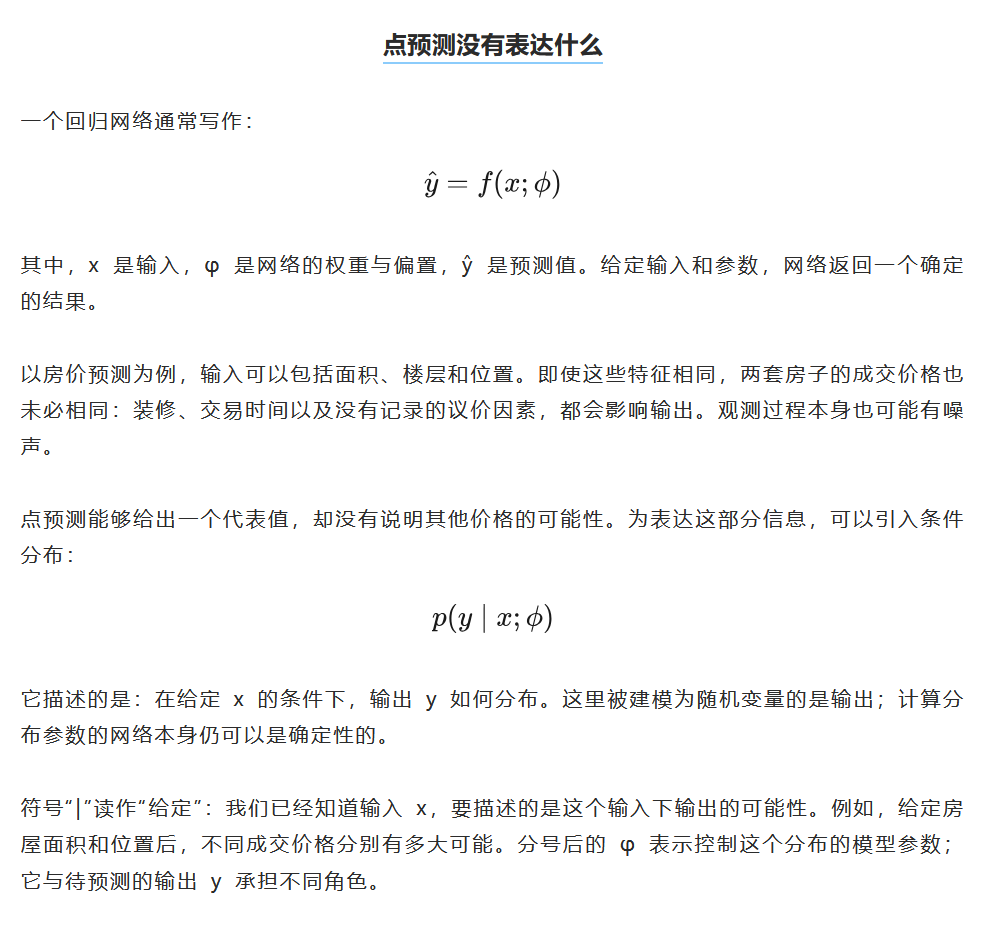
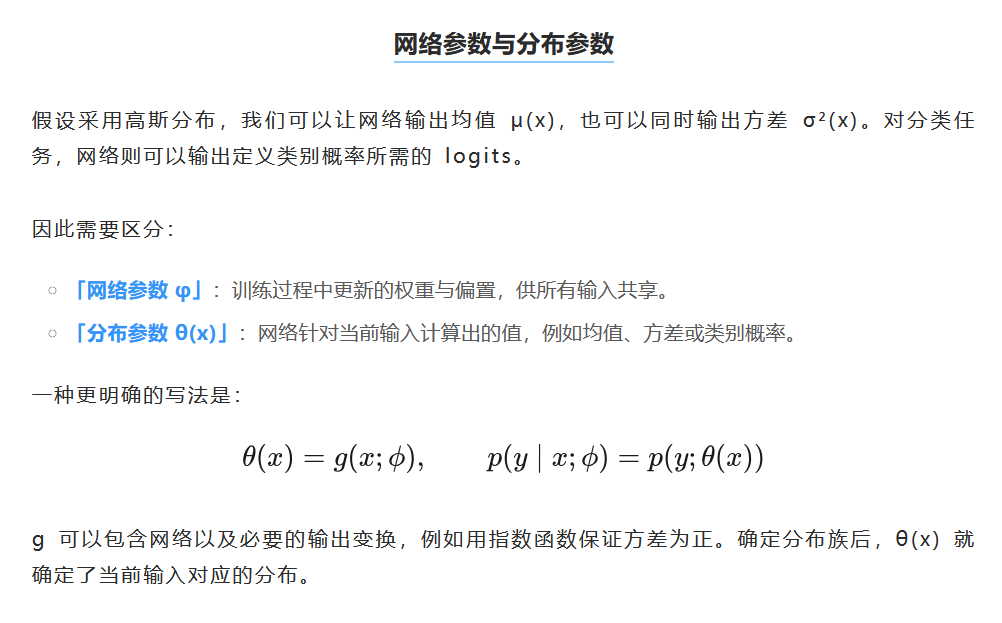
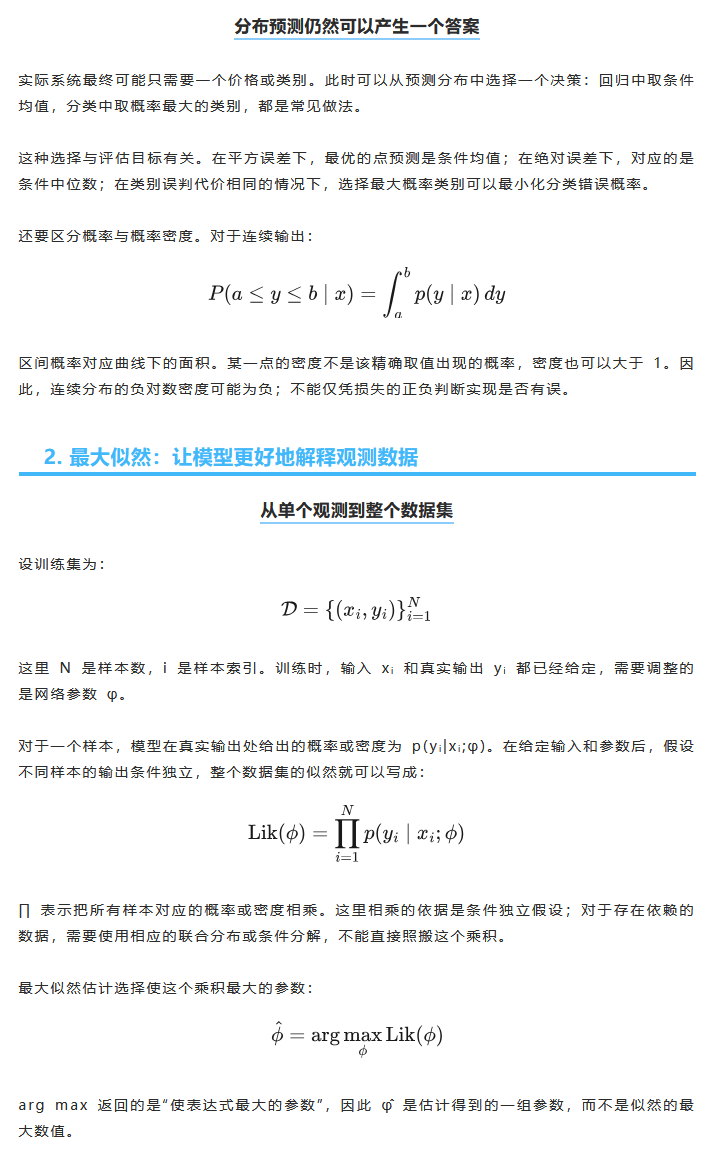
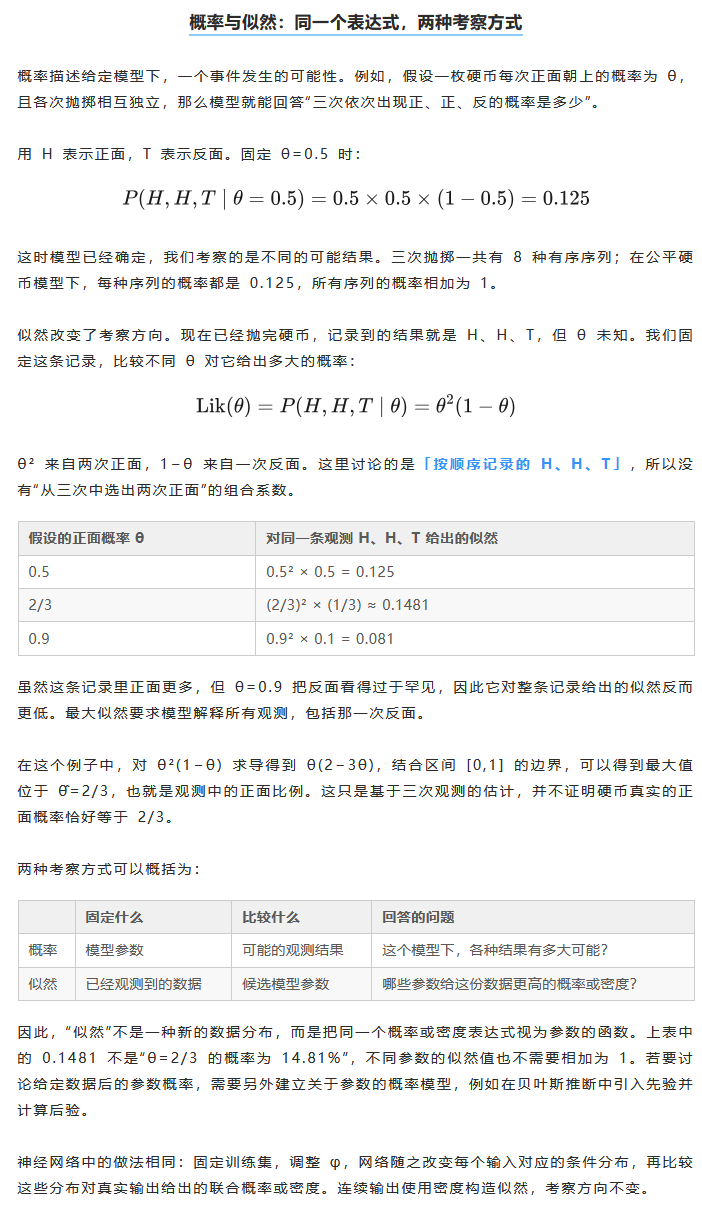
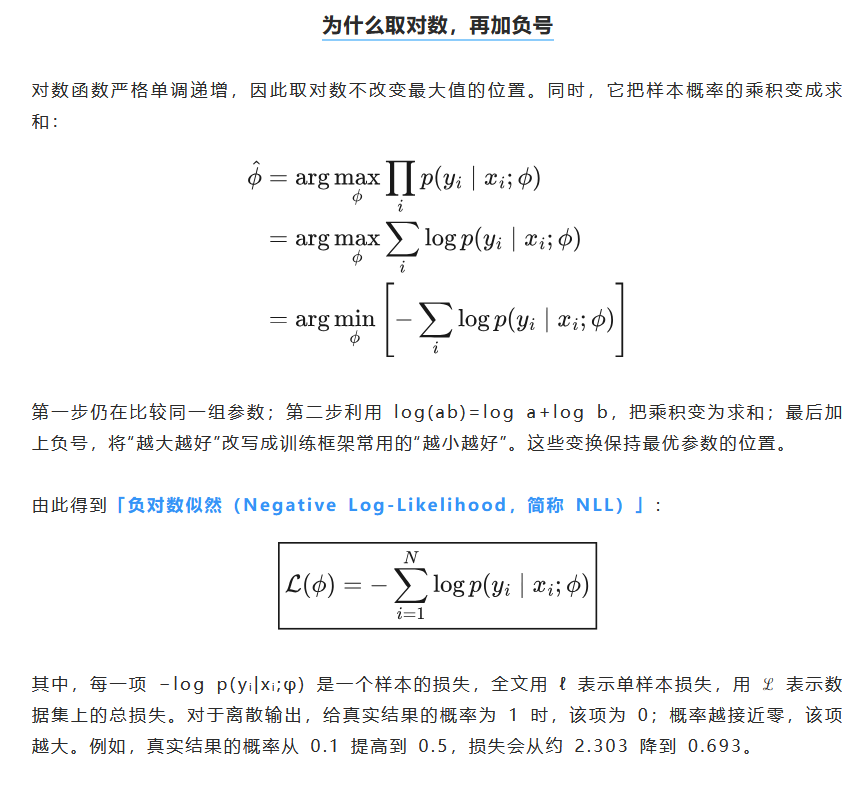
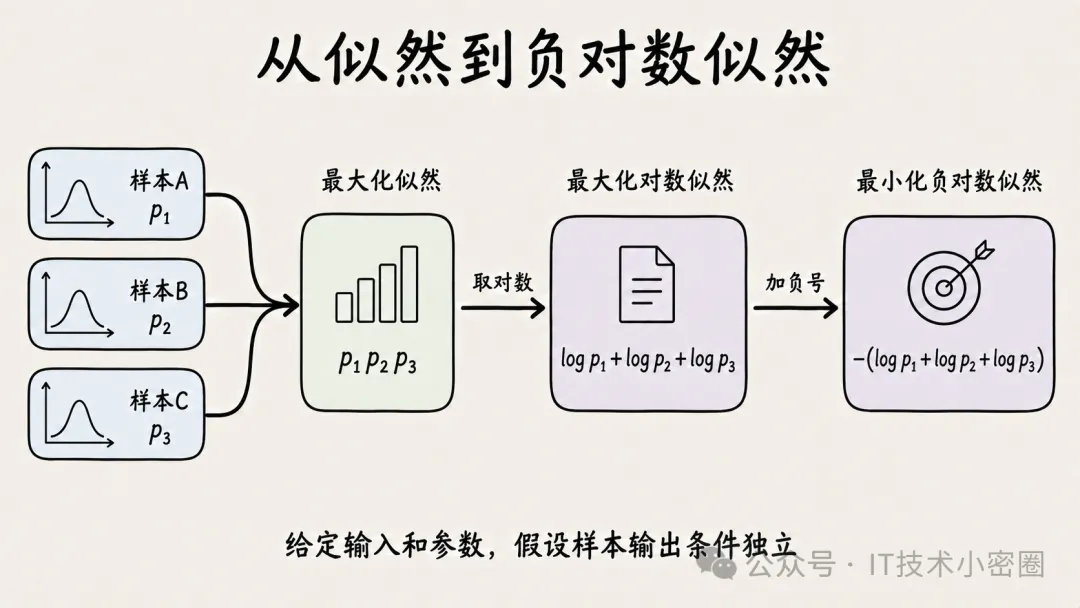
在实现中,应直接计算对数概率或其稳定等价形式,而不是先算一个可能下溢的乘积,再对乘积取对数。本文的 log 均指自然对数。
把总损失除以 N,会得到平均负对数似然。对于固定数据集、没有其他附加项的目标,求和与平均具有相同的最优解,但梯度相差 N 倍。若还包含固定权重的正则项,只缩放数据项就会改变两者的相对权重。
最后,最大化训练似然只规定如何拟合训练数据。它不能保证未知数据上的表现;模型复杂度、数据规模与正则化等因素仍然影响泛化。
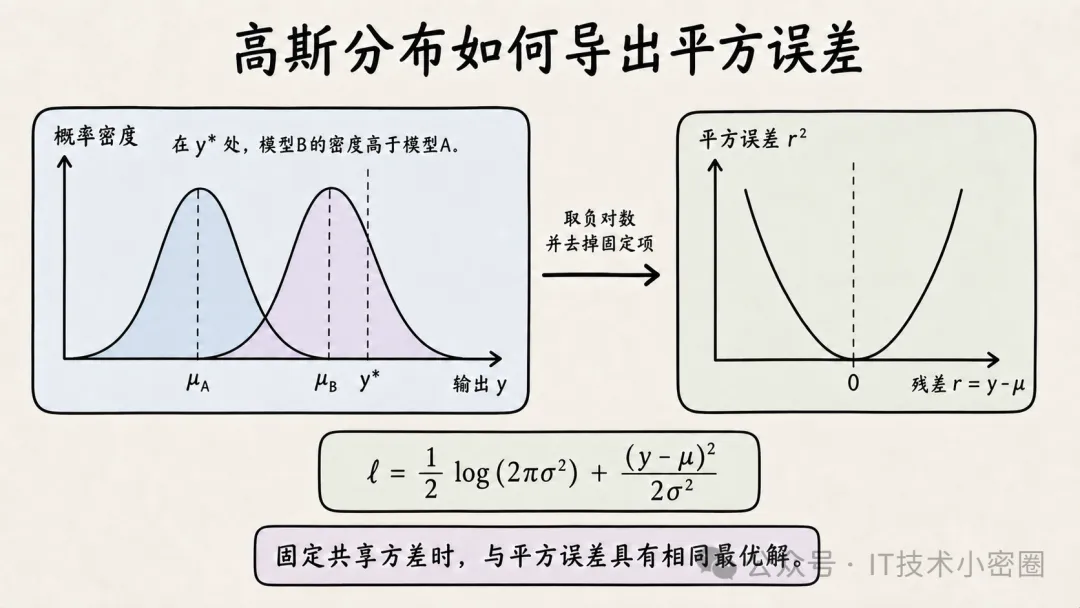
3. 回归:高斯分布如何导出平方误差
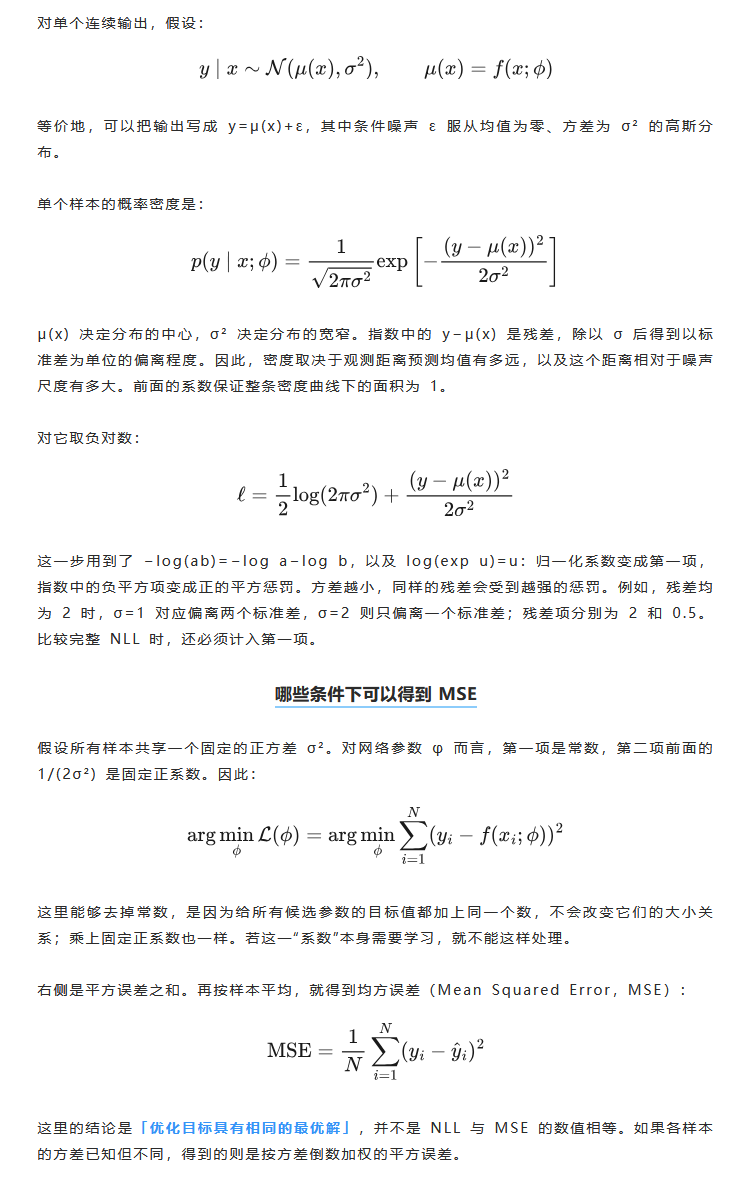
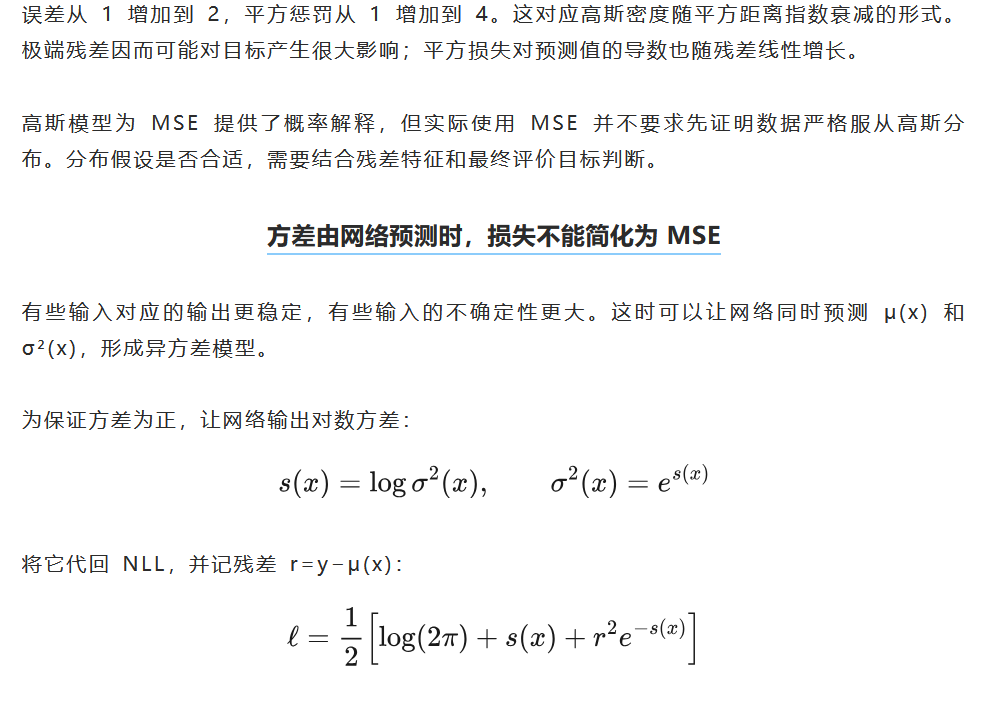
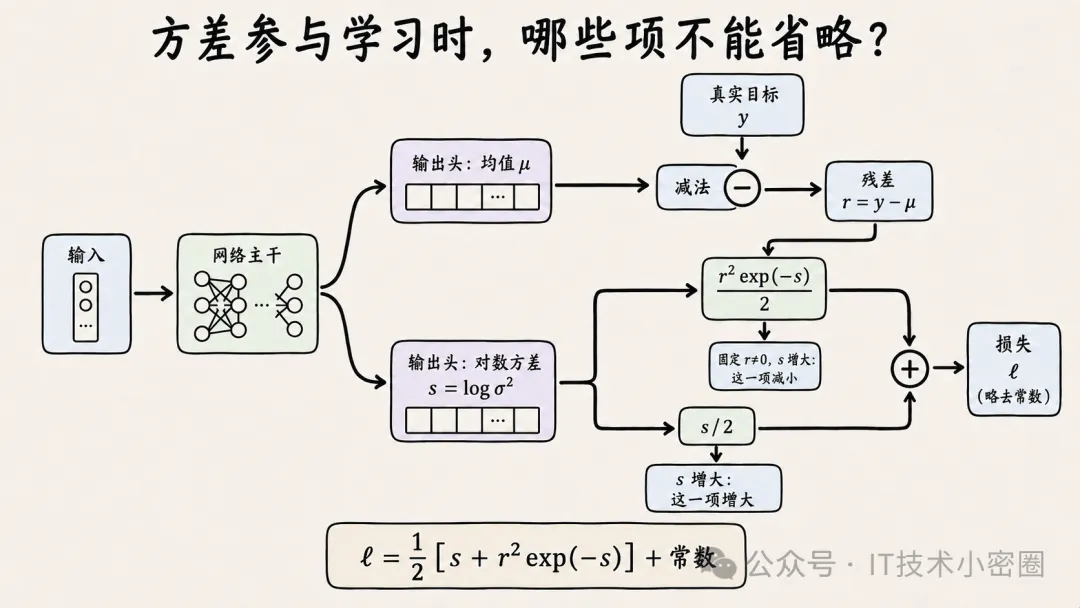
建立高斯观测模
来源:IT技术小密圈(经八阕转载) · 查看原文