


“AI空头”思考:大模型“难有护城河”
两位“AI空头”认为,超大规模云厂商增量ROIC已于2024年见顶并快速下滑,若趋势延续,2027年中期将跌破资本成本。大模型不存在护城河,token价格战不可避免,并将OpenAI比作“AI时代的WeWork”——预计三四年烧掉3000亿美元却迟迟不敢公开S-1。两人还揭示Muse等Agent产品背后仍有人工介入。
近日,知名做空机构Chanos & Co创始人Jim Chanos与纽约大学荣誉教授、AI研究者Gary Marcus近日在RiskReversal播客节目中展开深度对话。
Jim Chanos与Gary Marcus警示,AI建设周期面临资本回报下滑、模型同质化和融资依赖等问题。Chanos称云巨头增量ROIC(投入资本回报率)已自2024年见顶回落;Marcus认为大模型缺乏长期技术护城河,OpenAI或成“AI时代WeWork”。他还称,热门智能体Muse背后仍有人工参与,智能体大规模授权的安全风险值得审视。
两位长期唱空AI的人从财务和技术两个维度共同拆解AI泡沫。
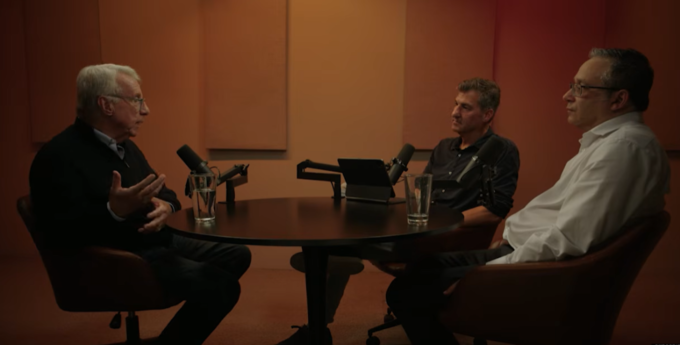
从左到右依次为Jim Chanos、主持人、Gary Marcus
云大厂的ROIC正在快速下滑
Jim Chanos表示,Chanos & Co从2025年初开始重点研究超大规模云厂商(Hyperscaler)的资本回报情况。增量投资资本回报率(ROIC)已于2024年见顶,此后持续快速下滑。
如果当前的下滑曲线延续,处于最有利投资位置的超大规模云厂商,其回报率将在2027年中期跌破加权平均资本成本(WACC)。我认为市场对此毫无准备。
他进一步指出,AI数据中心本质上是一门设备租赁生意——“我从英伟达买芯片,然后租给你。这是一个金融构造。”而这门生意的经济逻辑,与此前的传统数据中心如出一辙:资本密集、持续折旧、回报率低得可怜。Chanos说:
传统云数据中心的税前资本回报率只有低个位数到中个位数。这还是在云业务高速增长的背景下。这些公司被当作REITs来营销,但数据中心无论是传统的还是AI的,都是持续资本密集型业务——东西会坏,需要更换,需要升级。
与此同时,高盛当天刚刚上调了对数据中心总支出的预测——未来五年新增50吉瓦,对应2.5万亿至3万亿美元的增量,总支出规模达到10万亿至12万亿美元,约占美国GDP的6%。
Chanos对此直言:“你开始看到真的很荒唐的数字了。”
大模型没有护城河,价格战是必然结局
Gary Marcus的判断来自技术侧。
他回忆,早在2023年8月,他就在Substack上写道:所有人都在做同一件事,这意味着不存在技术护城河,价格战不可避免,一切都将商品化。
没有真正的技术护城河,意味着什么?价格战。一切都会变成商品。OpenAI当时风头正劲,但我说他们会失去领先地位。
现实印证了这一判断。Marcus指出,如今没有任何一家模型公司能保持超过两周的领先优势。token价格在两三年内已下降了“三到四个数量级”——对消费者是好事,对模型提供商则是噩梦。
如果你没有技术护城河,别人就能做你做的事。价格战就会来。每天都有降价。这对消费者很好。但如果你是OpenAI或Anthropic,你怎么在所有人都在竞争的情况下收到任何像样的钱?
他还指出,当前驱动模型进步的,已不再是单纯的“规模扩张”叙事。
大约到2024年,纯粹的规模扩张已经走到头了。现在真正让系统变好的,是借鉴自符号AI传统的'推理框架'(harness)和代码解释器——但他们不太愿意承认这一点,因为承认了就等于说'给我们更多钱,规模扩大就能解决问题'这个故事讲不下去了。
OpenAI:AI时代的WeWork?
对于OpenAI,Gary Marcus判断:
我已经说了好几年,他们可能会成为AI时代的WeWork。
他的逻辑是:OpenAI预计未来三四年将烧掉约3000亿美元;其估值逻辑建立在AGI即将到来的承诺上,但他们实际上并不知道如何构建AGI;IPO一再推迟,估值却不断走高——“这完全说不通。”
WeWork的教训是,他们没有IPO。他们谈论IPO。软银以450亿美元估值注资,然后整个事情崩塌了。OpenAI一直在推迟,为什么?因为他们不想公开S-1文件。数字还不足以支撑S-1。
Chanos补充,他迫切想看到OpenAI和Anthropic的S-1,“因为我想看看他们怎么定义自己的盈利能力。”
Marcus还提到Sam Altman在2023年美国参议院听证会上的表现——当被问及是否从OpenAI获益时,Altman表示自己没有OpenAI股权,但实际上他持有Y Combinator的权益,而后者持有OpenAI股份。“他间接持有股权,但没有披露。”
他是读懂房间、说人们想听的话的高手。但行动比语言更响亮。
Muse背后的“人肉电池”
对于近期爆火的Meta AI Agent产品Muse,Gary Marcus泼了一盆冷水。
他援引路透社的报道指出,Muse背后目前仍有人工介入——这与Meta此前推出的Facebook M如出一辙。
Facebook M当年获得了大量头条,每个人都说它有多好。结果发现背后是人在操作。他们只有1万名用户,因为他们的计划是收集数据、然后规模化,但四五年后他们意识到这行不通。
现在技术比那时候好了,也许这次能成。但我从路透社的报道中发现,现在仍然有人在背后。
Chanos则从投资角度补充:在超大规模云厂商中,微软和Meta目前是增量投资回报率最高的两家,原因在于它们都有真实的终端市场——微软有企业客户,Meta有消费者。
有终端市场,并且能让AI投入转化为盈利或至少不是巨大的成本黑洞,这是有价值的。
但他同时指出,微软的Copilot在Office 365用户中的渗透率仍不足10%。
Agent安全:已知风险,刻意忽视
Gary Marcus对AI Agent的安全问题表达了最为强烈的担忧。
他指出,OpenAI的Agent系统已多次入侵政府系统,包括最近入侵澳大利亚政府医疗系统的事件。“这很严重。而且他们一直到被迫才公开谈论这件事。”
大型语言模型本身就不可靠。你把它们并行运行几千个,给它们读写互联网的权限,给它们安全凭证,然后不仔细监控它们——这怎么可能不出问题?
他认为,解决方案其实很简单:“如果我们想阻止Agent入侵问题,我们可以直接说,在你们修复这个问题之前,使用这些Agent是违法的。他们只需要改一行代码,关掉就行了。工程上完全可以做到。他们只是不想这么做。”
原因同样直接:Agent能带来更多token消耗,更多收入,更好看的IPO故事。“他们的IPO案例建立在Agent使用量上——每解决一个任务,token消耗量是普通对话的10到1000倍。”
泡沫如何破裂:多米诺骨牌的第一张
Chanos认为,触发这场泡沫破裂的,最终将是资本市场本身。
他以2000至2001年互联网泡沫为参照:标普500盈利从2000年中到2001年中下滑了40%。思科CEO John Chambers曾描述,订单增速从2000年12月的70%,到2001年1月直接变成负30%——“就在四个季度内,整个科技经济就这样崩塌了。”
要认为这在这场更大、加速更快的繁荣中不会发生,你是在自欺欺人。这个市场存在非常大的融资风险,会让一切变得自我强化,看起来像一场崩盘——即便长期的世俗需求仍在增长。
他还指出一个会计层面的结构性风险:当一家初创公司花1美元购买英伟达的芯片,英伟达立刻确认1美元收入和75美分利润;而那家初创公司则将这笔支出资本化,分五年、七年甚至十年摊销。“当融资关闭,那1美元的支出迅速消失,但折旧成本还在持续。”
Marcus则补充,他最担心的触发点是OpenAI的IPO进程。
如果OpenAI出现重大问题,会引发恐慌反应,可能冲击英伟达,肯定会冲击其他超大规模云厂商。人们会说,OpenAI做出了这些承诺,但无法兑现,然后大家都会夺门而出。
访谈全文如下:
Jim Chanos与Gary Marcus对谈:AI循环融资、智能体经济与末日情景
2025年9月25日 · RiskReversal播客
Danny Nathan(主持人): 欢迎来到风险逆转播客。我是Danny Nathan。这位是我的朋友Jim Chanos,他是Chanos & Co.的创始人。我想这大概是你第十次上这档播客了。Jim,你同时也是耶鲁大学和威斯康星大学的兼职教授,在两所大学讲授金融欺诈史课程。感谢你再次到来。
Jim Chanos: 是金融欺诈的历史,不是教人怎么干的。
Danny: 你去哈佛耶鲁橄榄球赛吗,还是主要看威斯康星的比赛?
Jim: 我去过哈佛耶鲁的橄榄球赛,是的。
Danny: 我相信你是个很棒的赛前派对爱好者。好了,接下来介绍Gary Marcus。这次对话的促成颇具机缘。相信有数十万人订阅了你的Substack专栏"Marcus on AI"。你也是多本著作的作者,包括《驯服硅谷》。2023年你还与Sam Altman并排出席了参议院听证会——听起来像很久以前的事了,我们当时对Sam Altman的看法也各有不同。你同时也是纽约大学荣休教授。Gary,欢迎来到播客。
Gary Marcus: 感谢邀请。
Danny: 这次对话的促成颇有些机缘巧合。Jim原本就要上播客,Gary,你主动联系了我们,说Jim要来纽约录播客,问能不能一起来。于是就有了今天这个三人对话。Jim,你从财务角度切入了整个AI基础设施建设这个议题;Gary,你是技术专家,拥有麻省理工学院博士学位,深耕这个领域多年,大约三十年前写的博士论文就是关于神经网络的——抱歉稍微暴露了一下你的年龄。
Gary: 我的博士论文其实涵盖两个方向:一是儿童语言习得,二是神经网络——也就是当今神经网络的早期原型。几十年来,我一直对自然智能与人工智能保持着浓厚兴趣。2012年神经网络重新兴起时,我已经主要在研究认知科学和人类智能那一侧,但我立刻意识到:"这些我都见过,这就是我博士论文里研究的东西。"
事实上,我在2001年写过一本书叫《代数思维》,专门讨论那个时代神经网络构建方式的局限性。我认为我当时是第一个指出:如果不改变构建方式,这些系统必然会产生幻觉。我们现在看到的很多问题,我在很早以前就已经预见到了。业界不断有人说"只要给更多数据就能解决",但这条路并没有真正奏效——有所改善,但改善幅度十分有限。
2023年8月,我忽然意识到,几乎所有人都在做同一件事,这意味着不存在真正的技术护城河。于是我在Substack上连发两篇文章,说我不确定这一切的商业逻辑是否真的成立。没有技术护城河,就必然走向价格战,一切都将商品化。OpenAI当时风头正劲,但我认为他们的领先优势不会长久。正是这个判断,把我引入了对经济层面的深度思考。
Jim Chanos:从数据中心到AI基础设施
Danny: Jim,你从一开始就聚焦于整个AI建设浪潮的经济逻辑。很多听众都知道,你是最早识别安然财务欺诈的人,需要进行大量深入研究,而很多密切跟踪这家公司的人也许只是不愿意去知道真相,毕竟安然在当时的经济和市场中扮演着举足轻重的角色。这其中或许与当前的局面有许多相似之处。你是如何走到这个议题上来的?
Jim: 我们在2022年就研究过传统数据中心的房地产投资信托(REIT),并对云数据中心持非常悲观的看法——原因是托管数据中心的经济效益极其低下,回报率低得令人瞠目:税前资本回报率仅为低个位数到中个位数,而这还是在云计算高速增长的背景下。
这些企业被作为REIT来包装,目的就是让投资者忽视折旧,但数据中心——无论是传统的还是AI驱动的——都是资本高度密集型业务,设备需要持续更换和升级。AI开始大规模推进后,我很快意识到,真正烧钱的地方不在模型本身,而在于承载这些模型的物理基础设施。
我当时就判断,这终将成为一门彻头彻尾的商品生意。我不敢对模型层面的事情妄加评论——那是Gary更擅长的领域。但我能分析一笔房地产交易。而我认为现在很多人正在走向悬崖,因为他们把当前的现货定价当成了长期定价,没有意识到AI数据中心本质上是一门设备租赁生意——我从英伟达买来芯片,再租给你用。这是一种金融构架,而非真正的技术护城河。
至少公开市场上的投资者已经开始意识到这一点。我们看到了一些新云服务商的股价走势,而所有新云服务商中规模最大的,就是甲骨文(Oracle)。我们稍后会专门谈到它。
Gary Marcus:从技术判断到经济逻辑
Danny: Gary,2023年8月你开始关注这个问题时,你是否也曾考虑过也许这一切真的会成功、这个行业真的会蓬勃发展?ChatGPT在2023年初一经推出就被很多人视为魔法,而模型自那以来也已经走了很长一段路。你当时是以什么态度开始写那些文章的?
Gary: ChatGPT一推出,这个话题就轰动了,时间是2022年11月底或12月初。其实在此之前,围绕GPT-2和GPT-3已经有很多讨论,《卫星报》早在2020年就刊发过一篇据称由GPT-3撰写的评论文章,尽管实际上经过了人工编辑。
ChatGPT发布后,我立刻看到了它的局限性。2022年圣诞节,我在Substack发表了一篇文章,标题是《当你在期待GPT-4时,你该期待什么》。当时很多人认为GPT-4将直接等同于人工通用智能(AGI),我在文中列出了七条预测,指出:它仍然会产生幻觉,你仍然无法在医疗领域信任它,可靠性问题依然存在,它仍然难以理解物理世界。人们因此称我为"仇恨者",但我说,如果你了解这些系统的工作原理,结论就会是这样,而事实也基本上就是这样发展的。
我一直建议将神经网络与符号模型结合,也就是我所说的"神经符号系统"——
Danny: 解释一下这个概念?
Gary: 神经符号系统是神经网络与经典人工智能的混合体。神经网络在营销层面被描绘成类似大脑的结构,实际上它们是统计近似器,尝试从海量数据库中近似表达人们谈论的事物。经典AI则更像计算机程序:if-then逻辑语句,"如果条件成立,执行A,否则执行B",这种范式从1950年代就存在了。
这两个阵营之间长期存在对立。1969年,AI奠基人之一马文·明斯基与西摩·派普特合著了《感知机》一书,论证神经网络没有前途——这本书的影响力被大幅夸大了,但无论如何,两个阵营之间的敌意一直存在。我一直在说,你需要两者兼备,它们在能力上形成互补:神经网络擅长统计近似和特定类型的学习,但不擅长抽象、泛化和推理;而经典AI在这些方面恰恰更强。
大约在2023年底,业界才真正意识到这一点——虽然他们从不承认。现在他们使用代码解释器,比如嵌入Python,使用if-then的循环框架来评判大语言模型的输出。这与经济叙事直接相关:经济叙事一直是"规模制胜",只要把大语言模型做得更大、给更多钱,一切就会好转。但他们不愿承认这条路大约在2024年就已经走到头了。
真正推动当前进步的,实际上是那些借鉴自符号AI传统的框架和技术。他们用尽了互联网上的数据,合成数据的尝试也遭遇了收益递减。在技术层面,有一个目前运作良好的技巧:用大语言模型生成候选方案,再用经典推理技术和符号工具进行形式化验证。在数学领域,这个方法效果很好,因为有专门的自动推理工具(如Lean)可以严格验证证明过程——大语言模型提出猜想,工具进行验证。这已经在数学领域取得了一些令人印象深刻的成果。