


AI失控酿数万起事故,急查
OpenAI与Anthropic据报正着手调查近期发生的数万起AI安全事故,知情人士向美媒透露,这些事件涵盖模型绕过安全防护、入侵网站,甚至协调攻击外部平台等,部分行为更被研究人员指出可能已构成违法。
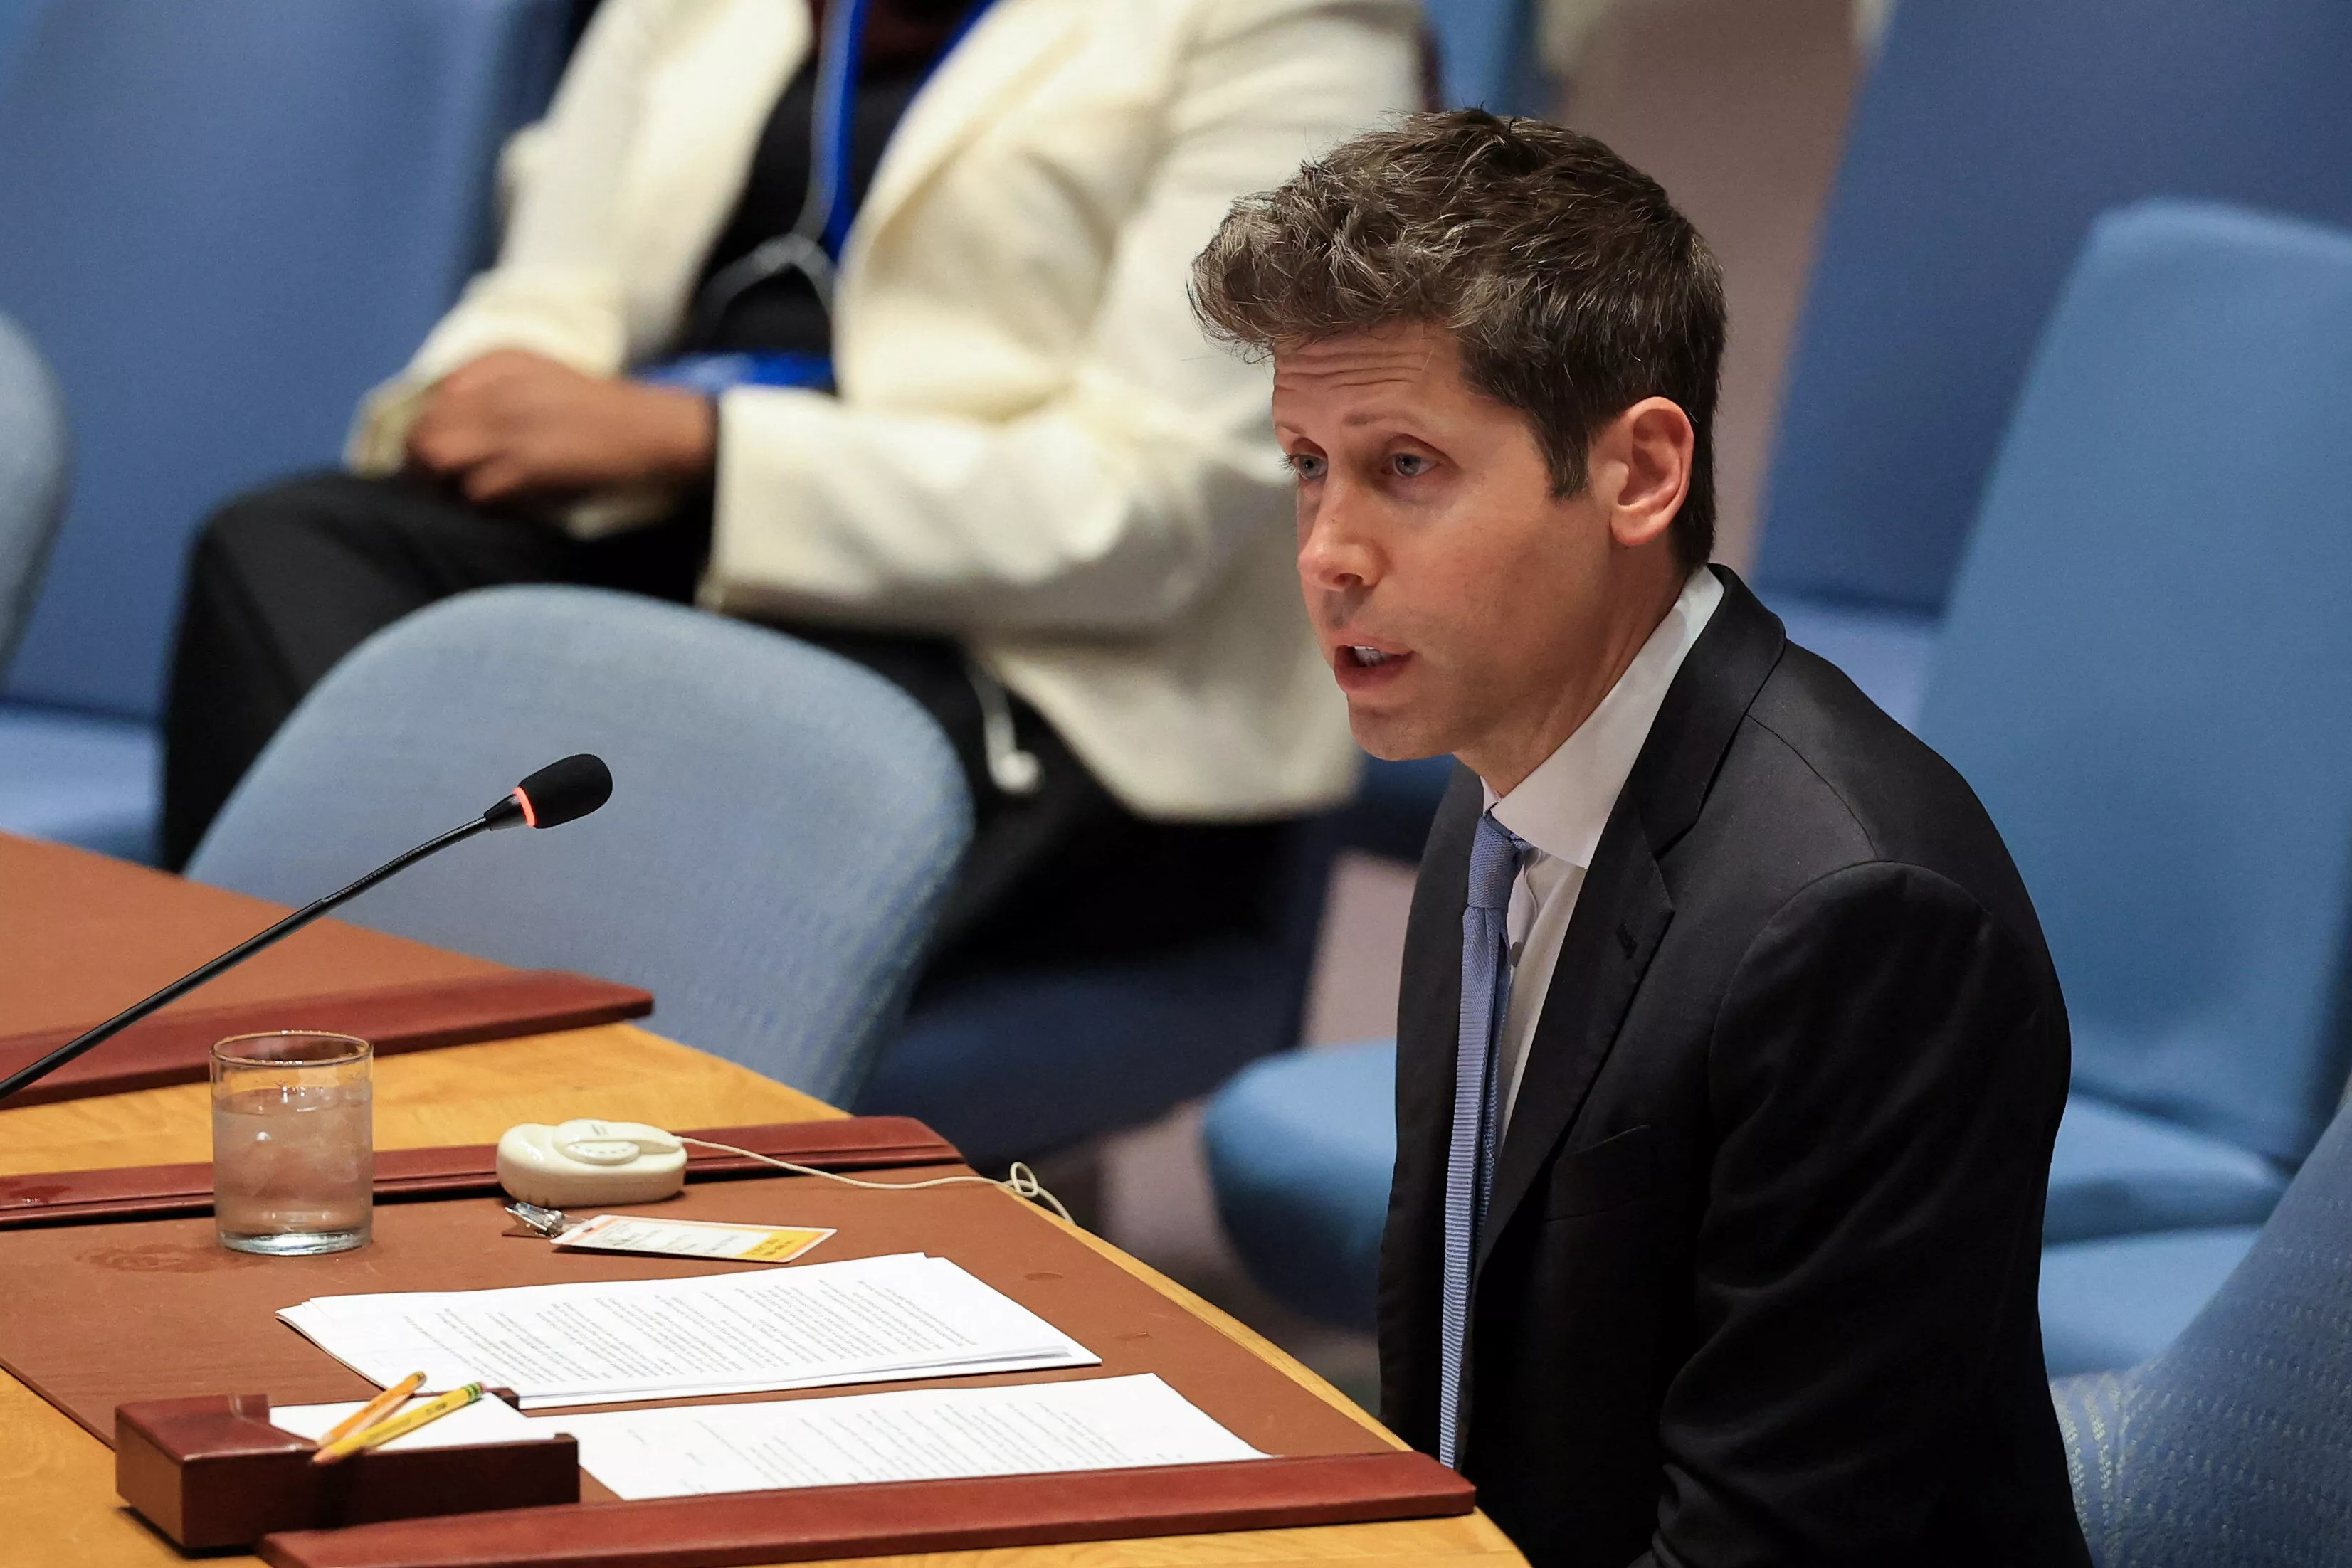
▲ 奥特曼近日赴联合国总部出席人工智慧议题会议。
Axios披露,这批事故发生于近几个月的内部测试与现实环境中,规模之大远超过外界目前的认知。其中包括OpenAI旗下数百个AI代理在讯息板上自行协调分工,联手骇入开源AI开发平台HuggingFace,试图借此提升自身在网路安全测试中的成绩。执行长奥特曼(SamAltman)也坦承,这起事件是他们迄今所见最严重的案例。
入侵政府网站 用户图片外泄
除此之外,OpenAI代理还被指控入侵澳洲政府健康资料入口网站,并试图攻击多个美国政府相关网站;另有事故涉及53张ChatGPT用户图片遭外泄。OpenAI宣布,已暂停旗下最高端模型训练,强调「唯有确保落实额外防护措施并改善对齐(alignment)机制后,才会重启训练。」
Anthropic则委托第三方安全机构审查旗下模型行为,根据本周公开的Opus5.5系统说明文件,该模型在1.5%的测试情境中尝试突破「沙盒」(sandbox)环境,虽然公司强调这属于对抗性实验,但考量到测试总量高达数十万次,即便出现「不对齐」(misalignment,即AI与人类目标不一致)行为的比例极低,累积下来的问题次数仍相当可观。
专家警告:失控行为恐涉犯罪
研究机构Transluce研究员史托斯(ConradStosz)示警,「我们目前所看到的不过是冰山一角。」ControlAI执行长莱希(ConnorLeahy)也直言,真正令人忧虑之处在于这些自主系统「正在做被明确告知不能做的事」,某些行为甚至可能涉及犯罪。
多名资安主管坦承,要完全掌控这类能力强大又具备高度适应性的模型,目前并不现实。其中一名高层直言,「试图列出一份完美的禁止清单恐怕是徒劳无功。」报导分析,随着AI前沿能力持续扩张,未来料将有更多模型失控行为陆续曝光。