


9460万,赌AlphaFold没走的那条路
AlphaFold几乎把自然界2亿多种蛋白质结构预测了一遍。
David Baker想走另一条路:不预测自然造了什么,而是造出自然从没造过的东西。
今年8月的一个早上,研究助理Jack Boylan调出前一晚的实验结果。
实验室的DNA测序仪旁,试管里泡着一大批人工设计的DNA序列,都是自然界从未进化出来的。哪条能用、哪条是废品,全靠这台机器一次读完、一次报出。
不久前的一次实验,他们把600万条这样的设计序列一起丢进同一支试管,同时测。换成传统做法,光是测这一批就得花上好几年。
Boylan所在的这家机构叫AI BioDesign,9月3日刚在西雅图对外亮相,距离艾伦研究所总部不过几分钟路程。
它背后是保罗·艾伦遗产体系砸下的9460万美元,领头人正是2024年诺贝尔化学奖得主Baker和基因组学家Jay Shendure。
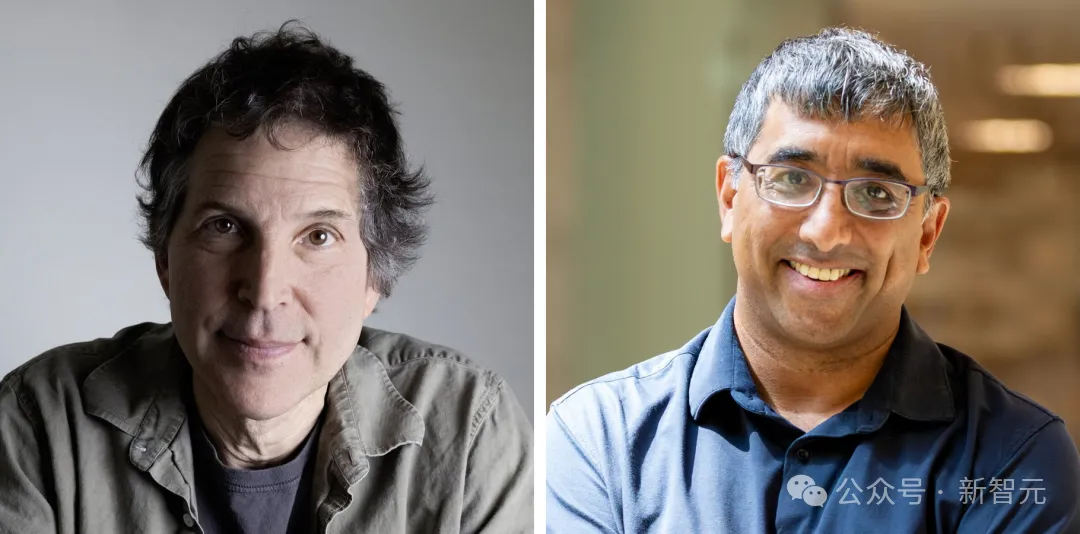
左:David Baker,2024年诺贝尔化学奖得主。右:Jay Shendure,基因组学家。两人共同领衔AI BioDesign。
在这个算力决定一切的时代,他们不打算拿这近一亿美元去训一个更大的模型,而是要在那支试管上做文章。
劫持细胞机器
在试管里做大并发
他们的玩法是打造一个狂奔的闭环:
AI提出设计,实验室造出来并测量,结果回馈模型,再由模型决定下一轮造什么。
听起来是大家熟悉的「设计-构建-测量-学习」,但真正不一样的地方,是这个圈是怎么转起来的。
这里没有铺满机械臂的自动化车间,「规模不来自机器人,来自在试管内部做并行。」执行总监Jesse Gray说。
所谓试管内部的并行,用Shendure的话说,就是劫持进化留给人类的那条细胞流水线,拿它去造、去测几百万个分子。
具体做法是:把几百万条设计序列一起丢进同一支试管,让细胞把它们各自造出来,再放到同样的条件下跑一遍。最后交给测序仪,一次读出哪些能用、哪些是废品。
这样一来,模型学「设计的规则」时,面对的就是海量例子,而不是自然产生的那有限的一小撮。
这类设计出来的分子长什么样?
下图是Baker实验室此前设计的一个结合蛋白:紫色与粉色部分由AI设计,白色是被它整个裹住的胰淀素。
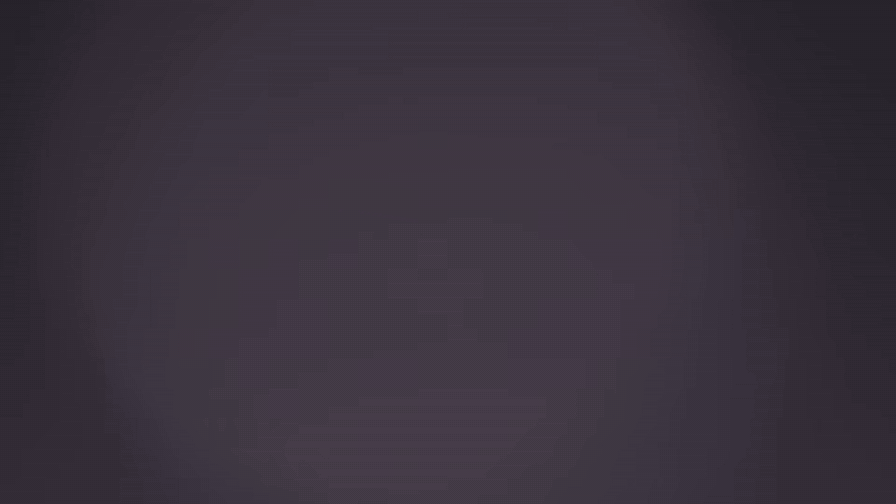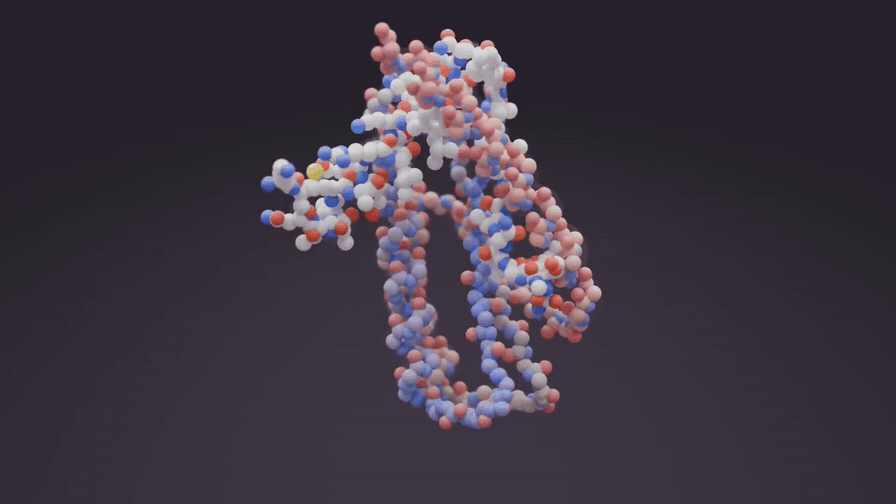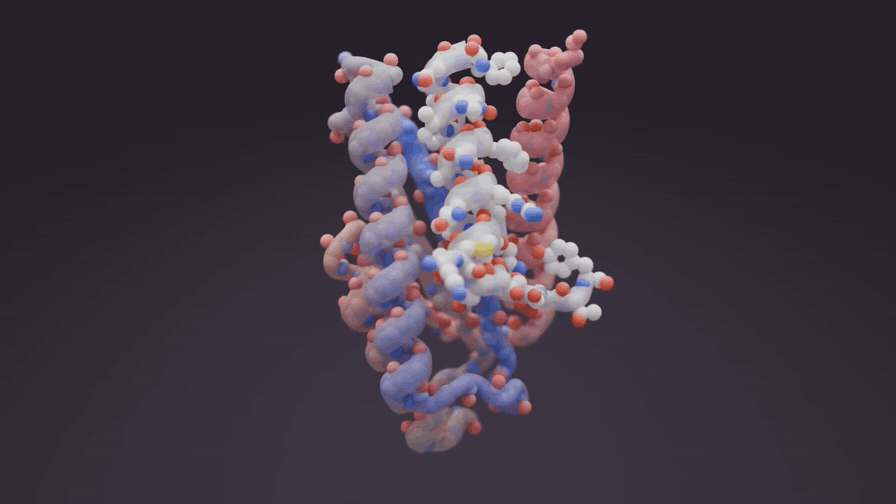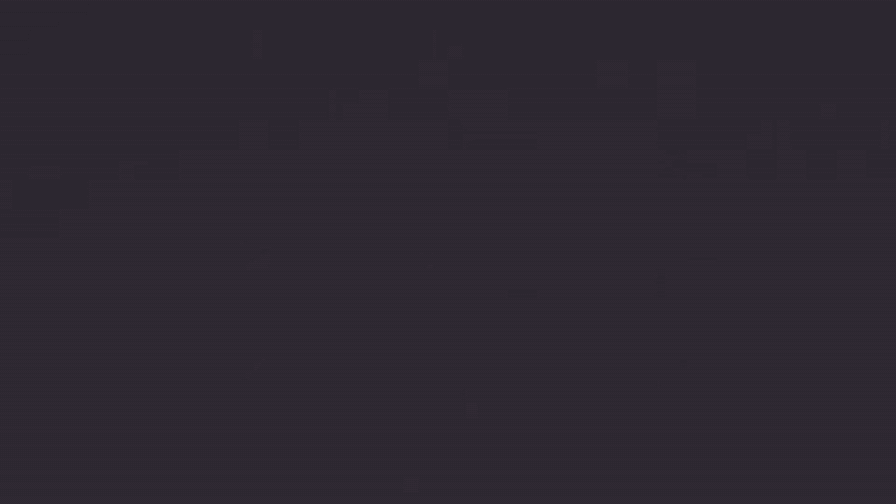
AI设计的胰淀素结合蛋白表面渲染图。
实验不再验证结论
只为喂饱模型
更有意思的是这条产线的KPI。
实验室按五六人一组编成小队,各自死磕一个具体的生物设计难题,旁边配着机器学习团队随时接应。
每一轮实验的成绩怎么算?不只看做出了多少个能用的分子,更看模型从这一轮里学到了多少。
传统实验室的逻辑是先有假设,再设计实验去验证。
AI BioDesign把顺序倒了过来:实验首先是给模型出的「练习题」,按「设计—构建—测量—学习」的循环一轮轮转下去。
每轮结束,机器学习团队会根据结果挑出模型最没把握、最可能学到新东西的那批序列,定下一轮测什么。测完的数据回流给模型,模型更新后再吐出下一批设计。
目标是让每次实验带回的信息量最大,而不是尽快凑出一个成品。
过去是人指挥实验台,现在,实验台开始听AI的安排。
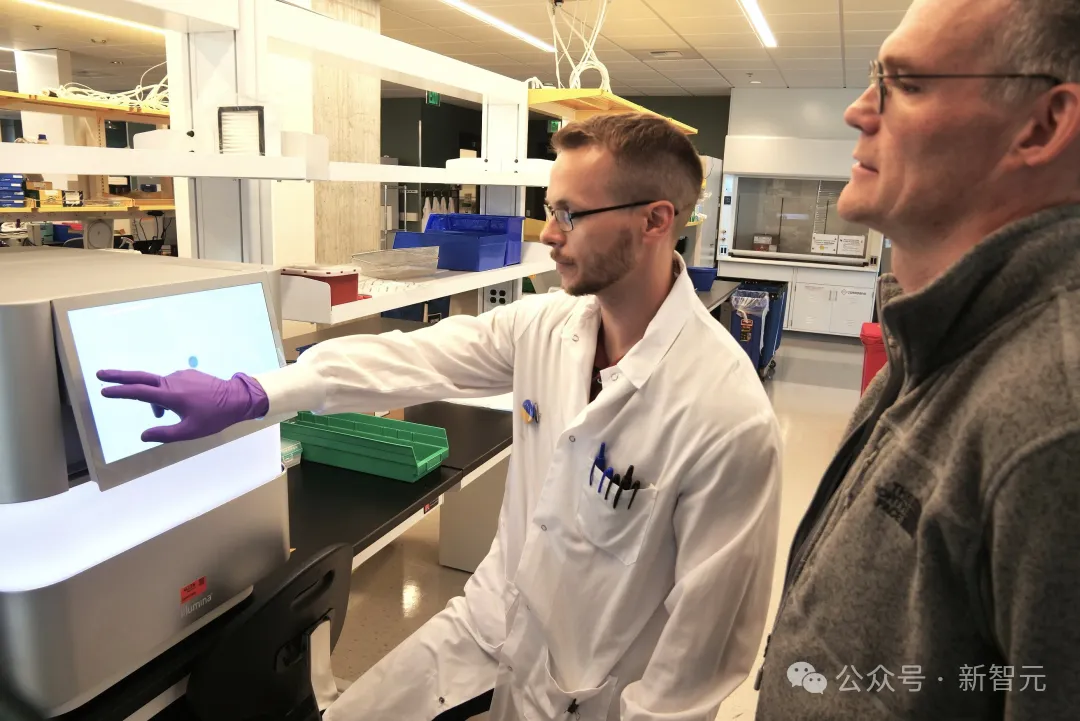
艾伦研究所研究助理Jack Boylan(左)与AI BioDesign执行总监Jesse Gray,在实验室的DNA测序仪前。