


曙光8000,中国智能时代的王炸
2022年12月,ChatGPT的横空出世点燃了AI时代的烽火,人们一下发现,机器似乎真的拥有了智能。
「ChatGPT时刻」就成了智能起点的代名词。然而这个算法,漏掉了一台中国的机器。
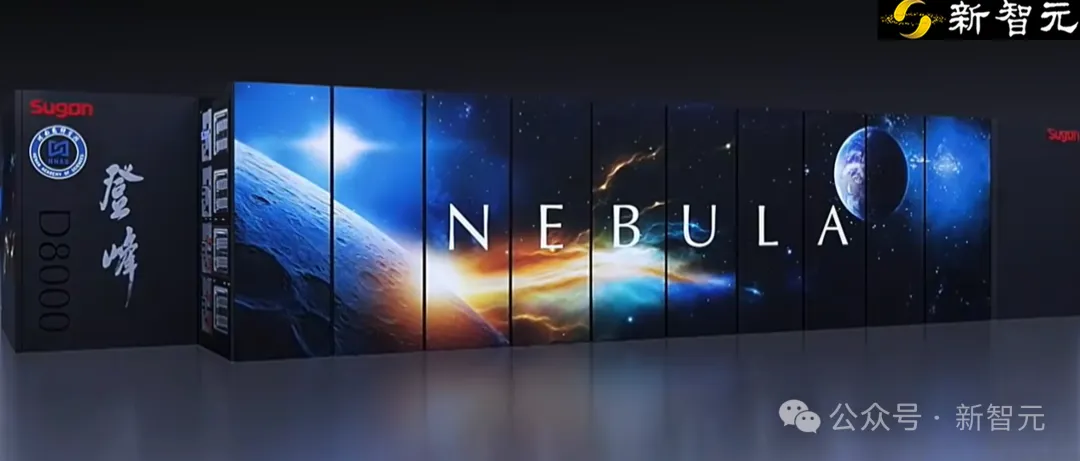
曙光8000。
近日,央视大型纪录片《超级工程》再度回归,这一次中国算力基础设施走向台前。
纪录片复盘了首个全国产十万卡AI超集群曙光8000(登峰)从技术路线选择、关键技术攻关到工程交付、科研应用的全过程。
2021年底,曙光8000立项时,人工智能还处在「小模型时代」。
受限于算力(GPU尚未普及)、数据规模和算法架构,模型参数通常在百万级甚至更低。
它们主要执行的是判别式任务——比如人脸识别、语音唤醒词识别,基本不具备生成和理解复杂语义的能力。
当时几乎没人想到,智能时代很快会需要一台「超级机器」。
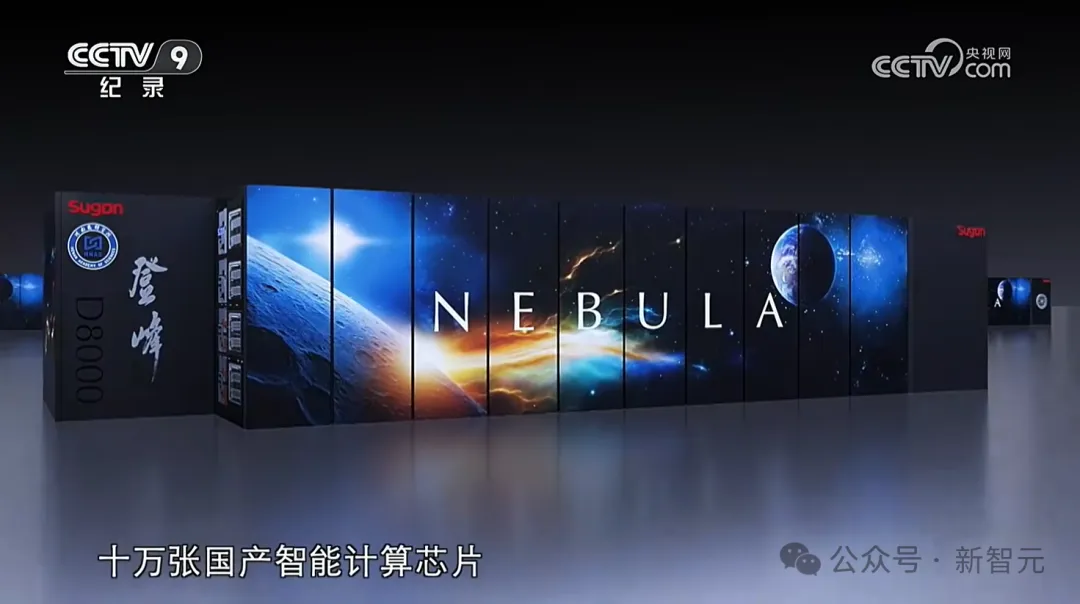
中科曙光团队却果断决策,花5年时间,用10万张国产智能计算芯片,建一台既能做高精度科学计算,又能训练AI大模型的AI超集群。
两年后,大模型引发的智能海啸席卷全球。
在无人区里押中一条路
曙光8000的第一个难题,不是怎么造,而是决定要造一台什么样的机器。
超集群的研制周期很长,方案落定时似乎看的是当下,真正建成时却要赌几年后的技术环境与市场需求。选早了,技术可能还不成熟;选晚了,机器落地就会过时。
曙光8000正式立项时,主流AI仍以「小模型」为主,传统高性能计算最擅长的是依靠数学模型进行高精度计算,而智能计算则追求更高数据吞吐的低精度算力。两条路原本各有自己的系统,混合计算往往意味着跨平台调度和频繁搬运数据。
时任中科曙光总裁的历军预判,等机器建成时「数学的方法和数据的方法同等重要」,也就是既要算得准,也要算得快。中科曙光因此提出超智融合路线,让高精度科学计算和低精度智能计算运行在同一套系统里,从FP64到INT8覆盖多种计算精度。
这个决定并不轻松。
因为,方向一旦确定,技术路线很难中途更改。团队用了至少一年,反复与业界专家、科学家和产业伙伴沟通,最终超智融合这条技术路线被确定下来。
但很快,这个需要反复解释的判断,开始显出独特战略价值。
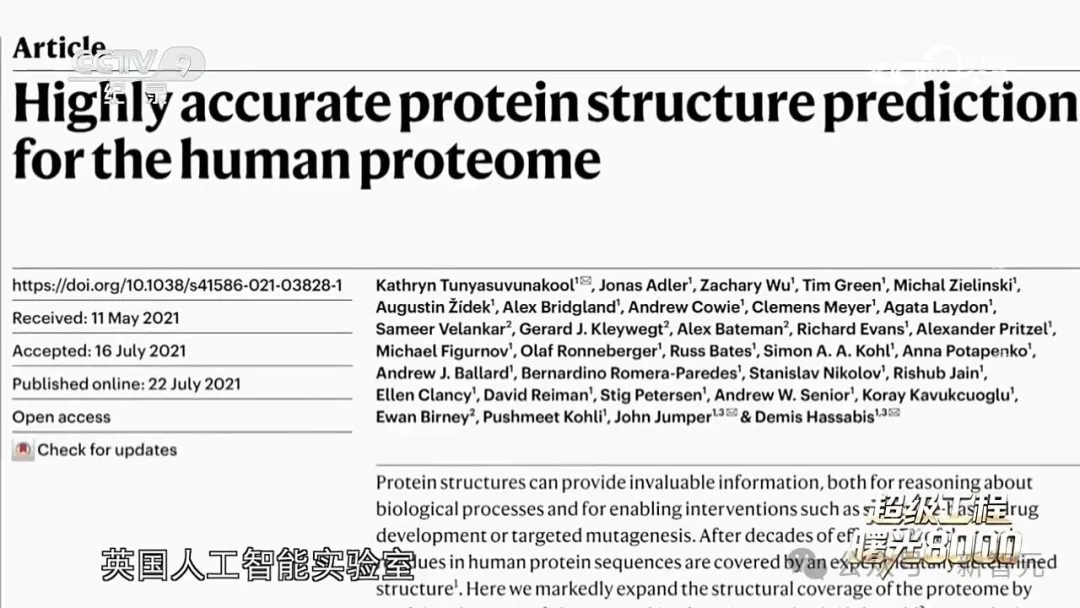
2021年,破解蛋白质折叠难题的重磅论文登上《自然》;紧接着,ChatGPT正式发布,震撼全球。由此,人们第一次看清,支撑这场智能革命的,不再是传统的数学推演,而是由超级算力托举的全新智能计算方法。
如今,当世界模型、物理AI、多模态、AI for Science等更加复杂的应用场景成为趋势,未来的算力标准恰恰是「算得准」与「算得快」兼得——训练推理需要低精度算力的吞吐,科学验证、模拟物理世界又离不开高精度计算的可靠。
凭借超智融合路线的精准「押注」,曙光8000把从FP64到INT8的全精度计算放进同一套系统,一台机器,既能模拟气候变化、探索生命密码,也能训练大模型。
十万卡背后,每一道坎都要自己过
路线正确只是开始。要把图纸上的超智融合变成一台可以稳定运行的机器,团队面对的是一整套放大后的难题。
从曙光7000的6万卡跨向10万卡,多出来的绝非只是芯片数量。曙光8000工程难度在于,横跨60多个细分学科、800多道工业工序,全流程管控参数数以亿计。
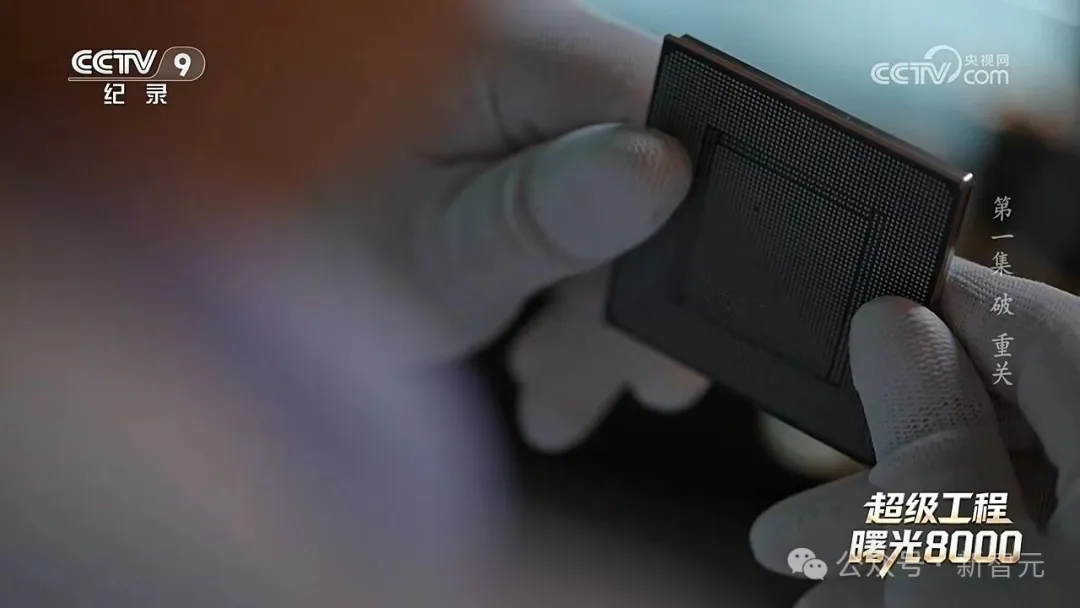
节点之间的网络传输要达到每秒800G,数据读写时间要压到0.202毫秒,10万张芯片运行一小时产生的热量,约等于12吨标准煤燃烧的放热量。计算、网络、存储、供电、散热,任何一环跟不上,整台机器都会等待。
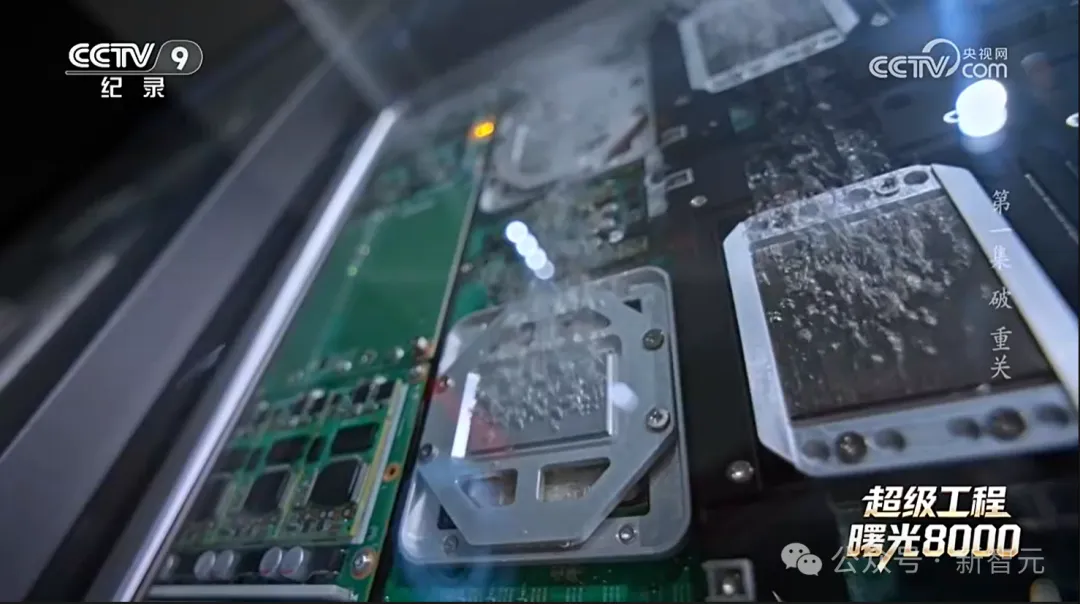
更棘手的是,一些关键环节在国内没有现成答案。
为了8颗智算芯片的高速互联,系统需要一枚能够高效汇聚和调度数据的交换芯片。当时国内在这一领域还是空白。不把它做出来,全栈自研就会卡在最核心的数据交换处。
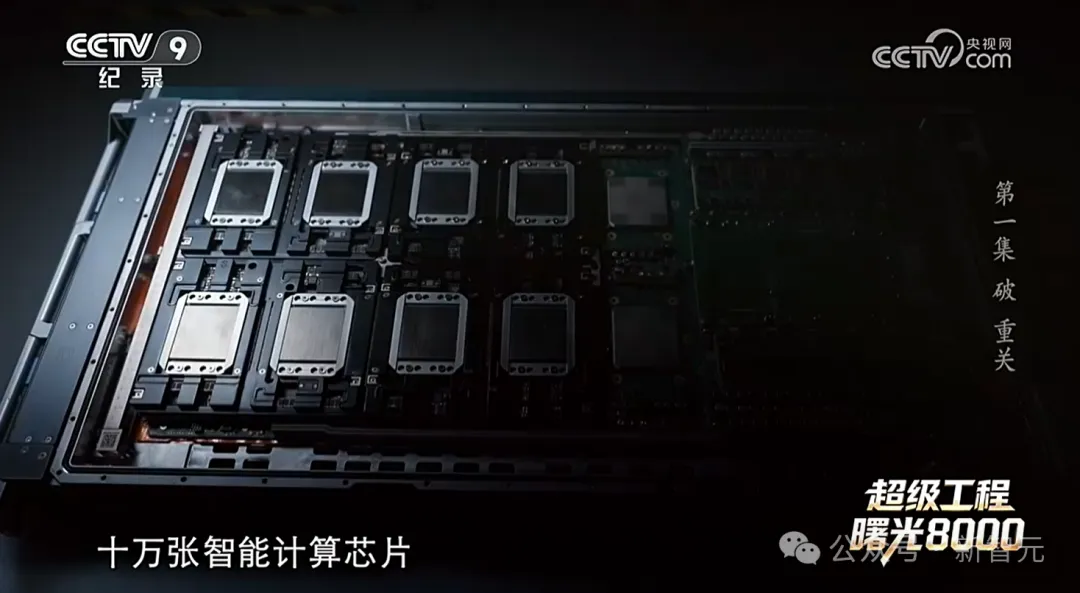
团队只能继续往下拆。从芯片、计算系统、存储、高速网络到液冷散热,把每个薄弱环节逐个补上。
规模越大,小概率故障越会成为日常。曙光8000的网络团队,在交换芯片里设计了可自主避险的「智能开关」,一旦链路发生故障,信号可以在毫秒级切换到备用路径,不必等待中央调度。存储和散热团队也在同时解决自己的极限问题。
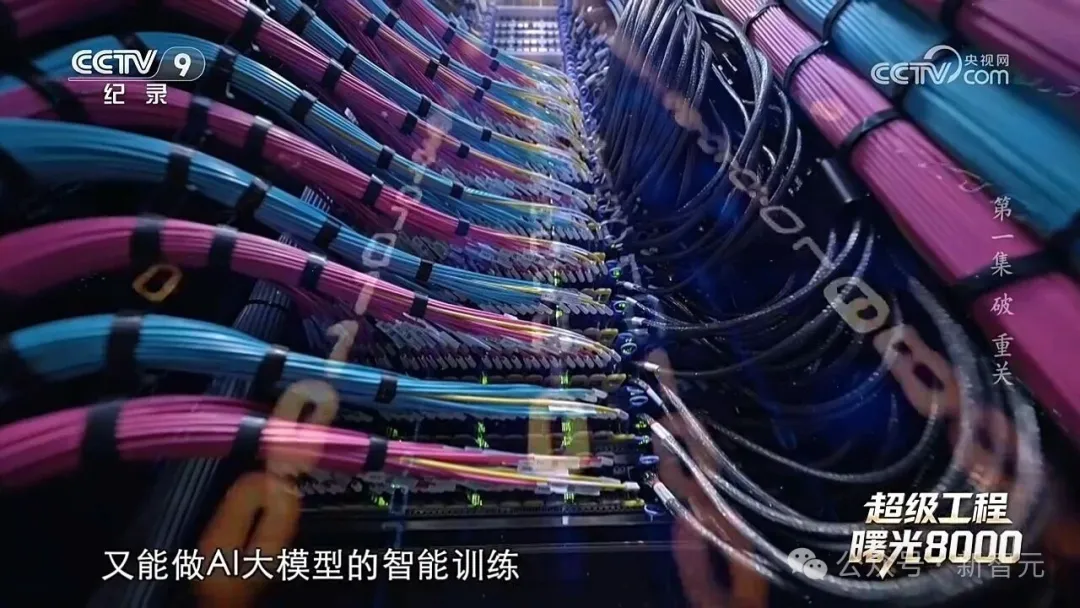
最终,整套系统覆盖「芯片、计算、存储、网络、散热、应用、服务」全链路,主要核心技术全面实现了国产化。