


谷歌推出两款Gemini语音模型
谷歌周三推出两款新的文本转语音(TTS)模型Gemini 3.8 Flash TTS和Gemini 3.8 Flash-Lite TTS,进一步拓展Gemini在AI语音生成领域的应用。
其中,Flash TTS更侧重声音表现力和复杂创意场景,而Flash-Lite TTS则针对大规模、低成本的语音生成进行优化,应用场景包括内容配音、音频制作以及实时语音代理。
谷歌开发者文档显示,Gemini 3.8 Flash TTS支持130种语言,Flash-Lite TTS支持101种语言。并可根据文字指令调整声音、语速、情绪和对话方式。
Flash TTS主打声音定制,声音设计综合指标中排名第一
据谷歌介绍,Gemini 3.8 Flash TTS主要面向有声书、播客、游戏角色和互动媒体等创意应用,用户可以通过自然语言提示词从零设计声音,包括角色设定、口音和声音特征等。
该模型还支持根据约30秒的音频样本复制声音。谷歌表示,进行声音复制时,需要获得声音所有者的同意,并通过相应的同意验证机制。生成的音频则会嵌入不可感知的SynthID水印,以帮助识别AI生成的语音内容。
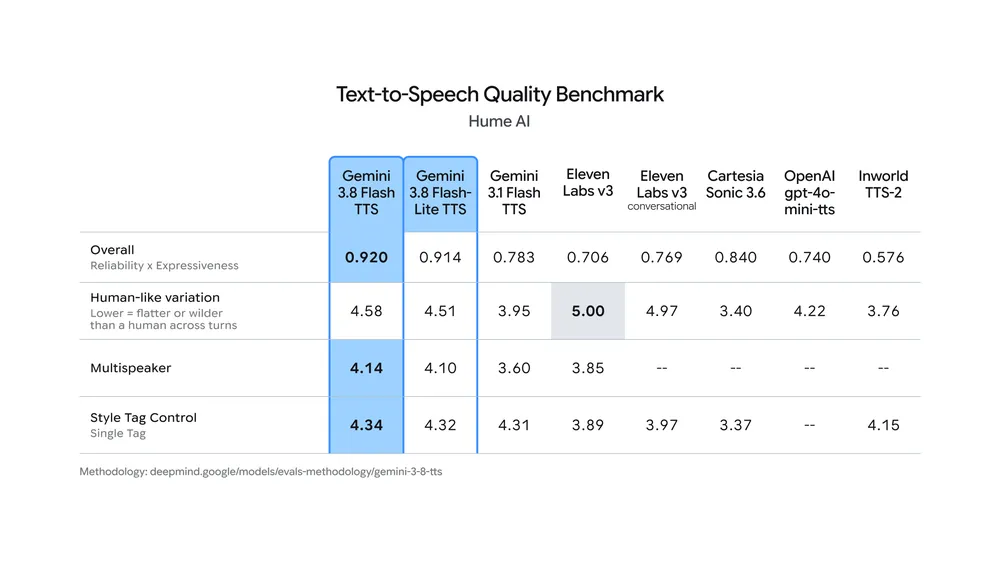
Gemini 3.8 Flash TTS在Hume AI的Voice Design Benchmark中取得71.4分,在声音设计综合指标中排名第一;两款模型在Hume AI Overall Quality Index中分别位列第一和第二。
目前,谷歌提供超过2000种可直接使用的声音,并覆盖墨西哥西班牙语、魁北克法语和苏格兰英语等地区性语言变体。
两款模型均强化多角色对话
除了声音定制,两款模型均支持对每一句台词进行单独控制,用户可以通过脚本指令调整语气、节奏、情绪以及停顿等表现。
谷歌称,新模型还支持双人对话,并能够在同一脚本中保持不同角色的声音区分。此外,模型可以生成笑声、叹气等非语言声音,以及“嗯”“是的”等对话中的回应,从而使生成语音更接近真实交流。
谷歌表示,两款模型均已开始通过Gemini API和Google AI Studio向开发者提供。
其中,Flash TTS还可用于Gemini Notebook,Flash-Lite TTS则已接入Google Vids。面向企业的Gemini Enterprise API支持将于后续推出。
从产品定位来看,谷歌此次更新并非单纯提升文本转语音的自然度,而是试图进一步增强用户对AI声音“设计”和“表演”的控制能力,使语音生成从固定音色选择向可定制的角色、场景和多角色对话扩展。