


刚刚,中国AI占领全球前四
新智元 · 经八阕原文
AI视频,已经开始挑战「实时造世界」了!
9月初,Runway公布GWM Worlds 2研究预览,把音视频生成推进到了实时交互。
你让角色往前走,让房间涌进水,让沙尘暴卷过来,模型就接着生成后面的画面与声音。镜头怎么转、场景怎么变,都能继续下指令。
视频里的世界,开始跟着人的操作往下演。
但一个问题也跟着冒了出来:画面接得上,物理就一定说得通吗?
一篇名为PhysWeep的预印本,给「视频模型懂物理」泼了盆冷水。
研究人员测了三个开放视频生成模型。其中两个,在能追踪运动的样本里,暴露出一个问题:动作看着自然,物理参数却没按要求变化。生成结果,反倒更受随机种子左右。
画面演得挺像,物理题却做错了。
这道坎,恰恰卡在视频生成继续往前走的路上。
视频模型似乎学会了「马上回应」,却还没有学会「合理回应」:角色看似实时行动,场景随指令变化,但水为什么这样流、物体为什么这样倒、人物为什么此刻作出反应,仍在考验模型。
实时交互解决的是延迟,理解世界最需要的是逻辑。想让模型模拟事情如何发生,光靠几秒惊艳的画面,显然交不了卷。
就在这个节点,智象(HiDream.ai)发布原生全模态视频模型HiDream-O1-Video-1.0(下文简称HiDream V1)。
这是一款全新的「原生全模态」视频生成模型。它瞄准的,正是物理合理性、叙事规划和音画同步。
说得直白一点,就是让模型更懂创作者想要什么,生成的视频更连贯,也更接近可用素材。
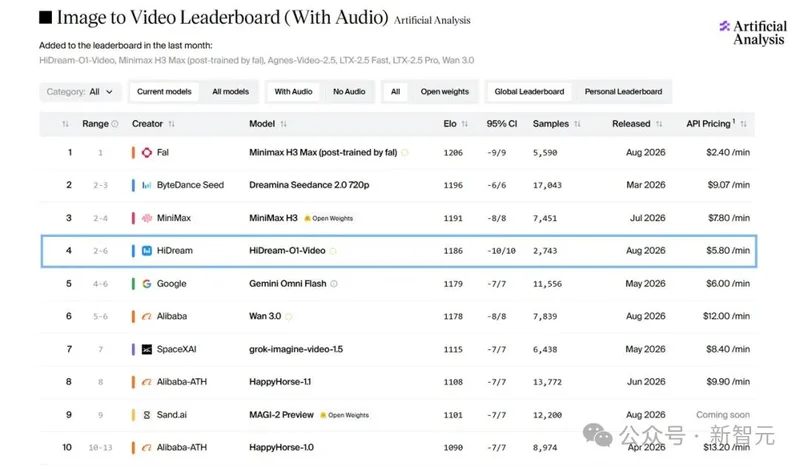
首次参评,就在Artificial Analysis图生视频榜(含音频)杀入全球第四,Arena图生视频盲测榜全球第八。
来源:新智元(经八阕转载) · 查看原文