


李飞飞的世界模型:原理、现实与未来
李飞飞的世界模型:原理、现实与未来
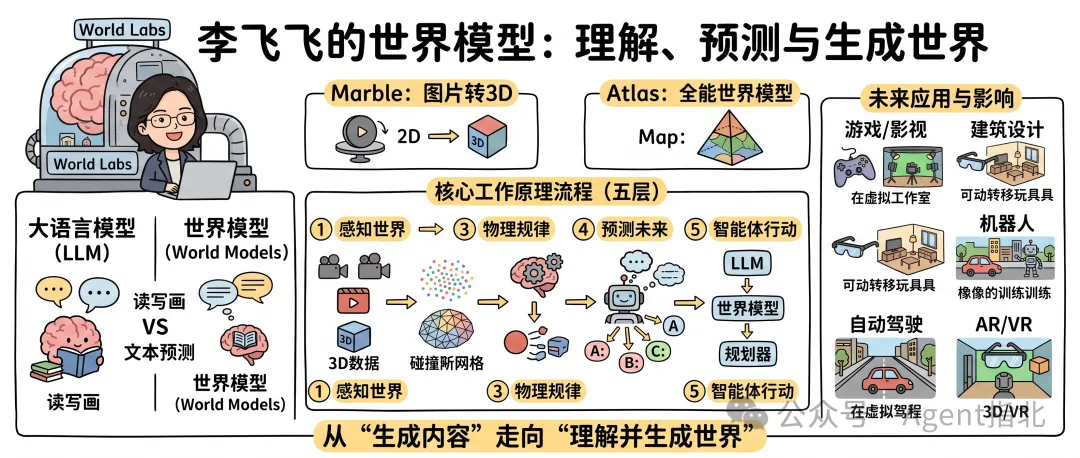
今天的人工智能已经很会读、写、画,但它对真实世界的理解仍然有限:它可以认出桌上的杯子,却未必知道机械臂从哪个方向抓取更安全,也很难准确推演“推一下杯子,接下来会发生什么”。世界模型要补上的,正是这块能力。
它的意义并不只在机器人领域。对普通用户来说,世界模型可能让家装设计从效果图变成可进入、可修改的三维空间,让游戏和影视创作者用自然语言搭建场景,也让自动驾驶和机器人先在模拟环境中反复试错,再进入现实世界。简单说,它正在推动生成式人工智能从“生成内容”走向“理解并生成世界”。
文章将说明三个问题:世界模型是什么,它如何工作,以及它可能怎样改变我们的生活与工作。
李飞飞创办的 World Labs将目标概括为“空间智能”:让模型能够感知、生成和推理空间,并逐步与虚拟世界和现实世界互动。公司已经推出 Marble 系列世界模型及相关产品;2026 年 9 月 1 日,又公布了全能世界模型 Atlas。
1. 世界模型到底是什么?
可以先从它与大语言模型的区别说起。
大语言模型主要学习:
接下来最可能出现什么词?
例如,看到“杯子从桌上掉下来”,大语言模型很可能会接着说“杯子可能摔碎”。它知道这种因果关系,往往是因为训练文本中出现过大量相似描述。
世界模型则要学习:
当前世界处于什么状态?执行一个动作后,世界会变成什么状态?
假设机器人看到桌子、杯子和地面,它需要在内部完成这样的推演:
杯子放在桌面上
机械臂向右推动杯子
杯子越过桌沿
杯子受重力影响掉到地面
杯子可能破碎
也就是说,大语言模型侧重预测语言,世界模型侧重预测世界。它先建立对环境的内部表示,再据此判断某个动作可能带来什么结果。
2. 为什么要研究“空间智能”?
今天的大模型很会“说”,却不一定真正理解我们生活的三维世界。
给人工智能一张房间照片,大语言模型或视觉—语言模型可以告诉你:“这里有桌子、椅子、沙发和窗户。”但真正的空间智能还要回答更多问题:
• 沙发离桌子有多远?
• 桌子后面还有多少空间?
• 机器人能否从中间穿过?
• 杯子被推动后会往哪里掉?
• 柜门打开时会不会撞到椅子?
• 人走到桌子后面,会看到什么?
这些问题要求人工智能从识别物体继续向前一步:理解物体之间的空间关系,推演变化,并据此采取行动。
World Labs 因此希望人工智能能够对物体、地点,以及它们在时间和空间中的互动进行建模。
3. 世界模型如何工作?
一个世界模型可以粗略拆成五层。
第一层:感知世界
模型接收图片、视频、三维数据、深度信息、相机运动、机器人轨迹和动作记录,并从中学习世界的外观与结构。
Marble 已经支持文字、单张或多张图片、视频、360° 全景图和粗略三维结构等多种输入。
第二层:建立内部空间表示
一张图片只是从某个角度看到的世界,真实环境却是三维的。模型因此需要形成内部空间表示,判断:
• 物体在哪里,彼此相距多远;
• 哪些部分被遮挡;
• 换一个视角后会看到什么;
• 哪些区域可以通行或操作。
Marble 的输出包括三维高斯泼溅、碰撞网格和全景图等空间表示。三维高斯泼溅是一种用大量带有颜色和透明度的三维点快速重建场景的方法;碰撞网格则帮助系统判断物体之间是否会发生接触或穿透。
第三层:学习世界规律
模型从大量视频和动作数据中观察变化,例如“推杯子,杯子移动”“松开球,球向下掉”“打开门,门绕铰链旋转”,并逐渐学到隐含的运行规律。
这些规律未必会像物理课本那样写成公式,更可能以神经网络参数和潜在空间中的统计模式存在。大语言模型从文本中学习语言规律,世界模型则试图从现实数据中学习世界规律。
第四层:预测未来
有了内部表示,模型就可以连续模拟动作及其结果:
当前状态 S₀ + 动作 A₁ → 世界模型 → 预测状态 S₁
预测状态 S₁ + 动作 A₂ → 预测状态 S₂
预测状态 S₂ + 动作 A₃ → 预测状态 S₃
人工智能可以先在内部尝试多种方案:
方案 A:从左边抓取 → 撞到盘子 ×
方案 B:从上方抓取 → 成功 √
方案 C:从右边抓取 → 杯子滑落 ×
比较结果后,它再选择方案 B。这很像人类行动前的思考过程:先想象,再行动。
第五层:与智能体结合
未来的智能体可能组合多种能力:
大语言模型:负责语言、知识和推理
世界模型:负责空间理解、物理规律和结果预测
规划器:选择行动方案
虚拟世界或现实世界:执行行动
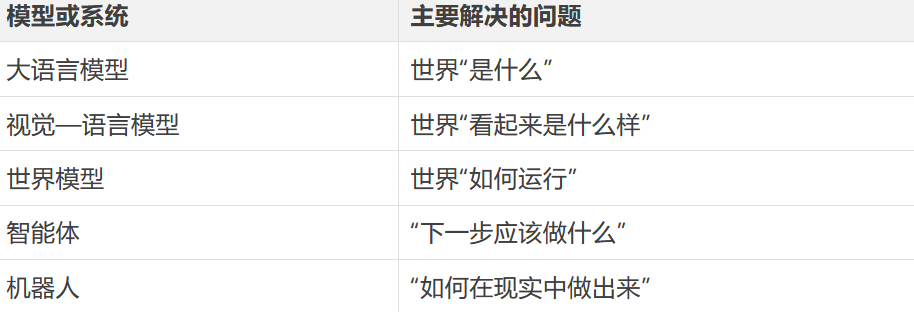
这些能力组合起来,人工智能才可能真正做到能看、能理解、能预演,也能行动。
4. Marble 和 Atlas 已经做到什么程度?
Marble:把图片变成可探索的三维世界
World Labs 的第一个产品是 Marble[2]。给它一张房间照片,它可以生成一个能够改变视角、保持空间一致性的三维世界。
二维图片 → 可探索的三维世界
除了图片,它还可以将文字、多张图片、视频、全景图和三维结构转化为可持续存在的三维世界。生成结果能够继续编辑、扩展和拼接,也可以导入游戏引擎、Blender、Maya、3ds Max 等工具。
它和普通人工智能视频生成的区别也在这里:视频生成主要生成一段连续画面;世界模型尝试生成一个空间一致、可从不同角度探索,甚至可以用于模拟的环境。
Atlas:同时生成、重建和模拟世界
2026 年 9 月 1 日,World Labs 公布了新一代全能世界模型 Atlas。它从头训练,可以直接处理文字、图片、视频和三维数据。技术上,Atlas 采用多模态自回归扩散变换器架构:先把不同输入放进同一个空间上下文,再预测接下来应该生成的画面、结构或变化。
Atlas 目前展示了四类能力:
• 镜头控制生成:根据一张或多张参考图片,在指定机位和角度生成新画面;官方演示可输出最长 1 分钟、分辨率为 1440p 的视频。
• 空间重建:从一张到数十张图片重建现实场景,补出新视角,并输出点云或三维高斯泼溅等可直接使用的三维结果。
• 时空模拟:根据视频理解场景如何随时间变化,改变观察视角,也可以把真实环境转成机器人训练所需的模拟环境。
• 图像与全景生成:根据文字或图片生成普通图像和 360° 全景图,并尽量保持空间关系一致。
Atlas 把世界生成、现实场景重建和动态模拟放进了同一套模型。比如,输入一段真实房间的视频,它既可以重建三维空间,也能预测机器人沿不同路线移动时,机身摄像头会看到什么。对于影视创作,这是可精确控制的虚拟摄影棚;对于机器人,它可以成为进入现实环境前的训练场。
Marble 和 Atlas 的关系可以这样理解:
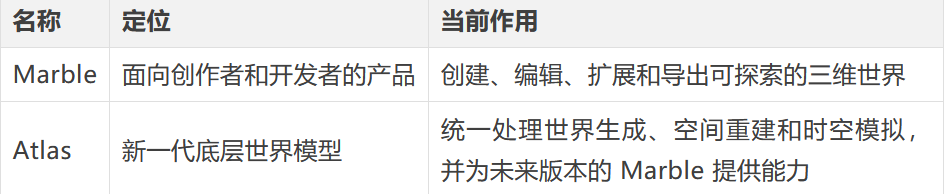
目前,Marble 已经面向用户提供服务;Atlas 仍处于面向部分合作伙伴的早期开放阶段。因此,Atlas 展示的是 World Labs 下一步的技术方向,其能力还不能简单等同于所有用户现在就能直接使用的完整产品。
5. 它对普通用户有什么价值?
最直观的变化,是生成式人工智能将从“给你一份内容”变成“给你一个可以进入和操作的环境”。
比如,你输入“设计一套 80 平方米的日式原木风住宅”。今天的工具多半提供几张效果图;未来的世界模型可能直接生成一套可进入的房子。你可以戴上增强现实或虚拟现实设备走进客厅,移动沙发、更换地板、调整灯光,观察下午的阳光如何落进房间,甚至同步估算装修成本。
对个人创作者、小团队和没有三维建模经验的用户来说,这意味着制作空间内容的门槛可能大幅下降。描述想法,不再只是得到一张图,而是得到一个可继续修改的世界。
6. 哪些行业可能率先受到影响?
过去制作一个游戏场景,需要策划、原画、建模、贴图、场景设计和程序开发共同完成。未来,一句“生成一座赛博朋克城市”就可能得到可探索的三维空间。专业人员仍要控制美术风格、玩法和细节,但搭建初始场景的成本会明显降低。
导演可以提出“生成一条 20 世纪 80 年代东京雨夜的街道”,再进入生成的环境选择机位、安排角色和调整灯光。此时,人工智能提供的不是一段固定视频,而是一座可以反复取景的虚拟摄影棚。
建筑与室内设计
系统可以把户型图转换为三维住宅,帮助用户比较采光、家具布局和人在空间中的移动路线。设计师也能更快地与客户沟通方案,而不必等到完整建模后才发现理解有偏差。
在现实中训练机器人代价很高:摔一次就会造成真实损耗,撞到物品也可能带来安全问题。世界模型可以把真实环境转成模拟环境,让机器人先训练成千上万次,筛选较好的策略,再部署到现实中。
World Labs 已将“现实—仿真—现实”列为机器人训练的重要方向,并通过收购 SceniX 推进机器人的空间智能研究。
现实道路中很难反复收集“暴雨、夜晚、行人突然出现、前车急刹”等危险组合。世界模型可以生成大量边缘场景,让自动驾驶系统在不伤及真实人员和车辆的前提下提前训练。
7. 更深一层:人工智能可能获得“想象未来”的能力
人类搬桌子时,通常不会随机尝试 100 次。我们会先在脑中判断:正着搬可能过不了门,转 90° 或许可以,然后才动手。
这个过程可以概括为:
世界模型 → 内部模拟 → 行动规划 → 实际行动
如果人工智能具备类似能力,它就不再只是根据过去的资料回答问题,而是能够比较几种可能的未来,再决定怎么做。这也是世界模型对机器人和物理世界人工智能格外重要的原因。
当然,“预测得像”不等于“理解得对”。一旦模型对物体、空间或物理规律判断错误,后续规划也会跟着偏离。因此,世界模型真正走进现实设备之前,还要解决一致性、可控性、安全验证和计算成本等问题。