


10亿Tokens免费送:实测Spark-X2.6
去讯飞一年一度的全球1024开发者节走了一圈,感受就一个: 热闹,真热闹啊。 看图就知道,想在人群里往前挪两步有多难了—— 展台前的人一拨接一拨,有人上手体验,有人围在一起聊技术、问细节,现场展示的AI成果和沉浸式互动一个接一个,硬核科技含量一整个拉满。
不过,比热闹更值得看的,还是这些AI产品到底能做什么。 教育、医疗、金融、翻译……讯飞这次把一批行业AI产品搬到了展台上,国产大模型怎么进入具体场景、怎么适配不同行业、又怎么真正用起来,在这里都能看到具体展示。 其中,今年9月发布的Spark-X2.5系列开源模型,全渠道累计下载量突破了256万(进入全球端侧模型下载量前四),4B版本还冲上过Hugging Face近7天Trending榜第一。 「256万下载量、榜单第一」,成绩确实亮眼,但我这次真正盯上的,是另一件事: 讯飞走的,还是一条和大多数玩家不太一样的路。 全栈自主可控。 从模型训练到推理,再到端侧部署,讯飞一直在用国产算力撑起整套大模型体系。 这条路有多难,懂的都懂。。。 所以问题来了: 不靠英伟达GPU,这套全国产体系究竟把中国模型带到哪一步了? 正好,讯飞最新也掏出了Spark-X2.6。 全国产,不止把模型训出来 正式实测前,有件事得先掰扯清楚: 虽然都在讲「国产大模型」,但这里面的国产算力路线,其实还不太一样。 有几个概念经常混淆在一起,这次我干脆梳理了下:
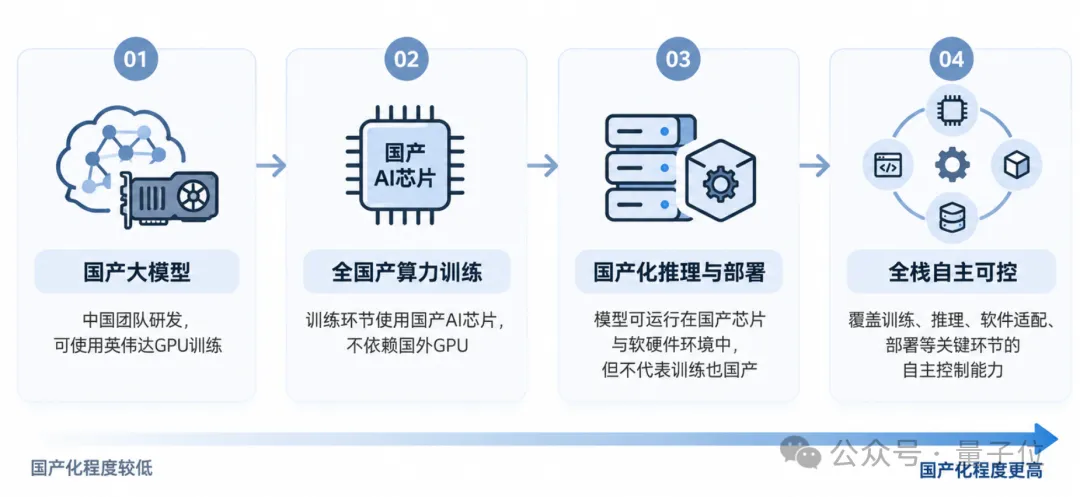
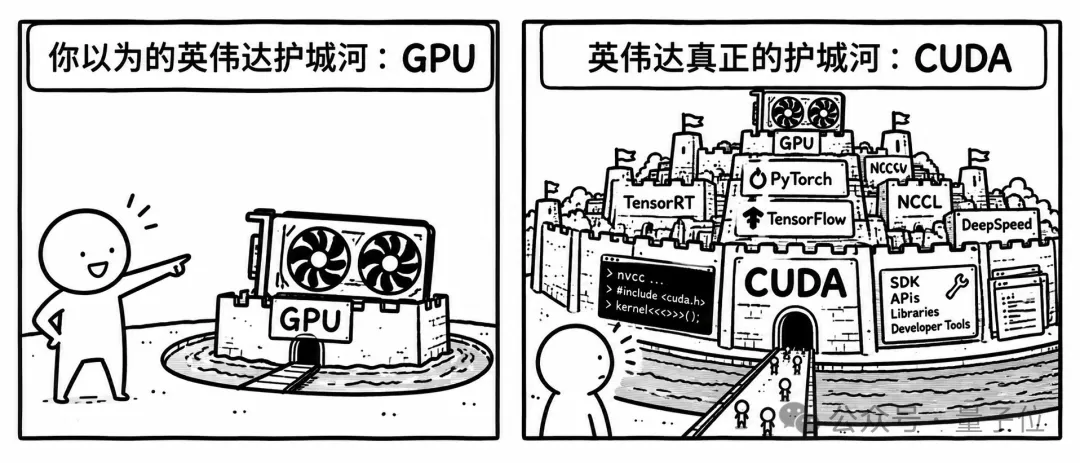
△图片由AI生成 显然,讯飞选的是最后那条更难的路: 从模型训练、强化学习、持续迭代到推理部署,整条链路都落在国产算力平台上。 核心链路的英伟达含量为0,怎么说呢?听着确实爽。 但真往下扒,就知道这事有多难。 过去几年,行业讨论全国产大模型,最先被追问的通常是: 国产卡,到底能不能把模型训出来? 这确实是最直观的一关,可真到了大规模训练,难题才开始涌现。 英伟达的优势不仅在GPU,还有围绕CUDA积累多年的软件生态,换成国产芯片后,从算子、框架到多卡通信都要重新适配。 规模一旦上到千卡、万卡,训练效率和集群稳定性又成了新的考验。 很多工作藏在模型背后,普通用户看不到,却最耗时间和研发资源。
△图片由AI生成 我又顺着讯飞这几年的时间线翻了翻,发现它对全国产的理解,确实比「用国产卡训个模型」多走了几步。 这可能跟讯飞长期扎在行业场景里有关。 模型一旦进入医院、学校和企业系统的各种硬件设备,算力供应、数据安全和部署成本就成了绕不开的问题,也推着它更早走上了全链路国产化的路线。 2023年,讯飞联合华为推出「飞星一号」,先把大规模国产算力底座搭了起来。 后面又有国产算力上的千亿参数模型Spark-V3.5、深度推理模型Spark-X1。 到了今年,Spark-X2.5开源了4B和1.7B端侧模型,开始往更多终端设备里钻。 一路啃到Spark-X2.6,问题已经从训练走到了部署: 模型究竟该在哪里运行? 最近我正好看了Every那篇《How Codex Happened》,发现OpenAI也在这个问题上交过学费。 OpenAI最初把Codex全放在云端,却因为环境配置麻烦、任务难以随时干预而碰壁,后来才转向本地,并逐渐把两边打通。 为什么最后还是两边都要?看完这张表就明白了:
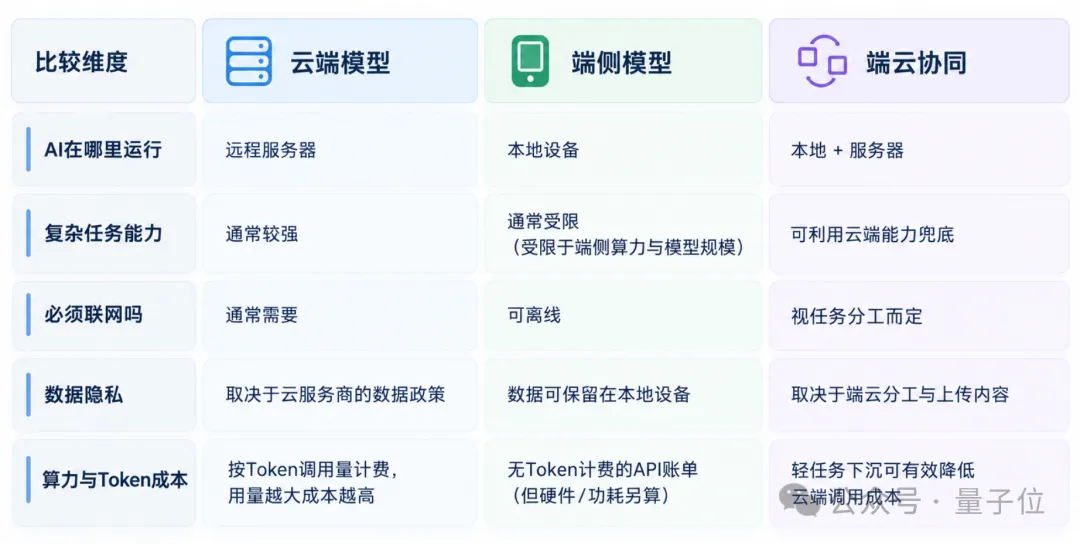
△图片由AI生成 云端胜在能力,端侧胜在离线响应、成本和隐私,放进真实业务里,很难只押一边。 更实际的方案,是把选择权交给企业: 什么任务留在本地,什么任务交给云端,哪些数据可以上传,一次调用又愿意花多少Token。 Spark-X2.6做的,正是让端侧和云端按需分工: 任务先由端侧模型判断,再选择合适的执行路径,形成三种协同模式。 简单任务直接在本地完成,这是「纯端侧执行」。 需要云端能力的任务,先在端侧脱敏,再交给云端处理,这是「纯云侧执行」。 需要两端配合的任务,则在端侧脱敏后进入「云+端执行」——既可以由云端提供指导、端侧完成操作,也可以让端侧和云端分工协作,共同完成任务。 思路听起来挺顺,就是不知道能不能真省Token、护住隐私? 那就,开测。 实测Spark-X2.6 Spark-X2.6现已上架讯飞星辰MaaS平台,采用MoE架构,总参数量293B,每次推理激活约30B,支持1M上下文。 当前API价格打六折,每百万输入tokens 0.9元,每百万输出tokens 3.6元(比大肥鱼谷价便宜约10%)。
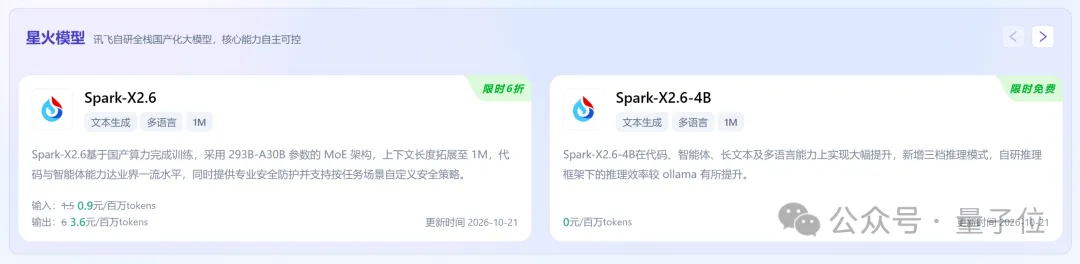
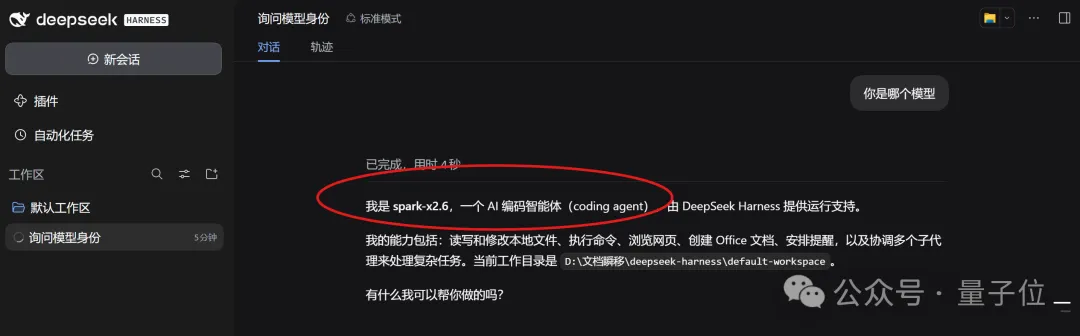
和9月份发布的X2.5相比,这一代主要往前推了三步: 干活能力更强:X2.6的代码和智能体能力整体分别提升约8个点,模型整体实力位列业界第一梯队; 国产算力跑得更顺:通过训练和推理架构优化,模型在国产训练平台上的效率提升4倍,四层KV Cache的命中率达到95%; 用起来更省:在高频应用场景中,约60%的任务实现了Token消耗下降。 归纳起来,这些升级指向的还是那个熟悉的主题: 干活儿。 既然测的是干活能力,只在聊天框里问几道题,显然不太够。 所以这次,我把Spark-X2.6的API接进DeepSeek Harness,让它直接读写文件、运行代码,并根据运行结果排查报错。
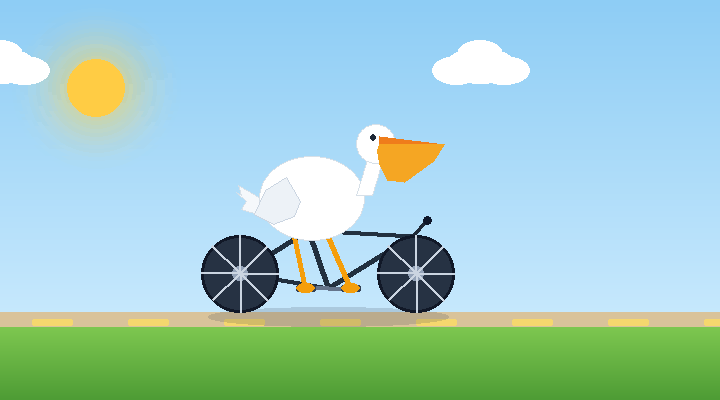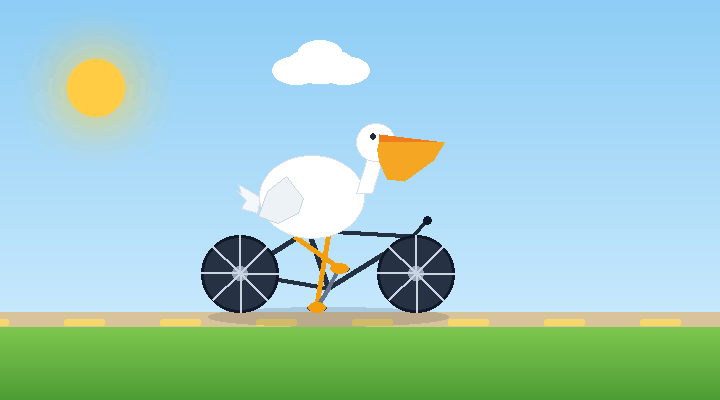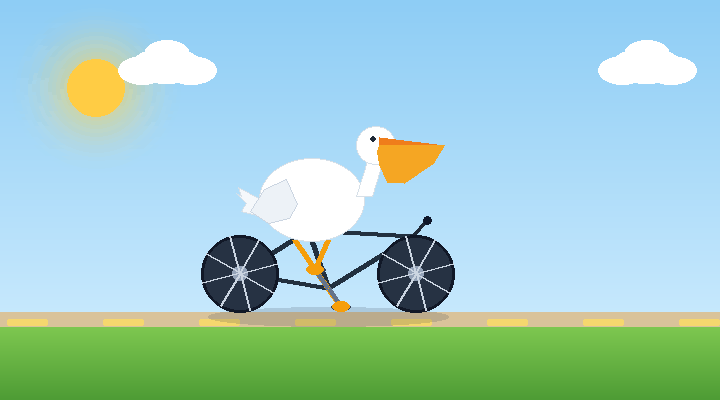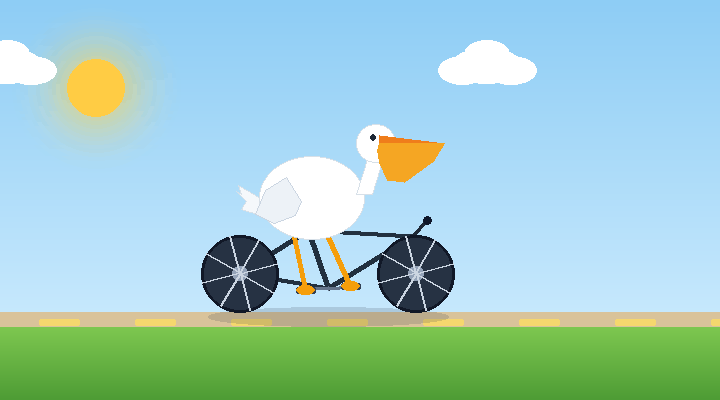
别的先不说,先看看它和当前最顶尖那批模型还有多大差距。 最近硅谷头部模型发布时,视觉Coding几乎成了固定节目,骑自行车的鹈鹕、3D交互场景都被反复拉出来展示。 虽然这类任务代替不了Benchmark,但胜在结果足够直观,所以第一关,我也给Spark-X2.6安排了「顶流同款」。 「顶流同款」测测模型本身有多强 先来一只骑自行车的鹈鹕。 Prompt用的是硅谷测试里常见的极简写法,没有规定画风、构图和实现方式,只给模型一句话: Create an SVG of a pelican riding a bicycle. Save it as pelican.svg in the current directory and preview the result. Do not use external image assets.(创建一个骑着自行车的鹈鹕的SVG,将其保存到当前目录下的pelican.svg文件中,并预览结果,不要使用外部图片资源。) 要求越少,模型自己的代码基本功和审美反而越藏不住。 下图是模型一次直出的结果,第一眼看过去完成度确实不低: 自行车结构完整,近景和远景也都补上了。
趁着手热,我又加了一道题:3×3魔方模拟器。 这回不只要把魔方用纯CSS 3D画出来,六个面还得真能转,打乱、重置也都安排上。 最后做出来的版本也挺省心,不用装依赖,一个文件打开就能跑,拖着鼠标能换视角,想怎么拧就怎么拧。 魔方都能拧了,那不得来一个大BOSS级别的终极考验: 用代码搭一座可以自由探索的3D故宫。 我扔过去一段AI生成的提示词,然后趁着Spark-X2.6在后台跑,去吃了个饭。 没想到再回来时,它已经交付了一套由index.html、style.css和main.js组成的完整网页。 打开本地服务,红墙金瓦沿着中轴线铺开,鼠标可以自由旋转、缩放和移动视角。 说实话,比我预想的完整不少。 小试牛刀下来,Spark-X2.6虽然不能一次猜中所有细节,但对反馈的响应很快。 这点对Coding Agent其实挺重要。 玩过Vibe Coding的朋友应该都有体会,即使用上「OA」两家的旗舰模型,一次生成就完全符合预期,也不太现实。 所以对我来说,真正影响体验的,是模型能不能听得懂人话,改得快、改得准。 当然,画图和搭网页还只是热身,接下来得给它安排点真正的班上了。 把4B模型装进电脑,先让它独立上班 这回的主角换成了刚刚开源的Spark-X2.6-4B。 别看参数量只有4B,它却支持最高1M上下文和200多种语言,也适配了Ollama、LM Studio等本地运行工具,以及llama.cpp、vLLM等主流推理框架。
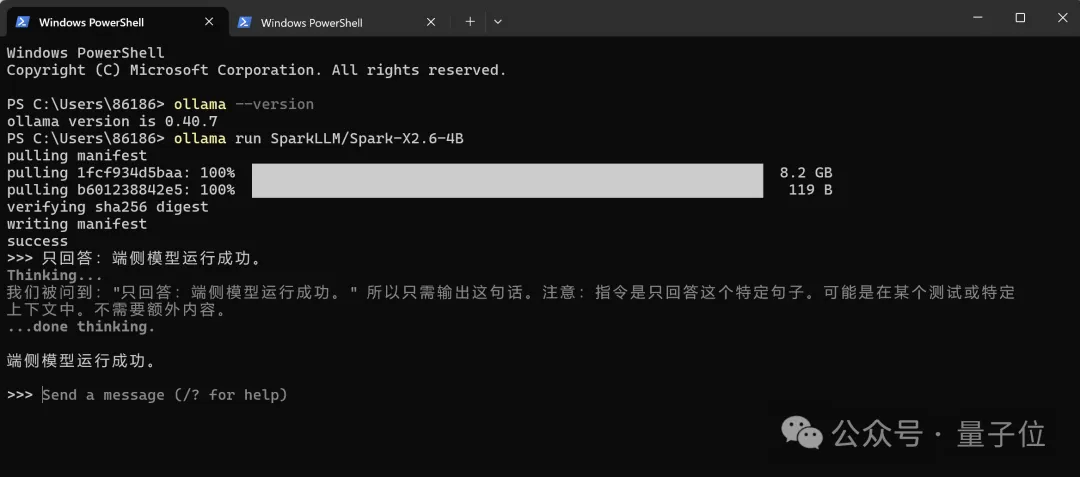
为了尽量榨出4B模型的能力,讯飞在后训练阶段加入了能力感知机制,让模型判断自己的薄弱项,再向不同教师模型针对性学习。 据讯飞内部评测,同尺寸端侧模型能够独立完成的Agent任务比例约为12.8%,而Spark-X2.6-4B将这个数字提高到了41.9%。 不管了,是骡子是马总得拉出来遛遛。 由于我的电脑只有AMD核显、没有独立显卡,模型全程依靠CPU推理,所以我通过Ollama部署了Spark-X2.6-4B的Q4量化版本,并从终端调用本地API。 模型成功运行后,我直接断开网络,确保材料读取、分析和结果输出全部留在这台电脑里。
我给它安排的任务,是替一家虚构的机器人公司,完成周度经营复盘。 销售周报、客户邮件、生产排期和供应链记录散落在不同文件里,部分信息还互相矛盾,它需要跨文件核对数据,找出营收变化、客户冲突和交付风险,最后列出等待管理层拍板的事项。
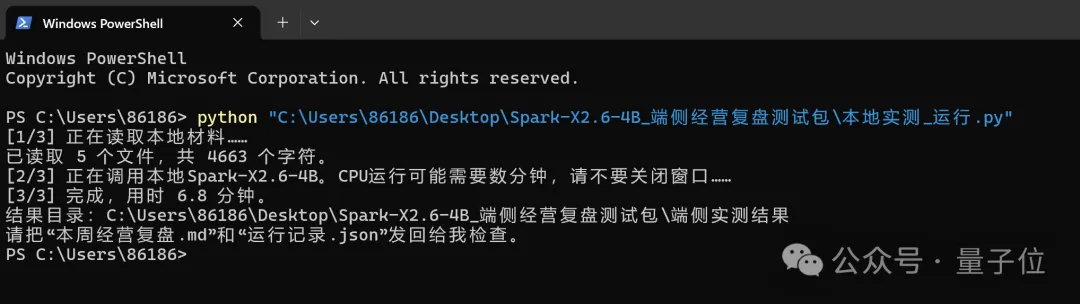
最终,模型用时6.8分钟,交出了一份完整的经营复盘报告。 它分清了2550万元销售口径营收与2370万元财务确认收入,也找出了两笔重点商机和三类供应链缺口,主要结论均注明了信息来源。
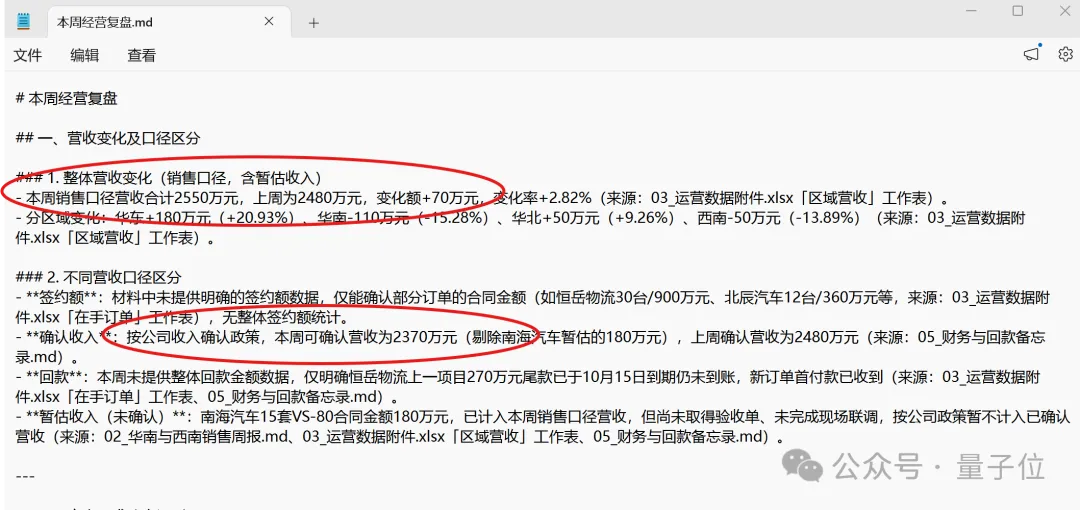
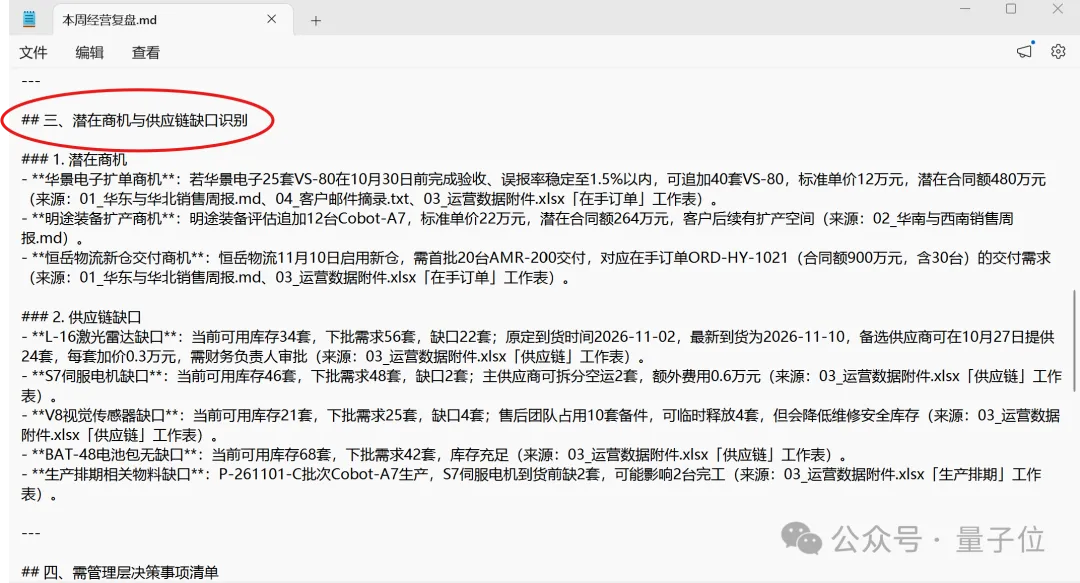
综合数字准确性、跨文件关联、风险识别、来源追踪和报告完整度五个维度,这轮任务的完成度大约在九成。 要挑毛病的话,它把一笔在手订单归入了潜在商机,分类还不够严谨,不过相关事实和金额均无误,经过简单人工复核,已经可以作为管理层讨论的参考材料。 对一款完全离线、全程依靠CPU运行的4B模型来说,这份答卷已经能打。 涉及敏感信息的复杂任务,再让云端接力 不过,端侧模型的能力终究有边界,遇到更复杂的任务,云端依然得上场。 那什么任务留在本地,什么任务值得上云呢? 为此,讯飞引入了一套基于评语模型的端云路由协同训练机制。 简单来说,就是让同一个任务分别在端侧和云端多跑几次,再由评语模型比较结果、给出反馈,并通过交替训练不断优化路由判断,让系统更清楚一个任务到底该交给端侧、云端,还是两边一起完成。 据讯飞内部评测,这套机制将端云任务路由准确率从81.2%提升到了96.1%。 都96.1%了,所以这轮实测,我决定给它安排一份更敏感、关联关系也更复杂的材料: 审查一份工业视觉检测设备采购合同。 合同依然是虚构的,但公司名称、联系人、电话号码、银行账户和合同金额一个不少,付款、验收、数据上传、知识产权和违约责任之间还藏着多处关联风险。
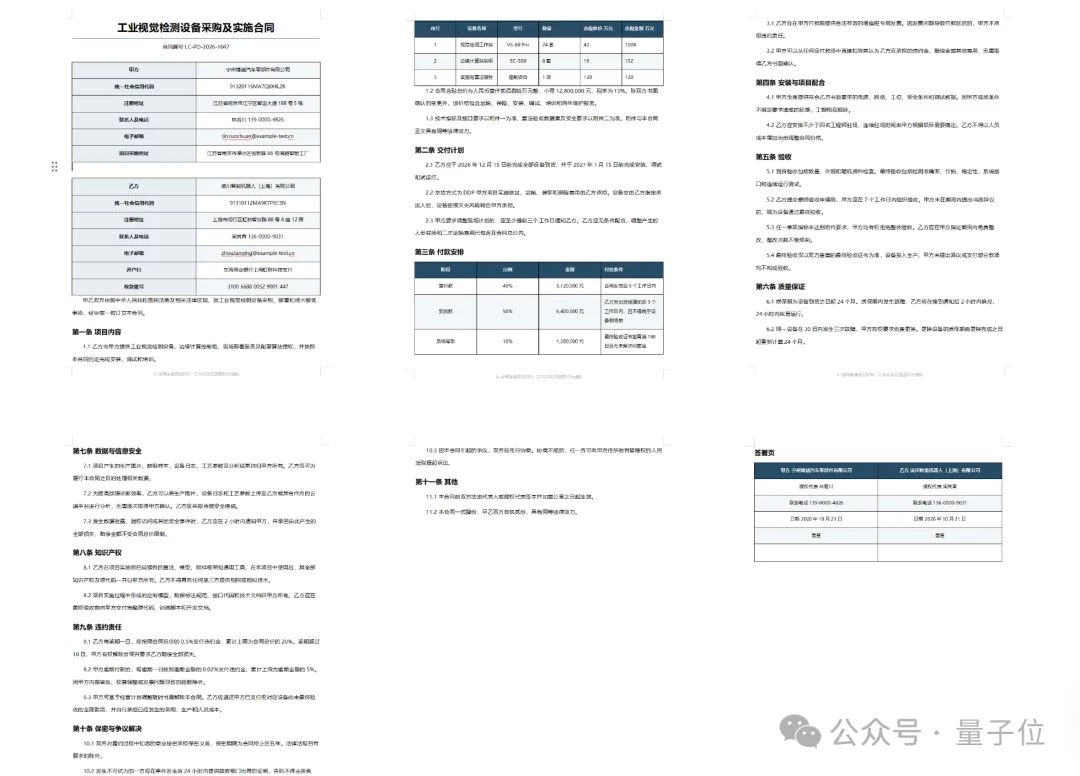
我先让本地4B模型负责脱敏。 用时4.3分钟,合同中的26项敏感信息全部被替换成占位符,检查结果显示没有原始信息残留。
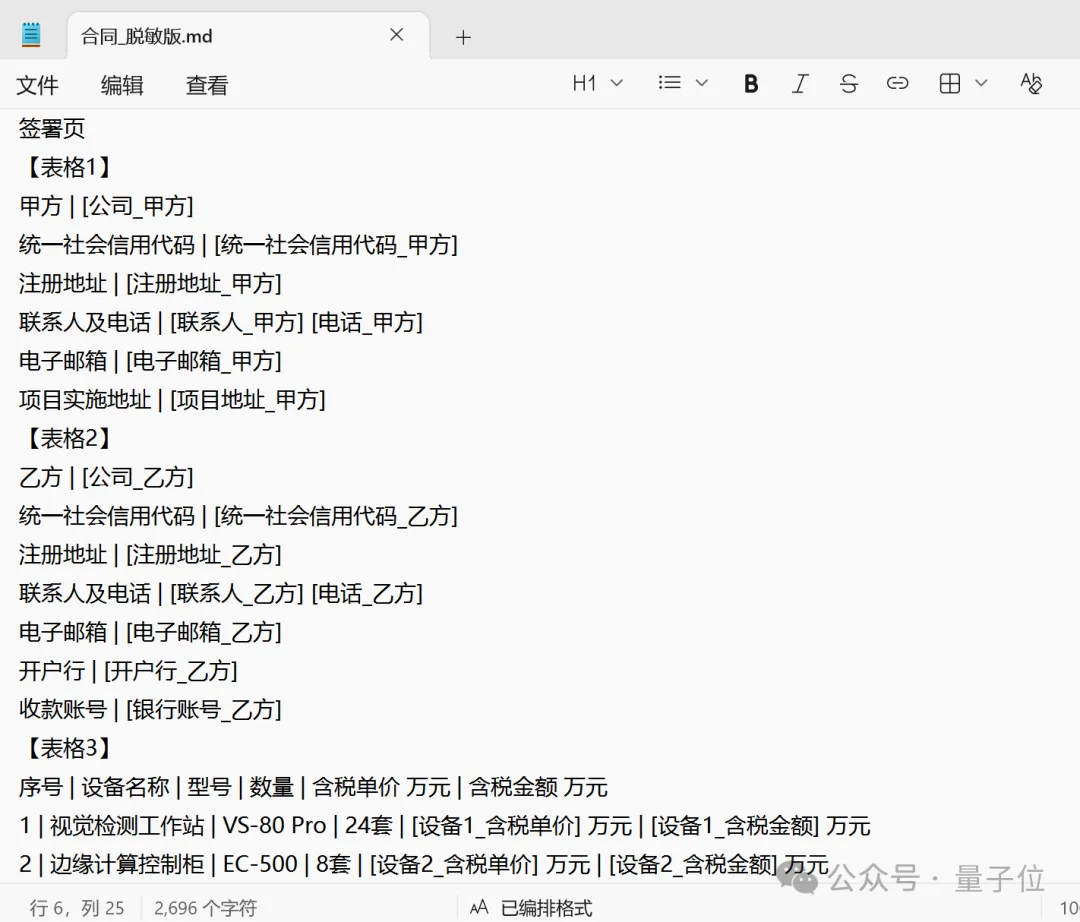
确认处理干净后,我才重新联网,把脱敏合同交给云端X2.6。 70.8秒后,消耗7368个Tokens,它交出了一份完整的审查报告,找出了18项风险和8组条款冲突。 像是验收标准前后打架、允许数据直接上传云端却要求供应商承担无限责任,这些藏在不同条款里的问题,也被它顺藤摸瓜揪了出来。
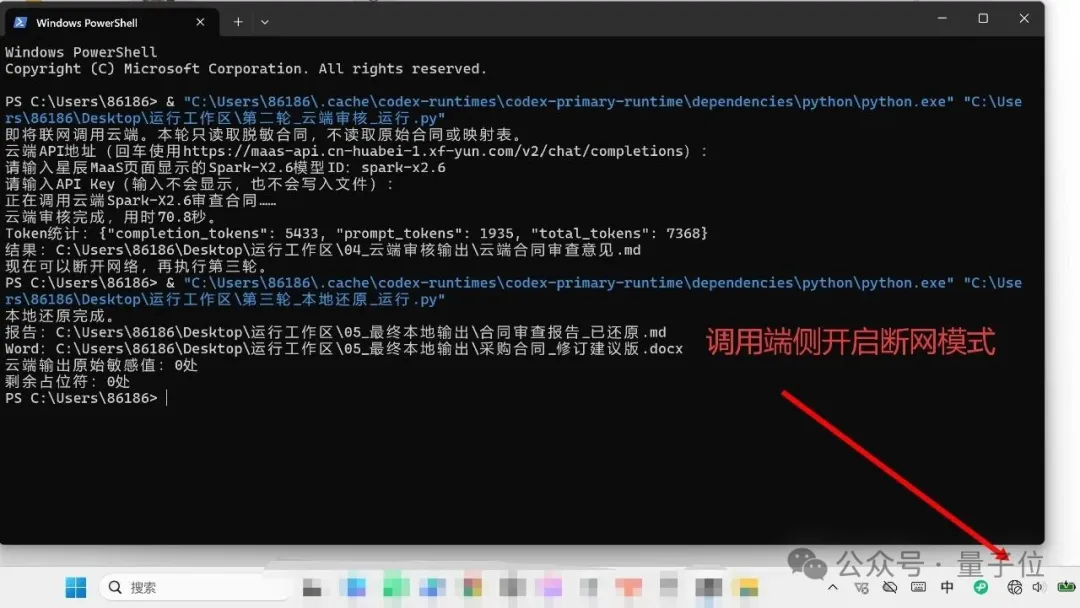
随后,我再次断网,在本地恢复合同信息,并生成附带逐条修改建议的Word文件。 为了避免自己给自己判卷,我又把全套材料扔给Codex复核了一遍。 结果显示,云端收到的合同没有原始敏感信息,本地还原后也没有留下任何占位符,合同正文和表格同样完整保留。
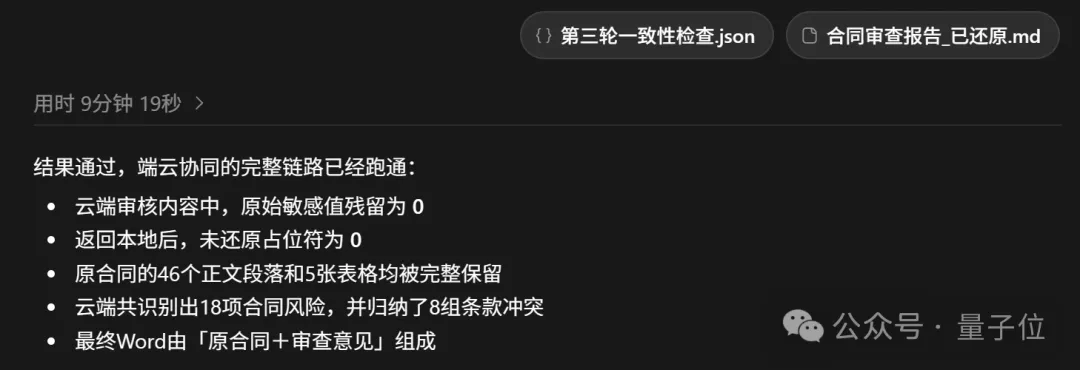
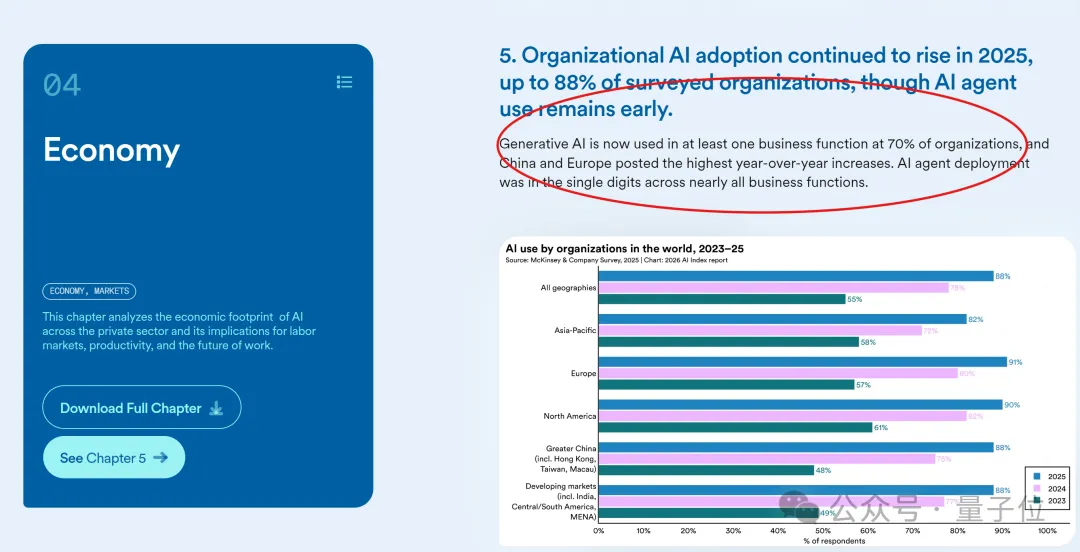
到这里,整个流程才算真正跑通: 敏感信息留在本地,复杂分析交给云端,处理完再回到本地还原。 需要说明的是,这次我只做了最小可行性验证。 为了看清每一步的数据流向,我保留了人工分配环节,完整方案则支持自动路由。 真正进入企业环境后,系统可以根据任务难度和安全要求自动分配端云任务,让这套技术方案成为一条可以持续运转的业务流程。 训出来之后,真正的考验才刚开始 一圈测下来,Spark-X2.6给我留下最深印象的,是它给企业留出了选择空间。 大模型刚火那阵,企业用AI基本就是接个云端API,简单直接。 可AI真正进入业务,事情很快就复杂起来了。 合同和客户资料不方便上传,高频调用又会持续产生Token成本,全部放在端侧,复杂任务的能力又可能跟不上。 端云协同的价值,就在于让企业根据自己的业务,自由调整部署方式。 Stanford《2026 AI Index》显示,全球已有88%的受访企业使用AI,但Agent在几乎所有业务职能中的规模化部署率仍然只有个位数。 这说明,AI已经进入企业,核心业务却还没有真正交给Agent。
想让Agent继续往核心业务里走,除了模型能力,部署方式也得跟着场景变化。 医院、学校和办公室面对的限制各不相同,端侧和云端怎么分,自然也不会只有一种答案。 讯飞有意思的地方在于,这道题它已经琢磨了好几年。 一开始,讯飞就花了大把时间死磕国产算力底座。 要知道,光是让模型在国产算力上「跑起来」,解决一连串的推理适配难题,就已经够脱层皮了。 但更狠的是,讯飞不仅跑通了,还在这套底座上走完了大模型的完整训练流程,直接训出了实力对标国际一流的大模型。 从「跑起来」到「训出来」,听着只差几个字,背后的工程难度完全不在一个量级。 放眼望去,愿意为这条全链路长期填坑的公司,真没几个。 而讯飞这些年踩过的坑、积累的经验,如今全成了做端侧模型和端云协同最硬的底牌。 当然,走得早只是开头,真正决定这条路线能走多远的,还得看规模化落地的表现。 类似的长期考验,在中国科技产业里并不少见。 北斗从1994年立项,到2020年完成全球组网,走了26年。 C919从2007年立项,到2023年商业首航,也花了16年。 从技术突破到真正投入使用,中间还有很长一段路要走。 中国模型的国产化道路,同样绕不开这一关。 新模型和榜单成绩更容易被看见,而系统适配、项目交付和长期运行这些事,平时却很少进入讨论。 模型能力可以靠一次次迭代追赶,但这类不太显眼的积累却很难一夜补齐。 讯飞早走几年的优势,已经开始显现。 P.S. 现在可以去星辰MaaS平台免费领Spark-X2.6 10亿Tokens额度~