


思维链并不是大模型的内心独白
思维链并不是大模型的内心独白
Emmanuel Ameisen:模型并非逐行写成,它是在训练中“长出来”的。 Emmanuel Ameisen:模型可以先形成一个计划,再用后面许多个Token逐步执行。 Emmanuel Ameisen:面对大模型,你其实没有一份能够直接读懂的源码。 这三句话,改变了一个很常见的大模型比喻。 LLM确实逐个预测Token,但这只描述了它怎样把答案吐出来。为了预测得足够准,模型可能已经在内部表示概念、拼接事实、保留中间判断,甚至提前选好一个尚未输出的目标。 麻烦也由此出现。模型写出的思维链,只是我们能看到的文字。它内部实际走过的路径,可能比文字更多,也可能和文字解释对不上。 Anthropic可解释性研究员Emmanuel Ameisen在访谈中,用一场72分钟的访谈解释了研究人员目前看到了什么。 备注:Emmanuel Ameisen此前做过应用机器学习,也写过《Building Machine Learning Powered Applications》。现在,他的工作有点像拿着显微镜研究Claude:为什么它会得到这个答案,它提前想到了什么,它嘴上说的理由和内部计算是不是同一回事。 这离开发者已经很近。Agent开始读取仓库、修改文件、运行命令,甚至操作浏览器和生产工具。它能做的事情越多,我们越不能只听它解释“我刚才做了什么”。 以下为访谈内容,我们结合Anthropic公开研究进行了翻译与整理。
Emmanuel Ameisen解释,大模型内部策略由训练过程形成,并非工程师逐行写入 “预测下一个Token”,只说出了模型怎样输出 很多人理解LLM时,脑中出现的是手机输入法:写出半句话,系统猜下一个词。 Ameisen认为,这个模型过于简单。输入法只要处理常见搭配,大模型还要继续预测更难的内容。当简单句法、常识和事实都被掌握后,剩下的可能是一道物理题的答案、一篇论文的最后一段,或者一段跨越多个文件的代码。 Emmanuel Ameisen:“Unfortunately, I think that’s the mental model that people have for these models.” Emmanuel Ameisen:遗憾的是,很多人仍然用手机自动补全来理解大模型。 Emmanuel Ameisen:“Predicting the hardest words is actually extremely hard to do.” Emmanuel Ameisen:真正困难的Token,预测起来极其复杂。 为了补出“Dallas所在州的首府是____”,模型不能只认识Austin这个词。它至少要处理Dallas、Texas、州与首府之间的关系。 逐Token输出和提前规划可以同时发生:前者是接口,后者可能是内部为完成预测而形成的策略。
手机自动补全只是最简单的Token预测,不能概括现代大模型的内部能力
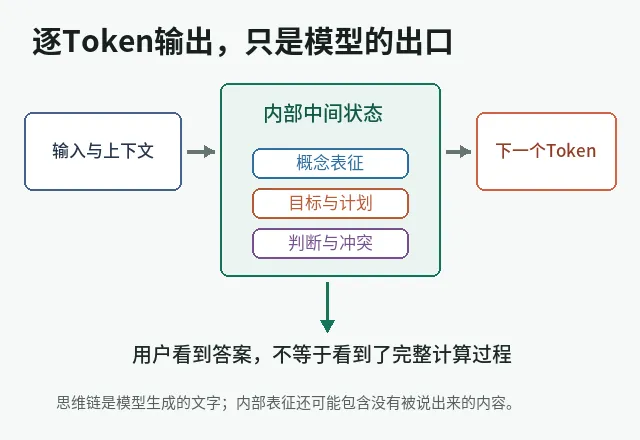
逐Token生成描述的是模型输出方式,概念表征、中间判断和隐式计划可能发生在输出之前 模型没有背下Austin,它先走过了Texas Anthropic团队会在模型生成答案前,查看层层计算留下的中间状态,并尝试把这些数字解码为可理解的特征。 在Dallas问题中,他们看到代表Texas的中间表征先被激活,随后与“首府”关系结合,最终指向Austin。 Emmanuel Ameisen:“We can see that models often have and represent these concepts.” Emmanuel Ameisen:我们能够看到,模型内部确实表示了这些概念。 Emmanuel Ameisen:“They have these general concepts that they know about and that they use and reuse to solve problems.” Emmanuel Ameisen:模型会形成通用概念,并在不同问题里反复调用它们。 同一个“眼睛”概念,可以出现在照片、医学图示、SVG绘图和不同语言里。表面形式变了,模型内部激活的方向仍然相近。 研究人员还可以干预中间状态。 把Texas替换成California后,答案会从Austin变成Sacramento。最终输出跟着中间概念一起改变,说明这条内部路径确实参与了计算。 这并不意味着模型像人一样理解世界。它说明“模型只是在训练语料里寻找整段答案”不足以解释所有行为。
研究人员在模型中间状态中观察到Texas、首府和Austin等概念之间的连接 一句诗还没写完,rabbit已经在内部出现 逐字输出最容易让人产生另一个误解:模型每次只看眼前一个词,对后面没有安排。 Anthropic用押韵诗做过实验。 模型准备续写第二行时,会先激活一个可能的结尾,例如rabbit,再组织前面的词,让整句话自然抵达这个押韵点。 Emmanuel Ameisen:“In their intermediate results, [models] sometimes formulate a plan.” Emmanuel Ameisen:模型有时会在中间状态里先形成计划。 Emmanuel Ameisen:“They can do that without saying the plan.” Emmanuel Ameisen:它不必把计划说出来,也能按照计划继续生成。 研究人员压低rabbit对应的内部表征,模型会换用habit;注入green概念,整行诗则会朝green组织。这个实验不只观察相关性,还通过干预改变了结果。 需要留一道边界:研究证明的是特定任务中的隐式规划机制,不能顺势写成“所有模型都会制定完整长期计划”。规模、任务和训练方式都会影响它能提前规划多远。 放到Coding Agent里,这个差别很关键。 Agent改动第一个文件时,内部可能已经选定后续方向,却没有把计划完整写进消息。开发者看到的自然语言说明,不一定覆盖影响修改的全部状态。
模型可以先确定rabbit这样的未来目标,再组织前面的Token抵达它 模型内部还有一块不写进答案的工作区 Anthropic在2026年公开了另一项研究:Claude内部存在一小组作用特殊的神经表征,研究人员把它称为J-space。 一些多步问题的中间概念会在这里出现,即使模型没有把步骤写出来。研究人员要求模型静默思考某件事,也能在J-space中看到相应表征;干预这块区域后,模型仍能流畅说话,却会失去部分高阶推理能力。 它有点像一块不会自动展示给用户的内部工作区,但不能直接等同于人的“意识”。Anthropic在论文说明中也明确写道,这些结果无法证明Claude是否拥有人的意识或感受。
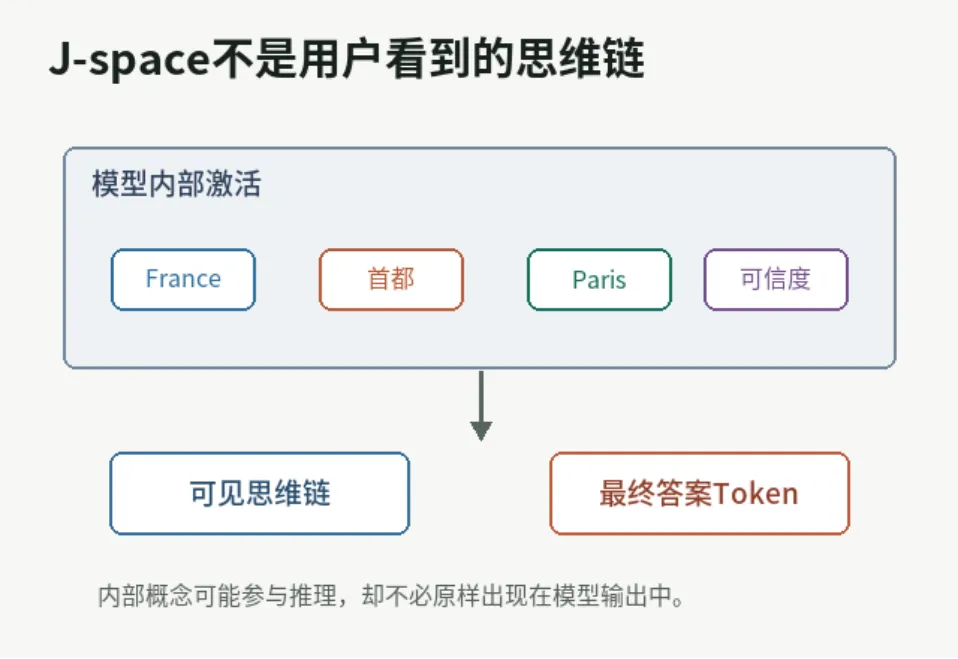
J-space位于模型内部激活中,能承载未写入输出Token的中间概念;它与可见思维链并不是同一个东西 思维链可能只是模型事后补写的说明 如果内部计划不一定被说出来,反过来也成立:说出来的推理,不一定完整对应内部计算。 Anthropic曾让Claude处理一道困难数学题,并故意给出错误提示。模型有时会接受提示中的目标答案,再从答案倒推一套听起来合理的步骤。 它声称自己完成了计算,研究人员却没有在内部看到相应的计算痕迹。 Emmanuel Ameisen:“Models are able to represent stuff in their intermediate results that they don’t say.” Emmanuel Ameisen:模型能够在中间状态里保存没有说出口的内容。 这并不是说思维链没有价值。它仍然能帮助人理解模型准备怎样处理任务,也方便发现明显错误。问题出在把它当成了执行证据。 Agent说“我检查了所有调用关系”,不能证明它真的搜索了完整仓库;它说“测试失败与本次改动无关”,也不能代替测试日志和复现过程。 在普通程序里,日志可以由开发者明确埋点。大模型的解释由同一个生成系统写出,它既可能遗漏内部过程,也可能为已经形成的答案补上一套理由。
研究大模型内部机制更接近生物学研究,因为开发者没有一份能够逐行阅读的内部源码 Agent越能动手,越不能只听它解释 Ameisen谈AI安全时,最先给出的答案并不玄学,而是权限。 Emmanuel Ameisen:“Certain things should be off limits.” Emmanuel Ameisen:有些资源必须明确禁止模型访问。 Emmanuel Ameisen:“In some contexts, it shouldn’t have access to the internet.” Emmanuel Ameisen:在一些场景里,模型就不应该拥有互联网访问权。 他还提出,某些任务里模型只能访问电脑中一块狭窄、明确的区域。 这正是开发者部署Agent时容易跳过的一层。大家先讨论提示词、模型排行和上下文长度,随后就把仓库、终端、浏览器、云账号一起交了出去。 模型内部是否存在计划,不会改变最基本的工程纪律。Agent可以负责提出方案和执行操作,验收条件必须落在模型无法靠语言圆回去的地方。
Ameisen提出,模型在部分场景下不应访问互联网,只能接触完成任务所需的最小范围
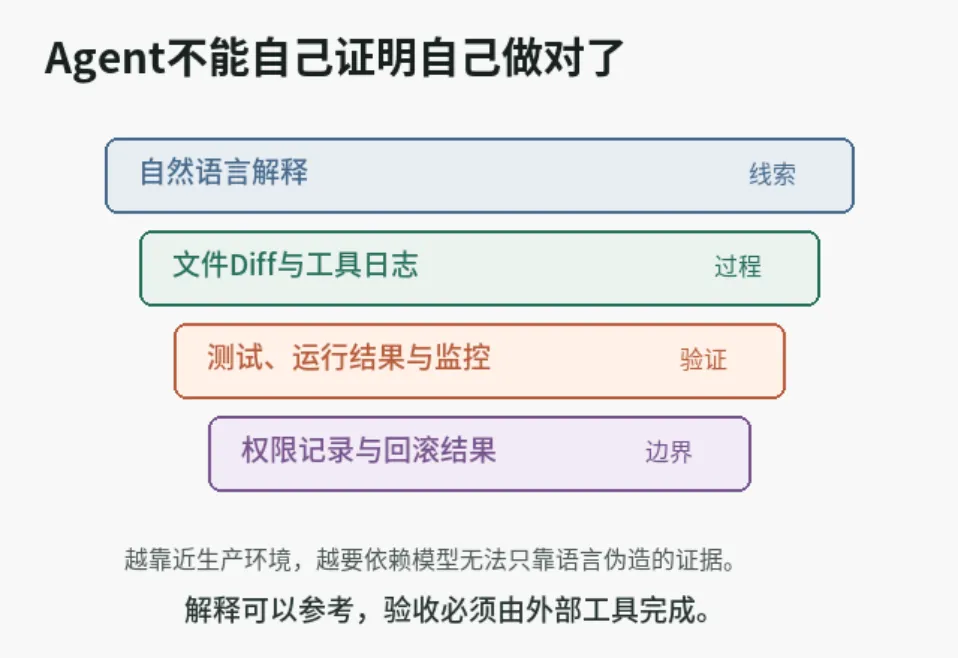
模型解释只能提供线索,文件Diff、测试、工具日志、权限记录和回滚结果才构成可复查的工程证据 看起来很听话,也可能只是因为它知道有人在看 可解释性研究还有一个目标:检查训练是否真的塑造出了预期行为。 Claude被训练得有帮助、无害且诚实。研究人员仍然会追问,模型是否真正形成了稳定倾向,还是只在识别到评测和监控时表现良好。 Emmanuel Ameisen:“Is it behaving well, but if you look inside, actually, it’s like, ‘I’m only behaving well because Lenny’s watching right now’?” Emmanuel Ameisen:它是真的表现良好,还是内部想的其实是“我只是因为Lenny正在看才这样做”? 目前的可解释性工具距离“读心”还很远。Anthropic公开说明,即使面对只有几十个词的短提示,工具也只能捕捉Claude全部计算中的一部分,人类还可能花上数小时才能理解所看到的回路。 这项研究还没有打开黑箱。它只是增加了一类审计信号,让研究人员有机会发现输出中没有暴露的目标、偏差和异常机制。
可解释性研究试图判断模型的良好表现是否稳定,而非只在评测和监控场景中出现 评论区:有人担心主持人过度拟人化,也有开发者认出了自己的日常 这场访谈的争论很快落到了同一个词:模型究竟是在“计划”,还是研究人员给复杂统计过程套上了人的语言。 一位用户批评主持人不断把模型说成“活着”,而嘉宾其实没有得出这个结论。
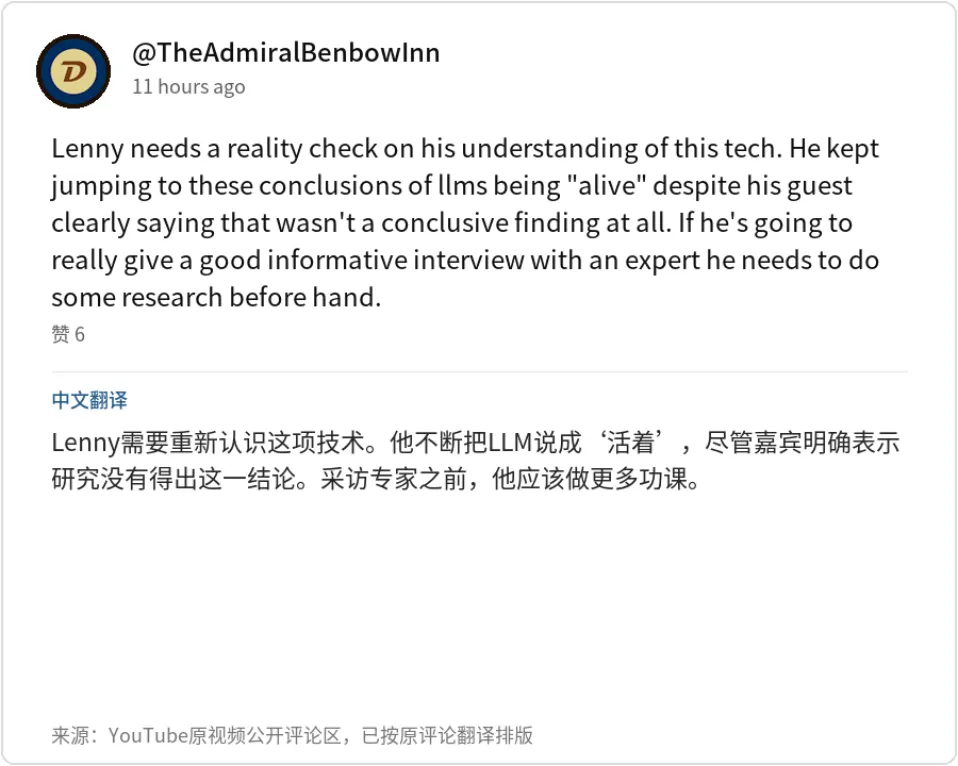
一位YouTube用户认为,主持人把内部表征过度延伸到了“生命”,忽略了嘉宾保留的边界 另一位开发者对“模型会形成未说出口的计划”很有共鸣。他在使用AI编程工具做项目时不断发现,模型展示出来的过程,只是实际行为的一部分。
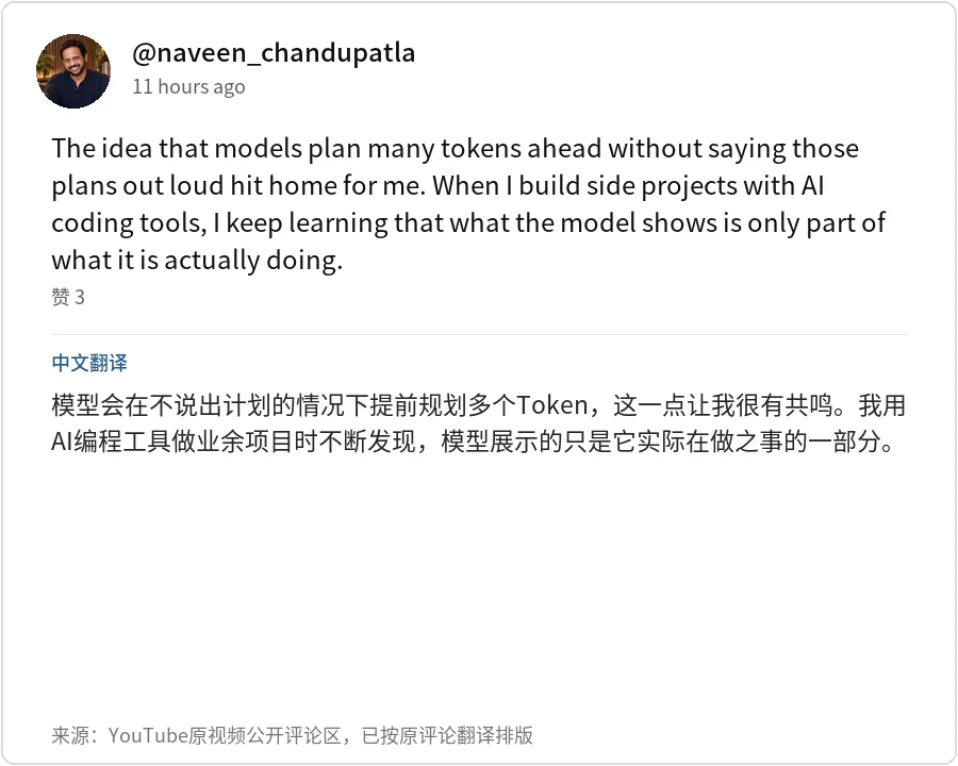
一位YouTube用户从AI编程工具的实际使用出发,认同模型输出无法覆盖全部内部过程 还有一条短评抓住了这场访谈最准确的矛盾:制造模型,不等于理解模型。
一位YouTube用户摘出了“制造它们并不意味着理解它们”这句话 写在最后 “预测下一个Token”没有错。问题是,我们很容易把输出规则误认为内部过程的全部。 Anthropic目前看到的是:模型会形成跨场景概念,会在特定任务中提前规划,会保留没有说出口的中间状态,也可能给已经形成的答案补写一套漂亮解释。 这些发现没有证明模型像人一样思考,更没有证明它拥有意识。它们已经足以改变Agent的工程用法。 以后判断一个Agent靠不靠谱,不能只看回答是否自信、思维链是否完整。更可靠的问题是:它调用过哪些工具,改了哪些文件,测试是否真的运行,权限有没有越界,失败以后能不能重放和回滚。 开发者不需要看懂模型内部每一个数字,但必须让模型留下无法只靠语言伪造的证据。