组学时代的法医遗传学
组学时代的法医遗传学 Manfred Kayser 摘要 近年来,法医遗传学(forensic genetics)的进展由技术创新以及不断扩大的核酸标记物应用所驱动,显著提升了从犯罪现场获取的人类生物痕迹中证据信息的范围、准确性和可靠性。这些生物标记物中的大多数是通过非靶向组学方法(包括基因组学、转录组学、表观基因组学和微生物组分析)鉴定出来的。此外,靶向大规模平行测序(在某些情况下也包括非靶向全基因组测序)正被应用于生物痕迹材料的分析。这些方法和技术被用于识别犯罪者(包括同卵双胞胎)、其亲属或犯罪活动的受害者;预测未知个体的表型和行为特征;以及确定痕迹特征,包括组织类型和沉积时间。 目录 引言 人员识别 外部可见特征识别 痕迹特征识别 结论 综述文章 作者将本文献给前遗传鉴定部门的同事们,以表彰他们在我们共同超过20年(从2004年作为法医分子生物学部门(Department of Forensic Molecular Biology)成立直至2025年因Erasmus MC生物医学科学重组而关闭)期间所共同实现的法医遗传学创新中所作的贡献。 引言 通过从犯罪现场收集的人类生物痕迹中建立证据信息以协助侦破刑事案件,有三个关键问题:谁干的?发生了什么?何时发生的?40年来,对血液、唾液、精液、阴道分泌物、毛发、皮肤及其混合物等痕迹材料中的核酸标记物进行分析,已被用于帮助解答法医遗传学领域的这些问题。对于第一个问题(谁干的?),重点仍然是通过DNA进行个体识别,主要包括在有已知嫌疑人案件中的痕迹捐献者,也包括犯罪活动中的受害者和来自不明人类遗骸的失踪人员,以及亲缘关系的确认。在无嫌疑人案件中,通过DNA预测外貌、生物地理祖先和年龄,以及基于DNA的亲缘搜索,有助于缩小警方调查范围以寻找潜在嫌疑人。第二个问题(发生了什么?)可通过核酸标记物确定痕迹的组织类型来回答。第三个问题(何时发生?)的解答可利用生物标记物估计痕迹在犯罪现场的沉积时间。值得注意的是,这些问题被研究的程度、它们可能被应用的案件数量以及它们是否确实被应用于法医实践,均有不同。 法医遗传学领域诞生于1985年,以Sir Alec Jeffreys发现的个体特异性多基因座DNA指纹及其首次应用于法医案件这一里程碑式发表为标志。随着聚合酶链反应(PCR)的出现,基于常染色体短串联重复序列(autosomal short tandem repeats,STRs,也称为微卫星)的法医DNA分型在20世纪90年代初取代了基于小卫星的DNA指纹技术,并至今仍是个体识别的金标准。20世纪80年代末的线粒体DNA分析以及90年代初的Y染色体STR(Y-STR)分析扩展了法医识别能力,特别是在无法获得常染色体STR图谱的案件中,并且还允许分别推断母系和父系生物地理祖先。基于常染色体单核苷酸多态性(single-nucleotide polymorphisms,SNPs)(最初在HLA基因中)的检测方法自20世纪80年代末起已被应用于刑事个案和失踪人员案件中的个体识别。 在过去二十年中,法医遗传学中应用的核酸标记物类型和数量持续增加。常染色体SNPs被用于从痕迹DNA中识别个体、预测表型特征和推断双亲生物地理祖先。RNA和DNA甲基化标记物被开发用于基于适合痕迹分析的技术来估计个体年龄。RNA、DNA甲基化和微生物DNA标记物被用于确定组织类型,并尝试估计痕迹的沉积时间。这些额外核酸标记物中的大多数是通过非靶向组学技术鉴定的,包括SNP微阵列、基因表达微阵列、DNA甲基化微阵列、全基因组测序(WGS)和全转录组测序,其中一些也直接用于痕迹分析。此外,靶向组学技术,如靶向大规模平行测序(massivelyparallel sequencing,MPS),正越来越多地应用于痕迹分析(框1)。这些及其他进展拓宽了可从人类犯罪现场痕迹中获得的法医信息的范围,并提高了其准确性和可靠性(图1)。 本综述概述了法医遗传学的最新进展,着重介绍了在犯罪者(包括同卵双胞胎)及其亲属个体识别方面的进展;接下来总结了在无嫌疑人案件中痕迹捐献者外部可见特征(如外貌特征、生物地理祖先、年龄及某些行为特征)的(表观)遗传预测方面的改进;此外,还提供了关于痕迹特征(如组织类型和沉积时间)测定的最新信息。在整个综述中,强调了基于核酸标记物的非靶向和靶向组学方法及技术的应用。 框1 | 法医遗传学中的靶向与非靶向组学 对于基于预先选定的、适合特定用途的离散标记物集合的法医应用,靶向组学最为合适。例如,靶向大规模平行测序(MPS)最适合用于个体识别的法医短串联重复序列分型,因为犯罪者DNA数据库的使用限制并规定了犯罪现场调查中应用的短串联重复序列标记物。对于法医DNA表型分析和法医组织识别,某些生物标记物的效应量大于其他标记物;因此,使用靶向MPS分析效应较大的生物标记物最为实用。某些靶向技术也比非靶向技术成本更低,具有经济优势。 靶向MPS技术相较于其他靶向DNA分析方法的一个主要法医优势是它们具有更大的多重检测能力,允许同时分析更多标记物。多重检测在法医遗传学中非常重要,因为证据材料通常有限,因此必须在一个反应中同时分析尽可能多的标记物。增加的多重检测能力也很重要,因为法医标记物集合正在扩大,以改进各种法医应用。此外,靶向MPS检测通常比非靶向检测具有更高的灵敏度,并且靶向MPS允许完全定量分析,这在某些法医应用(如基于DNA甲基化标记物的应用)中是必要的。然而,靶向MPS方法也存在多重检测能力限制,对于定量DNA甲基化分析而言,这种限制比定性短串联重复序列或SNP基因分型更为明显。 当通过靶向MPS方法获得的法医信息或其准确性有限,且可以通过使用超出技术多重检测能力的额外可用生物标记物来提高时,非靶向组学成为首选方法。根据法医应用的不同,非靶向组学技术可应用于质量及数量不受限制的参考DNA,或在痕迹质量和数量允许的情况下应用于痕迹DNA。非靶向组学技术的未来进步可能带来更高的灵敏度和/或更低的成本,这将使法医应用受益。 人员识别 识别犯罪现场发现的生物痕迹的捐献者是回答“谁干的?”问题的关键。痕迹DNA主要用于有嫌疑人案件中痕迹捐献者的个体识别,但在无嫌疑人案件中,或当所有嫌疑人通过法医STR分型被排除为痕迹捐献者时,它也可以提供调查线索以帮助寻找潜在嫌疑人。 个体识别 个体识别通过将犯罪现场痕迹获得的常染色体STR图谱与已知个体的参考STR图谱进行匹配,并为这种DNA匹配提供证据权重来实现[22,27]。在过去几十年中,法医DNA分型中使用的常染色体STR数量稳步增加,以达到非常高的个体识别证据标准。当前商业化人类识别试剂盒包含超过20个常染色体STR和用于推断生物学性别的DNA标记物。法医STR分型依赖于调查当局已知相关人员的STR图谱,该人员要么是案件嫌疑人,要么因先前定罪(在某些司法管辖区也因逮捕)而被纳入国家犯罪者DNA数据库。自三十年前首次建立以来,犯罪者DNA数据库已被证明是将痕迹STR图谱与可能的捐献者联系起来,或突出显示涉及同一捐献者的案件关联的有力工具。多年来,犯罪者DNA数据库中参考STR图谱的数量呈指数增长,数据库大小与找到匹配的机会成正比。根据普吕姆(Prüm)条约,29个欧盟成员国的法医数据库之间进行跨境STR图谱搜索。法医STR分型与犯罪者DNA数据库相结合,仍然是法医学中个体识别的支柱。 当前用于法医STR分型的商用仪器和化学品的灵敏度,使得能够从皮克级的痕迹DNA生成完整的STR图谱。这种高灵敏度导致了对接触物体的STR分型的关注,从而加强了对两个重要领域的研究:DNA转移和DNA混合物。二十多年前,触觉DNA(touch DNA)领域诞生于首次证明可以从物理指纹获得DNA指纹,以及DNA从一件物体向另一件物体的二次转移。多年来,对DNA的转移、持久性、普遍性和回收(transfer, persistence, prevalence and recovery of DNA,DNA-TPPR)的理解已大幅提高。DNA-TPPR有助于处理活动层面问题,即何种活动最可能导致一个人的DNA出现在犯罪现场。贝叶斯网络(Bayesian networks)已成为分析这些数据的首选工具,因为它们有助于以概率方式回答关于转移机制的问题。 通常,犯罪现场物体被多人触摸过,这需要分析DNA混合物的方法,混合物也可能由体液组合产生。解释混合STR图谱的挑战包括等位基因重叠、贡献不平衡以及由于少量次要贡献DNA导致的等位基因丢失(未观察到存在的等位基因)或等位基因插入(观察到不存在的等位基因),后者对于单源低量DNA样品同样相关。为了改进从混合DNA样品(包括低输入DNA)中获得的STR图谱的解释,已开发出概率分型方法,并应用于法医个案中,这些方法基于定性(半连续)模型(考虑插入和丢失)或定量(连续)模型(额外考虑信号强度(峰高)、PCR滑脱stutter和其他参数)。也在研究用于法医混合物反卷积(deconvolution)的替代DNA标记物,如用于男-女混合物的Y-STR;基于邻近常染色体SNP的微单倍型,避免了STR的PCR滑脱问题;或其他类型的复合DNA标记物如DIP-STR,将STR与附近的插入-缺失多态性配对。另一种不同方法是在法医DNA分型之前分离混合样品的细胞,已探索了不同技术,包括激光捕获显微切割和DEParray(MenariniSilicon Biosystems)。对单细胞的靶向DNA分析具有挑战性,因为二倍体人类细胞所含DNA量低(3.3 pg)。已使用更多的PCR循环和PCR添加剂来提高灵敏度,并应用概率分型从几个单细胞建立共有DNA图谱。最近,已探索非靶向单细胞测序,即单细胞转录组测序和单细胞DNA测序,用于基于SNP的混合物反卷积,随后进行生物地理祖先推断和分离贡献者的个体识别以及组织类型的鉴定。 大多数法医DNA实验室继续使用荧光多重PCR结合毛细管电泳对STR进行分型,尽管有些已转向靶向MPS(也有商业试剂盒可用)。由于其完全定量的性质,靶向MPS在混合物分析等方面具有优势(框1)。大多数法医所用STR的片段长度相对较短,使得短读长DNA测序适用,而长读长DNA测序对长片段法医STR有益,可增强混合物分析,并在组合不同标记物类型时提供其他优势。基因编辑技术最近已开始被探索用于法医STR分型;例如,STR-seq使用CRISPR-Cas9片段化DNA,以在不进行PCR扩增的情况下增加测序的STR数量。 男性识别 男性特异性Y-STR已在法医遗传学中应用超过三十年,特别是在无法生成常染色体STR图谱的案件中,如暴力或性侵犯案件中男-女混合物且女性受害者DNA大量过剩的情况(图2)。虽然差异裂解可以富集精子DNA,但概率分型软件和靶向MPS可以改善男-女混合物的反卷积。在无法从混合STR图谱中建立男性贡献者常染色体STR图谱的案件中,通常可以从混合痕迹中生成Y-STR图谱,特别是当通过包含人类男性DNA靶向特异性检测的DNA定量试剂盒在DNA提取物定量过程中检测到Y染色体DNA时。此外,痕迹中的精子细胞可能数量很少或没有,这妨碍了差异裂解;然而,Y-STR可以成功地对男性上皮细胞进行分析。与常染色体STR试剂盒一样,商业试剂盒中Y-STR的数量在过去几十年中有所增加,当前试剂盒中包含超过25个Y-STR。其中大多数为标准Y-STR,突变率相对较低(每个基因座每代约10⁻³),这使得这些试剂盒在识别男性谱系方面非常强大,但不适用于区分男性亲属和个体男性识别。 与常染色体STR不同,所谓的乘积法则(product rule)(将单基因座等位基因频率相乘来估计匹配概率)不能用于Y-STR,因为它们位于Y染色体的非重组区。在当前法医实践中,Y-STR匹配概率等同于从群体参考数据库获得的Y-STR单倍型频率,最著名的是公开可访问的Y-染色体STR单倍型参考数据库(Y-Chromosome STR Haplotype Refer enceDatabase,YHRD)。然而,原则上,且由于其在规模、地理覆盖范围和为避免亲属而进行的样本选择方面的限制,群体数据库不能被视为在每个个案中代表所有合理的替代嫌疑人。最近,开发了一种基于嫌疑人谱系估计Y-STR匹配概率的数学框架,避免了群体数据库的频率估计;相应的软件工具目前正在开发中。 从男性谱系识别向男性个体识别的转变是改进法医Y染色体分析的关键。在过去15年中,快速突变Y-STR(RM Y-STR)——其突变率比标准Y-STR高约十倍——被鉴定并开发为区分男性亲属的标记物。虽然商业Y-STR试剂盒仅包含少数RM Y-STR,但已开发出几种非商业RM Y-STR基因分型检测方法。当前最全面的工具RMPlex靶向30个具有较高突变率的Y-STR,包括目前已知的所有26个RM Y-STR。基于RMPlex的Y-STR分型实现了平均男性亲属分化率:父子为43%,兄弟为66%,堂表亲为76%,间隔≥6次减数分裂的亲属>95%,间隔≥12次减数分裂的亲属为100%。由于Y-STR突变率随重复次数增加而增加,某些RM Y-STR超出了短读长测序技术的最大读长,使得长读长测序对RM Y-STR分析具有吸引力。最近,WGS被应用于基于Y染色体的男性亲属区分,基于Y染色体单核苷酸变异(SNVs)观察到的父子分离率为58%,但此发现需要通过测序更多父子对来确认。基于Y染色体SNV突变率估计的预期男性亲属分化率为:父子69%,兄弟90%,堂表亲97%。转向长读长WGS有望进一步提高男性亲属分化率。 亲属识别 在无嫌疑人案件中通过所谓的家系搜索识别痕迹捐献者的亲属,可通过不同方法、标记物类型和技术实现。如果亲属被纳入国家犯罪者DNA数据库,则可通过常染色体法医STR分型识别亲属。然而,这种方法的成功仅限于相隔一两代以内的非常近的亲属,如亲子或兄弟姐妹关系。在男性痕迹捐献者案件中,如上所述,可通过大规模筛查中的Y-STR分析识别男性亲属,首先使用标准Y-STR进行男性谱系识别,如果观察到匹配,则随后进行RM Y-STR分析以区分近亲和远亲(图2)。在一些国家,Y-STR图谱被纳入犯罪者DNA数据库,从而可以通过数据库搜索进行男性亲属识别。 为了克服法医常染色体STR在家系搜索中的标记物局限性,开发了基于数千个常染色体SNP的工具,使用带或不带捕获富集(capture enrichment)的靶向MPS,并已开始应用于法医实践中的家系搜索和失踪人员识别。此外,如果痕迹DNA质量和数量足够高,非靶向基因组学方法如WGS或SNP微阵列可用于寻找远至三代表亲甚至更远的亲属(如果他们被纳入基因组数据库)。这可以通过DNA驱动的家谱研究提供调查线索,该过程称为调查遗传谱系学、法医遗传谱系学或法医调查遗传谱系学。由于这些消费者DNA数据库并非为法医目的而建立,专有公司对其客户实施了选择加入或选择退出程序,以规范执法机构的访问;相反,一些消费者基因组学公司根本不允许法医应用。根据Mendeley数据库,迄今为止已有数百起案件通过此方法解决,大多数在美国(这些公司总部所在地且大多数客户居住于此),但也在其他国家如瑞典和挪威。由于输入DNA质量和数量差会在SNP微阵列数据中产生错误,这可能影响下游应用如亲属识别,因此基于合适的DNA质量和数量仔细选择痕迹样品至关重要。 同卵双胞胎识别 同卵双胞胎通常共享相同的法医STR图谱;因此,在涉及一个或两个同卵双胞胎的刑事案件中,STR分型无法提供信息。已在法医背景下研究了多种分子方法用于同卵双胞胎区分;其中基因组和表观基因组方法最为显著。在两种方法中,均使用非靶向组学在两个双胞胎的参考DNA中鉴定双胞胎区分性DNA标记物,随后使用靶向方法(如靶向MPS)在痕迹DNA中进行分析。 基因组学方法已成功应用于多个法医案件,其基础是在受精卵或胚胎发育早期阶段发生的体细胞突变(通常为常染色体SNVs)。因此,突变等位基因存在于一个双胞胎中而不存在于另一个中。双胞胎区分性SNV的数量因对而异。例如,对381对同卵双胞胎的深度测序研究表明,他们平均有5.2个早期发育突变差异,且15%的双胞胎对中其中一个双胞胎具有相当数量的特异性突变。这些突变可能并非存在于所有细胞和所有组织中(体细胞嵌合体),因此其鉴定需要超深度WGS(例如,100×覆盖度)。此外,取决于参考DNA和痕迹DNA的细胞类型,在参考DNA中鉴定的突变等位基因可能不存在于痕迹DNA中。根据痕迹组织类型选择参考样品的组织类型可以避免此问题,但如果参考材料受法律监管,则可能带来挑战。如果双胞胎区分性突变产生了一个额外的SNV等位基因——即一个双胞胎纯合而另一个杂合——则在参考和痕迹DNA中的检测是直接的。如果突变产生了不平衡杂合子,即两个双胞胎均杂合但主要等位基因相反,则鉴定需要对WGS数据进行专门的生物信息学分析,并且在痕迹DNA中检测突变等位基因需要适合定量SNP分析的靶向方法,如靶向MPS。最近报道的一个双胞胎案例展示了基因组学方法的成功,尽管案件情况和痕迹材料带来了各种挑战。 在表观基因组学方法中,通过量化两个双胞胎之间的DNA甲基化差异来实现同卵双胞胎区分。对两个双胞胎的参考DNA样品进行DNA甲基化微阵列分析,以鉴定双胞胎区分性CpGs,然后使用靶向方法(如靶向MPS)在痕迹DNA中进行研究。由于方法间偏差,可用于痕迹DNA分析的双胞胎区分性CpGs数量通常少于参考DNA样品中鉴定的数量,这已在不同组织类型中得到证实。由于DNA甲基化模式可能因组织而异,匹配痕迹和参考样品的组织类型非常重要。理论上,表观基因组学方法可以在每一对同卵双胞胎中鉴定出双胞胎区分性标记物,这与基因组学方法不同。然而,在实践中,几个因素使得表观基因组学方法在法医个案中不如基因组学方法有吸引力(前提是能承担超深度WGS的高昂费用)。这些因素包括定量CpG分析中的技术噪声、对更多痕迹DNA进行亚硫酸氢盐转化的需求及由此产生的DNA降解,以及DNA甲基化变异在不同组织间的差异。未来,适用于大多数(即使不是全部)同卵双胞胎对的通用双胞胎区分性CpGs,连同适合痕迹分析的靶向方法,可能会改变表观基因组学方法的前景。此类CpGs存在的迹象是发现了数百个CpGs,其在无关个体中的变异程度与在同卵双胞胎中一样大。 外部可见特征识别 预测痕迹DNA捐献者的外貌、生物地理祖先、年龄和某些行为特征——这一过程称为法医DNA表型分析(forensic DNA phenotyping,FDP)——在无嫌疑人刑事案件中具有相关性,通过提供调查线索,FDP可帮助通过有针对性的警方调查找到潜在嫌疑人。FDP通常需要两个部分:基于适合痕迹分析技术的法医验证DNA工具,用于分析预测性DNA标记物;以及基于已验证统计预测模型的预测工具。为增加其有效性,FDP可与其他调查性DNA分析相结合。例如,根据其预测结果在人群中的稀有程度,FDP可以减少受邀参与家系搜索的自愿DNA大规模筛查的人数。这种组合方法已用于解决悬而未决的强奸和谋杀案,例如在荷兰[93]。FDP是一种调查性方法;痕迹捐献者的最终识别始终通过法医STR图谱匹配完成。 外貌预测 在过去15年中,从痕迹DNA预测眼睛、毛发和肤色以及皮肤颜色的科学技术已完全建立,并在许多国家的法医个案中得到应用[92]。尽管所有外貌特征在遗传上都很复杂,涉及数百个或更多基因,但色素沉着特征已与少数效应量增大的基因相关联,这些基因含有预测能力增强的SNPs。因此,通过少量SNPs即可实现眼睛、毛发和肤色的DNA预测,其中大多数是在全基因组关联研究(GWAS)中鉴定的,例如,眼睛颜色6个SNPs[94,95],毛发颜色22个[96,97],肤色36个[98,99]。基于这些SNP集合在数千名个体中建立的统计预测模型,以受试者工作特征曲线下面积(AUC)表示的分类预测准确度分别为:眼睛颜色0.74-0.94[95,99],毛发颜色0.72-0.92[97,99],肤色0.72-0.96[99]。最初的DNA工具用于眼睛、毛发和肤色预测基于引物延伸和毛细管电泳[95,97,100-102];而近年来,已开发出靶向MPS检测方法并正在应用[102,103]。两个基于DNA的眼睛、毛发和肤色预测网页工具已公开可用,并用于法医个案(和人类学研究):HlrisPlex-S和Snipper。HlrisPlex-S允许上传在痕迹DNA降解时遇到的局部SNP图谱。 最近,基于非靶向基因组学方法鉴定的不断增加SNP数量的增强型毛发和眼睛颜色预测模型已被引入。对于毛发颜色,在大型GWAS中发现的超过250个SNPs[104]改善了预测,但与18个HlrisPlexSNPs相比,AUC仅小幅增加0.01-0.08[70,104]。对于眼睛颜色,通过全外显子组测序部分鉴定的超过100个SNPs改善了中间眼睛颜色的预测,AUC为0.85(参考文献105),而6个lrisPlexSNPs达到的AUC为0.74[95,99]。预测模型也已开发用于其他色素沉着特征,如雀斑(AUC 0.66-0.79,参考文献106),眉毛颜色(0.62-0.7,参考文献107)和头发灰白(0.79-0.87,参考文献108),但其中大部分预测仅由年龄提供。迄今为止,尚未提供适合痕迹分析的DNA工具和公开可访问的预测工具用于这些标记物和模型。 非色素沉着外貌特征的遗传预测需要更多SNPs才能准确预测。然而,目前仅有身高的GWAS数据充足。因此,非色素沉着外貌特征的预测准确度目前低于色素沉着特征。例如,基于>30个SNPs的头发形状模型和基于>100个SNPs的男性型秃发模型的AUC分别为0.59-0.68(尽管在非欧洲人中更高)和0.6-0.73[109,110],其他毛发特征的AUC同样较低[111]。对于极高身材,基于689个SNPs的模型AUC为0.79(参考文献112)。对于这些额外特征,起初并未提供适合痕迹分析的DNA工具和公开可访问的预测工具。目前,最全面的且经法医验证的用于从痕迹DNA预测外貌(和祖先)的系统是基于MPS的VISAGE增强型外貌与祖先工具,用于分型524个SNPs,及其相应的预测工具VISAGE软件,两者共同实现了基于先前建立的眼睛颜色、毛发颜色、肤色、眉毛颜色、雀斑、头发形状和男性脱发等七个外貌特征的预测模型,以及祖先预测(图3)。大多数遗传外貌预测模型基于逻辑回归;机器学习方法已被探索,但迄今尚未提高预测准确度,大概是由于SNP预测因子数量较少。 对于许多外貌特征,GWAS中鉴定的相关SNPs解释的表型变异太小,如耳形态[115]或面部形状形态[116]。目前最大的面部形状GWAS鉴定了253个独立相关SNPs,解释了2.35-7.90%的表型变异,并提供了首个基于382个面部相关SNPs的多基因风险评分的鼻形初步预测模型[117]。需要对更多外貌特征进行更大规模的GWAS,随后进行改进的预测研究,以进一步增加法医实践中可DNA预测的外貌特征数量。未来对人类外貌遗传理解的进展可能最终导致从当前的分类特征预测转向连续特征预测,以及从当前使用靶向MPS分析选定SNPs的遗传预测转向使用微阵列或WGS分析全基因组SNPs的基因组预测。基因组预测已基于微阵列分析的20,000-100,000个SNPs在正常身高上得到证明,测量身高与预测身高之间的相关性值超过0.6(参考文献118)。一种中间方法是使用基于大量显著相关SNPs的多基因风险评分进行特征预测,这广泛应用于临床相关复杂特征[119],并已开始用于外貌特征如毛发颜色[120]和面部形状[117]。然而,基于多基因风险评分的特征预测存在局限性,原因是GWAS鉴定SNPs的次要等位基因频率与效应量之间的关系[121]。 祖先预测 推断生物地理祖先,即生物学(遗传)祖先起源的地理区域,是FDP的相关组成部分,因为生物地理祖先具有调查价值。其进一步相关的原因是,某些可DNA预测的外貌特征(例如,棕色眼睛、黑色头发和浅色皮肤)遍布跨越几个大陆的大地理区域,可通过遗传祖先检测进行细分,从而细化并改进调查信息。 传统上,生物地理祖先分别从父系和母系方面使用Y染色体和线粒体DNA SNPs进行遗传推断。在过去十年中,已开发出用于同时分型数百个Y染色体SNPs[122,123]以及整个线粒体基因组[124,125]的靶向MPS检测方法。这些分型工具和相应软件允许对Y染色体和线粒体DNA单倍群进行高分辨率推断,用于父系和母系谱系识别[126]。许多单倍群具有明显的空间频率分布[127],提供不同地理层面的祖先信息[9]。 与Y染色体和线粒体对应物不同,常染色体SNPs可以区分近期和远祖祖先,并且可以量化混合血统个体的祖先比例[15]。最初基于少量SNPs,近年来基于数百个常染色体SNPs的法医祖先工具使用靶向MPS开发——有些与Y染色体SNPs、外貌预测性SNPs、微单倍型和X染色体SNPs相结合。这些工具能够在五到七个全球地理区域层面进行双亲祖先推断。 过去十年中,检测遗传群体亚结构( genetic population substructure)的方法和软件也取得了进展[129]。当这些工具用于推断个人的生物地理祖先时,需要群体参考数据,例如通过网页应用如Snipper[130]。法医从业人员可用的群体参考数据集在样本量和全球覆盖范围方面的局限性,是法医祖先检测的一个限制。另一个限制来自法医祖先工具中相对较少的SNP数量,这是由适合法医痕迹分析的分型技术的有限多重检测能力所致。由于常染色体SNP数量与所揭示的祖先信息之间呈正相关,法医祖先工具提供的祖先信息详实程度低于SNP微阵列或WGS[23,131]。 此外,人类DNA甲基化的人群特异性已被报道[132,133]。虽然注意到DNA甲基化的人群特异性变异与SNP变异之间存在强烈对应关系[133],但在具有共同遗传背景但居住在不同生境的人群中也发现了DNA甲基化差异[134],表明环境因素对DNA甲基化变异的影响。此外,多项研究表明微生物组分析适用于推断人类地理位置,即居住或成长地区[135]。来自不同大陆和国家的人群之间肠道微生物组多样性和组成的显著差异已被报道[136],并且对法医相关的毛发、皮肤和口腔微生物组的首批研究调查了基于微生物组的人群在国家之间[137]和国家内部地区之间[138]的区分。病毒DNA已开始被用于推断地理位置,并与遗传生物地理祖先检测相结合[139]。未来可能会更多地结合使用遗传祖先检测和基于表观基因组及微生物组的检测进行地理位置推断。这将增加关于个人居住地区的地理信息,以及其祖先居住地区的信息。 年龄预测 估计一个人的年龄是FDP的另一相关组成部分,因为年龄描述了一个人,因此具有调查价值。此外,某些外貌特征受年龄强烈影响,因此年龄估计是外貌预测模型所需的输入。在过去十年中,已开发出称为表观遗传时钟的机器学习工具,可以根据数百到数千个CpGs的甲基化状态估计个体年龄[140]。第一代表观遗传时钟[141-143]通过将实际年龄与选定CpG位点的DNA甲基化进行回归训练,提供比第二代表观遗传时钟和第三代表观遗传时钟更准确的实际年龄预测,后者使用临床衰老指标训练,更能指示生物学年龄[144]。 然而,许多犯罪现场痕迹中的DNA质量和数量不足以进行用于表观遗传时钟的可靠DNA甲基化微阵列分析。因此,已基于适合痕迹DNA的技术(包括靶向MPS)以及基于先前通过DNA甲基化微阵列鉴定的CpG标记物,开发了用于实际年龄预测的工具[1792]。鉴于其多重检测限制以及亚硫酸氢盐转化后DNA复杂性的降低,法医年龄估计工具通常基于少量CpGs(几十个或更少)[16,17,145]。它们已开发用于各种法医相关组织,如血液、唾液、毛发、骨骼、牙齿和精液,其中大多数提供的年龄估计平均误差为3-5年[146]。可以开发跨组织工具,但需要使用组织特异性预测模型[147]。由于亚硫酸氢盐转化和DNA甲基化变异的定量性质,基于DNA甲基化的法医年龄工具需要更多的输入DNA(数十纳克),远超法医STR或SNP分析所需的量(皮克级)。使用低于方法灵敏度阈值的输入DNA将降低DNA甲基化测量的准确性,对年龄预测产生负面影响[148]。 方法间偏差为开发适用于法医DNA工具产生数据的年龄预测统计模型带来了挑战。这可以通过应用数据归一化方法[149]或使用法医DNA工具生成模型数据[147,150]来克服。由于可用资源有限,使用法医DNA工具生成的预测模型通常受限于样本量小,导致所获年龄预测的可靠性未知。其他不确定性来自可能影响基于DNA甲基化的年龄预测的外部和内部因素,如某些疾病和物质摄入(如酒精)[2]等因素[146]。年龄预测模型通常基于回归分析,但也使用其他方法[17]。 近期的进展旨在增加可通过靶向技术分析的年信息性CpGs数量。基于扩增子测序的靶向MPS已证明可用于161个CpGs,涵盖四个表观遗传年龄模型的标记物,输入DNA低至25 ng[149]。使用单分子分子倒置探针的基于捕获的靶向MPS已应用于超过500个年龄相关CpGs,但仅一半在低至100 ng输入DNA时给出了足够结果[153]。用于DNA甲基化分析的纳米孔自适应测序已应用于数百个年龄相关基因(以及其他用于体液识别),但需要大量输入DNA[154]。此外,酶促转化作为亚硫酸氢盐转化的替代方法已被测试,改善了多重检测能力,但在灵敏度上并未优于亚硫酸氢盐转化[155]。 其他类型的核酸标记物也被探索用于年龄预测。基于特定T细胞DNA重排(sJTREc)的定量PCR检测显示与实际年龄高度相关,标准误差为9年[156]。来自非靶向RNA测序(RNA-seq)或表达微阵列数据的基于转录组的衰老时钟提供的年龄预测平均误差为6-8年[157,158]。通过靶向MPS使用数百个mRNA标记物[159]或少量microRNA或circular RNA标记物[160]也实现了类似的年龄预测误差。这些误差约为大多数基于DNA甲基化的法医年龄预测系统的两倍。对sJTREc、端粒长度、mRNA和DNA甲基化的比较研究表明,DNA甲基化标记物在年龄信息方面最为丰富[161]。 将实际年龄预测与面部年龄预测相结合在FDP背景下是可取的,因为有些人的面部看起来比其实际年龄明显年轻或年长。一项关于感知面部年龄(看起来多大)的GWAS鉴定了显著相关SNPs,但效应较小(看起来大2岁)[162]。一项关于感知年龄的全表观基因组孟德尔随机化研究强调了超过1,000个潜在因果CpGs[163],为开发面部年龄预测工具提供了靶点。第二代表观遗传时钟VisAgeX基于微阵列数据实现了面部年龄预测,平均误差为6.5年[164]。第三代表观遗传时钟DunedinPACE从微阵列数据量化衰老速度[165];该模型预测一个人是否比预期衰老更快或更慢,这可能在面部可见也可能不可见(图3)。未来的进展将证明是否可从痕迹DNA实现准确可靠的面部年龄(表观)遗传预测。 环境习惯预测 极明显的行为特征在FDP背景下可能具有信息价值。基于个人与环境互动的各种可见习惯会在分子水平留下足迹,特别是在甲基化组中[166]。基于全表观基因组关联研究中鉴定的小量CpGs的血液中吸烟表观遗传预测研究显示AUC接近和高于0.9(参考文献167-169)(图3)。吸烟的一些(但非全部)DNA甲基化标记在戒烟后逆转,因此可以预测既往吸烟史,尽管准确度低于当前吸烟者和非吸烟者的预测[167,169]。已基于法医适用技术(包括靶向MPS)开发了用于吸烟预测的法医DNA检测[170,171]。吸烟也影响口腔微生物群,几种细菌物种在唾液中的丰度因吸烟状态而显著差异[172]。一种无分类学依赖的微生物组吸烟预测方法AUC为0.81(参考文献173)。 对于饮酒,最初报道了极高的AUC值0.90-0.99(参考文献174),但后来发现是高估[175]。基于5-144个CpGs的模型对重度及高风险饮酒者与轻度及非饮酒者的AUC约为0.65(参考文献175)(图3)。近期报道仅使用三个CpGs的模型获得了更高的AUC 0.77-0.80,但基于小样本量[176]。其他物质摄入导致的DNA甲基化变化也有报道[177]。关于大麻使用[178,179]或注射药物使用[180]的全表观基因组关联研究鉴定了少量显著相关CpGs,解释的表型方差比例很小,例如终身大麻使用为3.8%[178]。因此,目前考虑将非法药物的表观遗传预测用于FDP应用尚为时过早。其他可见习惯如体育锻炼和饮食也会改变甲基化组[181,182]。未来,更多涉及环境互动的可见习惯可能会变得可通过DNA甲基化预测,这将需要讨论在社会责任范围内的法医应用(框2)。 框2 | 组学法医应用中的伦理问题 非靶向组学技术的法医应用产生的数据远多于回答给定法医问题所需的数据。此外,如果法律限制了可从痕迹中生成的痕迹捐献者(表观)遗传信息,那么将非靶向组学应用于痕迹意味着生成的信息超过法律允许的范围。然而,存在生物信息学解决方案,可以确保仅提取和使用非靶向数据中的靶向部分,而其余数据不被触及。非靶向组学数据的靶向生物信息学分析在法医领域之外已广泛建立。对从痕迹获得的非靶向组学数据应用靶向生物信息学解决方案,以确保仅使用在现有法律框架内回答给定法医问题所必需的数据部分,有助于缓解非靶向组学技术的法医应用可能引发的伦理或法律问题。然而,仍存在开放性问题,例如在提取法医相关靶向数据后,如何处理非靶向原始数据。例如,是否应销毁它们,以及是否应对它们给予与法医遗传学中靶向DNA数据同等的数据保护和数据安全关注? 原则上,外部可见特征不能被视为私人信息。外部可见性大多适用于外貌特征、大陆级别生物地理祖先和年龄范围。然而,个人可能人为地改变其自然外貌(例如使用有色隐形眼镜、染发或接受整容手术,这也可能改变可见年龄),以刻意隐藏其自然外貌,在此情况下此类特征可被视为私人信息。然而,在这种情况下预测自然特征将毫无用处,因为无法使用DNA预测的自然特征结果来追踪该人。此外,混合大陆祖先可能在家族中混合事件的时间和复杂性不同时在外部不可见,这则被视为私人信息。对于基于环境互动的行为习惯,外部可见性并非理所当然。根据习惯、社会惯例或立法,个人可能有理由私下实践此类习惯并将其对公众隐藏,在此情况下该习惯将被视为私人信息。例如,对于大多数吸烟者,他们的吸烟习惯在公共场合可见;因此,在FDP背景下对吸烟的表观遗传预测在隐私保护方面可能不被视为有问题。相比之下,非法药物使用者可能只在私下消费;因此,一旦基于已验证的科学和技术成为可能,在FDP背景下对非法药物消费的表观遗传预测可能会引起隐私保护方面的伦理困境。需要就(表观)遗传预测表型特征、祖先、年龄和基于环境互动的习惯在法医个案中的社会责任性应用,以及非靶向组学在法医中的总体使用进行广泛讨论。该讨论需要考虑社会对打击和预防犯罪的利益,以及个人减少创伤和不确定性、为幸存者、受害者、家庭和社区带来解决方案的利益,与通过治理和系统性样本和数据安全保护隐私和人权的个人及社会利益之间的平衡。 痕迹特征识别 通过法医STR分型确定了最可能的痕迹捐献者,不一定能回答法医案件中的罪责问题。额外的痕迹分析可帮助法院决定经DNA识别的痕迹捐献者是否为犯罪者。确定痕迹的组织类型可以揭示导致痕迹沉积的活动。估计痕迹沉积时间可用作分子不在场证明。 痕迹组织类型测定 传统上,化学、化学发光、免疫学、光谱学和显微镜检测用于法医鉴定体液如唾液、精液或血液[183]。然而,大多数这些检测是推定的,即它们能指示体液的可能存在,但其他物质也可能产生阳性检测结果。因此,法医遗传学界开发了基于核酸的标记物和工具,用于确定血液、月经血、唾液、精液、阴道分泌物和皮肤等痕迹的组织类型,这些已由专门实验室常规应用于法医个案[19](图4)。为此,使用了多种类型的核酸标记物,包括mRNA[186]、microRNA[184,185]、DNA甲基化[186,187]和DNA拷贝数变异[188](图4);其中,基于mRNA的工具目前最为成熟[189,190]。使用RNA(尤其是mRNA)的一个关键问题是痕迹降解对RNA完整性的影响,这需要实证证明所考虑的RNA标记物不受RNA降解影响[191,192]。 由重叠人类细胞类型构成的组织给人类生物标记物的鉴定带来了挑战,但可以通过微生物组分析进行区分。微生物16S核糖体RNA(rRNA)基因测序(越来越多地通过靶向MPS进行)已被用于区分和分类来自不同身体部位的上皮细胞[193]和来自不同身体来源的血液[194],预测准确度高(AUC超过0.97)。从标记物分析结果推断组织类型可基于标记物存在与否、丰度量化的似然比或贝叶斯网络进行[195,196,197]。根据已鉴定的组织类型,活动层面评估可通过估计似然比来区分不同法庭参与者(例如对抗制司法系统中的控方和辩方)提出的活动,从而识别最可能将痕迹置于犯罪现场的活动[198]。 近期的进展旨在处理多人混合痕迹,尝试将组织类型与痕迹捐献者联系起来(图4),为此使用位于组织指示性mRNA或CpG标记物扩增子中的SNPs。由于这些片段短(几百个碱基对),SNP数量少(例如,每个mRNA标记物用于不同体液有1-4个SNPs[197],或每个CpG标记物用于精液有1-2个SNPs[198,199])。如果每个扩增子鉴定出多个SNPs,它们处于高度连锁不平衡,这降低了个体识别的证据强度。通过靶向长读长测序扩展组织指示性mRNA或CpG标记物周围的序列可能提供解决方案,但这将取决于痕迹的RNA或DNA质量和数量。 痕迹沉积时间估计 估计痕迹被置于犯罪现场时间的一种方法需要基于痕迹离体状态的分子解决方案。这已通过差异RNA降解进行研究,要么通过随时间降解速率不同的RNA标记物——例如rRNA更稳定,而某些mRNA标记物稳定性较低[200,201]——要么通过RNA标记物内不同扩增子,这些扩增子因其在转录本中的位置或片段长度而以不同速率降解[202,203]。例如,基于不同大小的mRNA扩增子,可将血痕分为三个年龄组(新鲜、6天内、超过6天)[203];此外,使用不同间距的PCR引物,血痕定时的准确性据报道在储存少于6个月的样品中为2-4周,较老样品为4-6周[203]。最近,这一问题通过转录组测序重新研究,鉴定了大量稳定和不稳定转录本[204],并将样本分为四个年龄组的AUC高达0.99[205]。由于除时间外的环境因素(如温度和湿度)也影响RNA降解,将此类测试应用于环境条件未知或波动(如户外犯罪)的痕迹具有挑战性。此外,样品储存时间内微生物多样性、丰度和演替的变化已使用16S rRNA靶向MPS或非靶向RNA-seq进行研究。许多细菌目被发现在储存时间延长时丰度变化或出现/消失[206-209]。基于少数细菌预测样品年龄的遗传模型实现了数天的平均误差[207,208]。这些方法均尚未达到法医个案应用水平。 另一种方法是根据样品留在犯罪现场时身体的体内阶段来估计一天中的时间。这可通过具有昼夜节律或至少日间节律的生物标记物进行研究,这些标记物的浓度在昼夜周期中受生物学调控。将昼夜节律生物标记物用于法医痕迹沉积时间定时的首次证明使用了两种昼夜节律激素——褪黑素和皮质醇[210]。时钟基因的mRNA标记物也已测试,并在24小时周期内收集的血液样本中进行了全面的代谢物调查[211]。基于所有三种类型(激素、mRNA、代谢物)中时间信息最丰富的生物标记物,预测模型对三个日/夜时间段给出的AUC在0.8到0.96之间[211]。基于mRNA的模型平均误差为4小时[212]。最近,这一问题通过非靶向和靶向RNA-seq在24小时周期内收集的血液样本上重新研究,揭示了超过80个表达显著差异的mRNA标记物[213]。对一天内收集的血液样本中近70个mRNA标记物进行靶向MPS并基于模型进行时间估计,实现了约4小时或更长的平均预测误差[214]。在昼夜周期中波动的DNA甲基化标记物也可能对此目的有用[215]。然而,所有当前可用的模型均严重效能不足,因为纳入的个体数量少,且同一样本内不同时间点存在样本依赖性。此外,需要证明所用生物标记物(特别是mRNA)不受痕迹降解影响,如褪黑素已证明[210]但其他标记物尚未。这些方法均尚未达到法医个案应用水平。 结论 在过去二十年中,法医遗传学领域在其所有子领域均取得了显著进展,这主要得益于基于核酸的组学方法和技术,预计这一趋势将在未来持续。需要科学发展以识别更多用于现有和新型法医应用的生物标记物,以进一步增加可从犯罪现场痕迹中获得的法医信息的内容、可靠性和准确性。需要技术进步以改进靶向和非靶向组学技术,以应对不断增加的法医生物标记物类型和数量,以及生物痕迹有限的质量和数量。未来多组学工具的开发可能允许结合不同组学技术并将其应用于有限的痕迹样品(最好是单细胞),以并行回答不同法医问题。随着我们从法医遗传学走向法医多组学,将基于核酸的组学方法与基于其他类型分子生物标记物的组学方法(如蛋白质组学(已开始用于法医组织识别)、代谢组学(已开始用于痕迹沉积时间估计)和糖组学(已开始用于年龄预测))相结合,可能进一步改进犯罪现场调查中“谁干的?”、“发生了什么?”和“何时发生的?”的回答。 尽管法医遗传学研究成果具有直接且显著的社会效益,但其进展受到严重资金不足的极大阻碍。在许多国家,没有或只有非常有限的途径申请法医遗传学研究经费,因为合适的资助项目已不复存在或从未存在过。此外,在过去几年中,一些大学(特别是欧洲)已缩减其法医遗传学研究活动,这尤其关键,因为政府法医机构(除极少数例外)无法开展能带来突破性创新的那种法医遗传学研究。为确保法医遗传学进展及其社会效益的持续,政府必须为法医遗传学研究提供更好的资助机会,大学也必须恢复其支持法医遗传学研究能力的社会责任。 词汇表 受试者工作特征曲线下面积(Area under the receiveroperating characteristic curve,AUC):一种衡量预测模型性能的指标,基于图形表示即受试者工作特征曲线,该曲线在不同阈值设置下绘制真阳性率(灵敏度)与假阳性率(特异度)的关系;AUC为0.5表示随机预测,1.0表示完全准确预测。 贝叶斯网络(Bayesian networks):一种概率图模型,用于可视化变量及其关系;在法医学中,用于推理从案件证据信息中得出的不确定结论。 生物地理祖先(Biogeographic ancestry):一个人的生物学(遗传学)祖先起源的地理区域。 生物痕迹:犯罪现场遗留的任何(包括少量或残余的)任何类型(人类)生物材料,在犯罪现场调查中被收集并用于分析。 亚硫酸氢盐转化(Bisulfite conversion):用亚硫酸氢盐处理DNA,导致未甲基化的胞嘧啶脱氨基成为尿嘧啶,在后续分析中检测为胸腺嘧啶。相比之下,甲基化胞嘧啶对脱氨基具有抗性,保持为胞嘧啶,从而允许对CpGs的DNA甲基化变异进行定量分析。 捕获富集(Capture enrichment):富集预先选择的DNA靶标的过程,例如通过探针杂交,随后通过大规模平行测序技术进行序列分析。 DNA指纹(DNA fingerprints):基于多基因座小卫星重复序列的高度可变DNA模式,在多人(同卵双胞胎除外)中发现的概率极低。 DNA匹配(DNA match):两个法医DNA图谱在每个分析DNA标记物的每个基因型上完全一致,一个来自痕迹,另一个来自已知个体的参考DNA,从而允许识别痕迹捐献者;或两个来自不同痕迹,从而允许在同一刑事案件内或不同刑事案件之间将来自同一捐献者的痕迹联系起来。 表观遗传时钟(Epigenetic clocks):从DNA甲基化数据和衰老参数训练的机器学习算法,用于估计个体的生物学年龄,其中一些可近似实际年龄。 法医DNA表型分析(Forensic DNA phenotyping,FDP):对痕迹进行DNA分析,以预测痕迹捐献者的外貌、生物地理祖先和年龄,旨在提供调查线索,以帮助在无已知嫌疑人的案件中查找未知犯罪者。 法医DNA分型(Forensic DNA profiling):生成DNA图谱(最常基于多基因座短串联重复序列,即STR分型),并将其与个人参考DNA进行比较。如果分析了足够多的STRs(如当前法医实践所做),完整STR图谱的匹配表明在多人(同卵双胞胎除外)中发现的概率极低。 遗传群体亚结构(Genetic population substructure):一个群体内不同亚群(如按地理定义的亚群)之间等位基因频率的系统性差异。 孟德尔随机化(Mendelian randomization):分析(表观)遗传数据以研究可改变暴露对影响不同结局的因果效应的方法。 PCR滑脱(PCR stutter):在PCR(聚合酶链反应)过程中因DNA聚合酶在重复序列扩增时发生DNA链滑动(也称为滑脱伪影)而产生的人工STR等位基因,其重复长度与真实等位基因不同。 乘积法则(Product rule):将所有分析DNA标记物的每个基因型频率相乘,以估计DNA图谱频率(也称为随机匹配概率或随机匹配的机会),仅适用于遗传上不连锁且完全独立遗传的常染色体DNA标记物。 单核苷酸多态性(Single-nucleotide polymorphisms,SNPs):单个DNA位置的变异,多为单碱基替换,但也包括单碱基缺失或插入,有时用于群体频率超过1%的变异。 单核苷酸变异(Single-nucleotide variants,SNVs):单个DNA位置的变异,多为单碱基替换但也包括单碱基缺失/插入,通常用于没有特定群体频率的变异,多用于罕见变异。 触觉DNA(Touch DNA):对少量生物材料(通常为皮肤细胞)进行DNA分析(最常通过法医STR分型),这些材料通过身体接触从一个人转移到物体上。 图表注释汇总
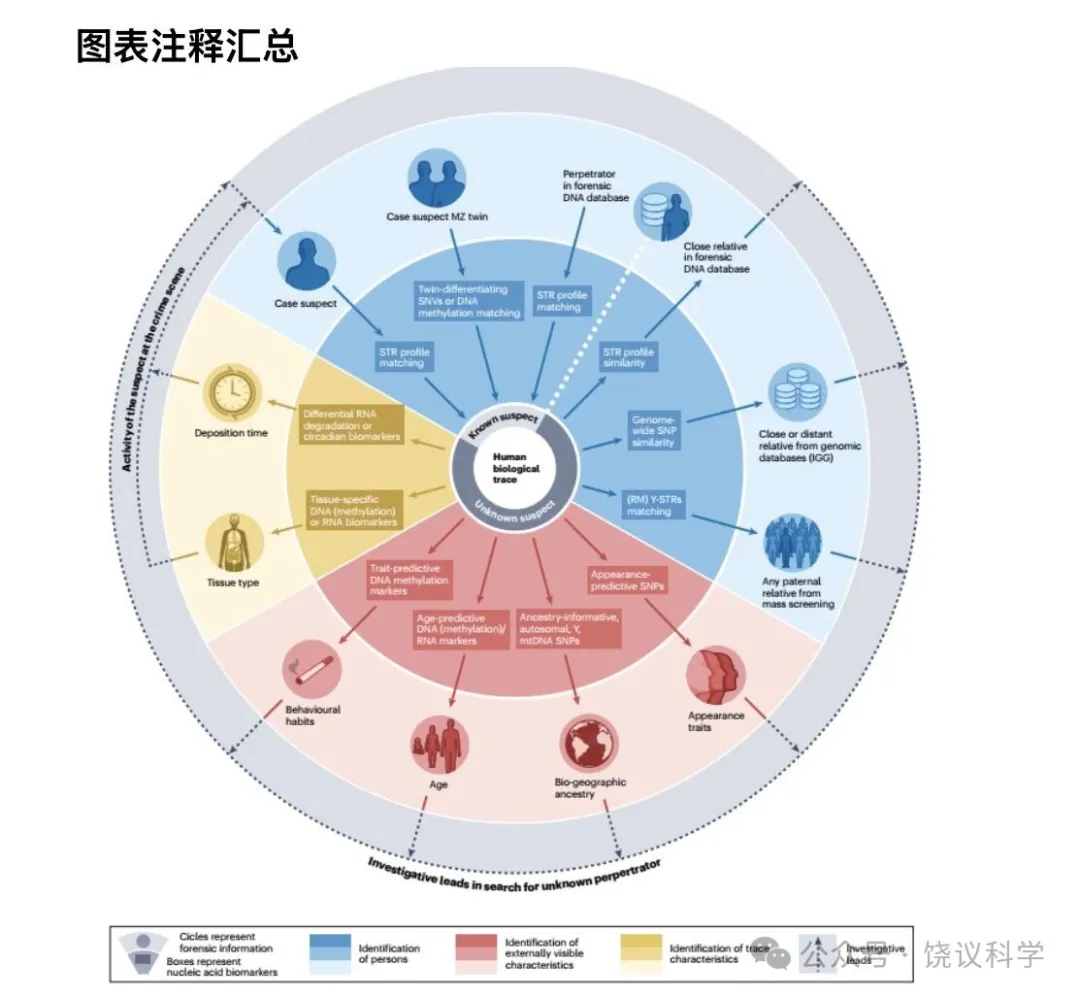
图1 | 犯罪现场调查中遗传和表观遗传分析概述。 对犯罪现场痕迹进行不同类型的遗传或表观遗传分析,可应用于有嫌疑人和无嫌疑人案件,用于人员识别、外部可见特征和痕迹特征识别。无嫌疑人案件中的痕迹分析提供调查线索,以帮助找到潜在案件嫌疑人(箭头指示)。有嫌疑人案件中的痕迹分析提供个体识别(箭头指示)。痕迹特征识别分析提供关于经DNA识别的痕迹捐献者在犯罪现场活动的信息(箭头指示)。IGG,调查遗传谱系学;mtDNA,线粒体DNA;MZ,同卵;RMY-STRs,快速突变Y染色体短串联重复序列;SNV,单核苷酸变异;STR,短串联重复序列。
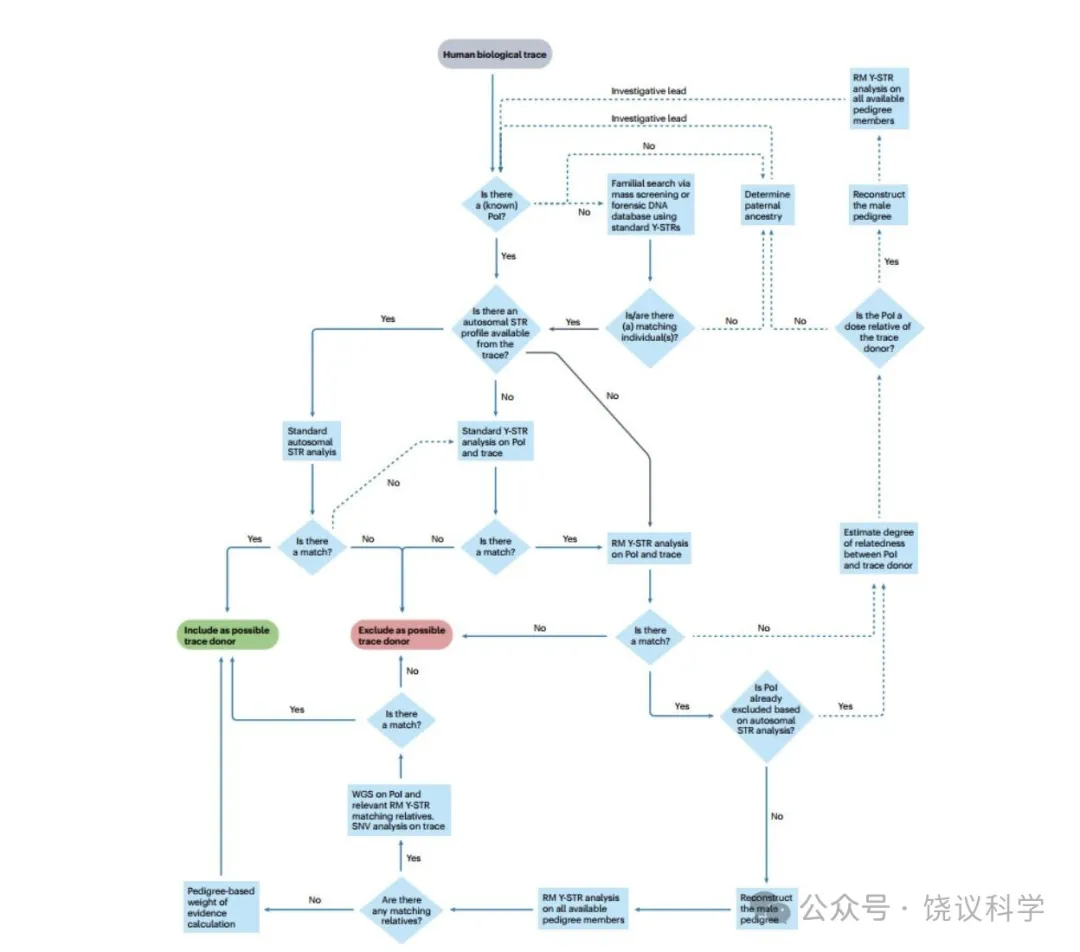
图2 | 犯罪现场调查中Y染色体分析概述及决策网络。 对痕迹进行不同类型的Y染色体分析,应用于男性痕迹捐献者且无法获得常染色体短串联重复序列(STR)图谱的案件中,用于识别男性嫌疑人(即相关人员,Pol)的父系谱系,用于区分男性嫌疑人与其父系男性亲属,用于男性嫌疑人为痕迹捐献者的个体识别,以及用于在无已知嫌疑人案件中提供调查线索以帮助寻找潜在案件嫌疑人。实心蓝色箭头指向男性个体识别。虚线蓝色箭头指向父系谱系识别和调查分析。实心黑色箭头指向成功调查分析后的男性个体识别。RM Y-STR,快速突变Y染色体短串联重复序列;SNV,单核苷酸变异;WGS,全基因组测序。
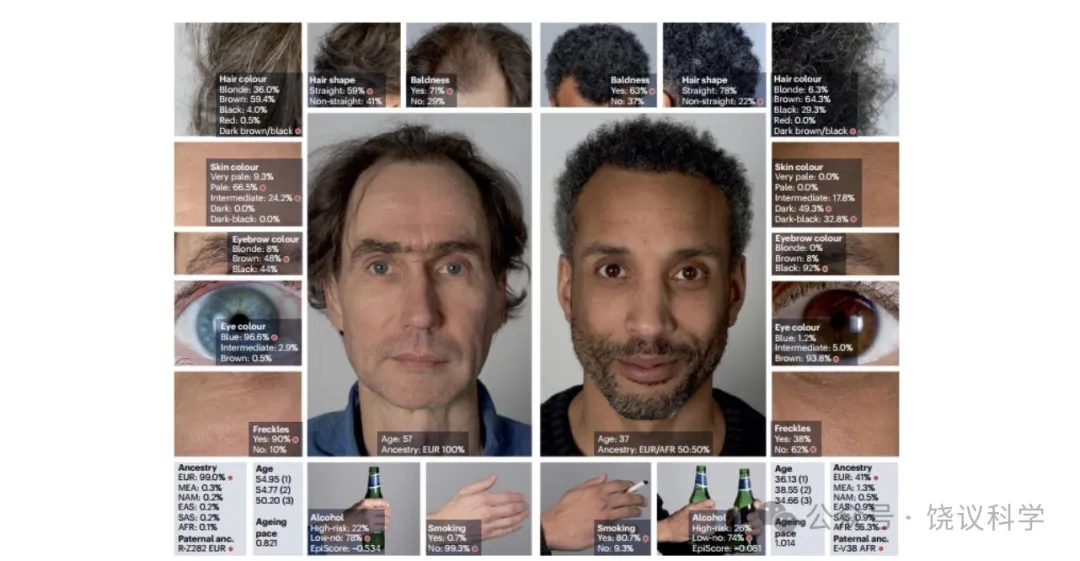
图3 | 两个示例个体的外部可见特征的遗传和表观遗传预测。 使用VISAGE增强型外貌与祖先工具及VISAGE软件,基于先前发表的预测模型(针对眼睛、毛发和肤色、眉毛颜色、雀斑、头发形状和男性脱发)实现了七个外貌特征和生物地理祖先的遗传预测。双亲生物地理祖先使用STRUCTURE推断,参考数据集包含来自六个地理区域(EUR,欧洲;MEA,中东;NAM,美洲原住民;EAS,东亚;SAS,南亚;AFR,撒哈拉以南非洲,n=2,523)的人群样本[229]。父系祖先通过Yleaf软件从Y染色体SNPs推导的Y染色体单倍群地理分布推断。年龄、吸烟和饮酒的表观遗传预测使用EPIC2微阵列(Illumina)DNA甲基化数据,基于先前发表的预测模型,即年龄使用三个第一代表观遗传时钟(DNAmAgeHorvath,HannumAge和DNAmAgeSkin & Blood),衰老速度使用DunedinPACE,吸烟和饮酒使用相应模型。预测结果以外貌特征、吸烟和饮酒的分类概率给出。对于饮酒,额外提供了酒精消费EpiScore(相对尺度值,值越低表示消费越低)。对于双亲祖先,报告预测的区域祖先比例。对于父系祖先(paternal anc.),提供Y单倍群的地理起源。预测年龄以年为单位给出,衰老速度以PACE参数(1表示加速)给出。预测结论用红点标记。两位个体均已提供知情同意,允许展示其照片和预测特征。版权:Erasmus MC。
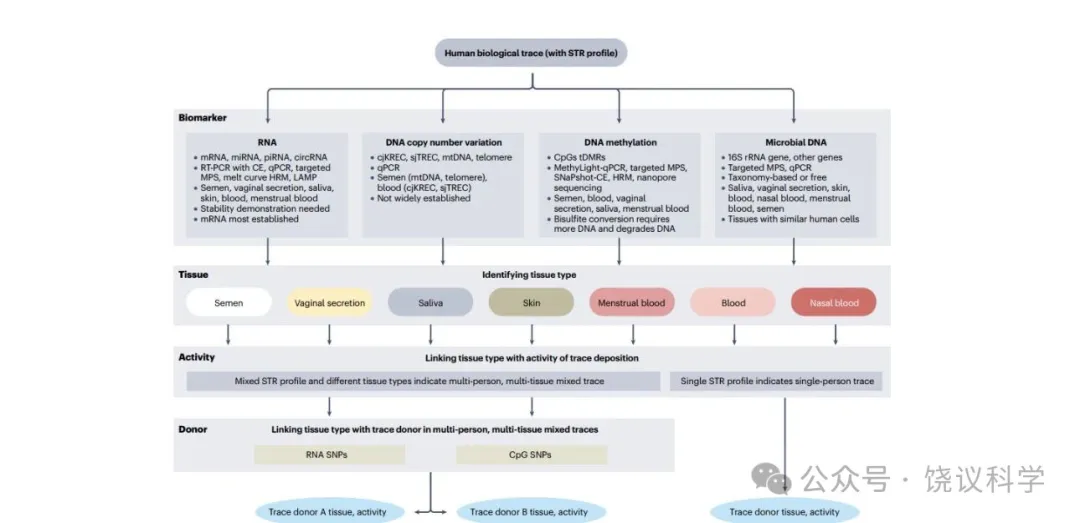
图4 | 基于核酸标记物的法医组织识别概述。 涉及不同类型核酸标记物和分析技术的痕迹分析,用于鉴定法医相关组织类型,将已鉴定的组织类型与已识别痕迹捐献者的活动(将痕迹沉积在犯罪现场)相关联,适用于单人(单源)痕迹和多人混合痕迹。CE,毛细管电泳;circRNA,环状RNA;cjKREC,编码联合kappa删除重组切除环;sjTREC,信号联合T细胞受体切除环;HRM,高分辨率熔解分析;LAMP,环介导等温扩增;miRNA,微小RNA;MPS,大规模平行测序;mtDNA,线粒体DNA;piRNA,piwi相互作用RNA;qPCR,定量PCR;rRNA,核糖体RNA;RT-PCR,逆转录PCR;STR,短串联重复序列;tDMRs,组织特异性差异甲基化区域。