


AI证出布伦南猜想,真正的考题留给了人
2026年10月19日,arXiv上线了一份手稿。伊利亚·宾德、奥列格·伊夫里、伊什特万·普劳斯和2010年菲尔兹奖得主斯坦尼斯拉夫·斯米尔诺夫四人报告:OpenAI针对布伦南猜想给出的AI生成证明,经他们检验是正确的,但过于冗长。
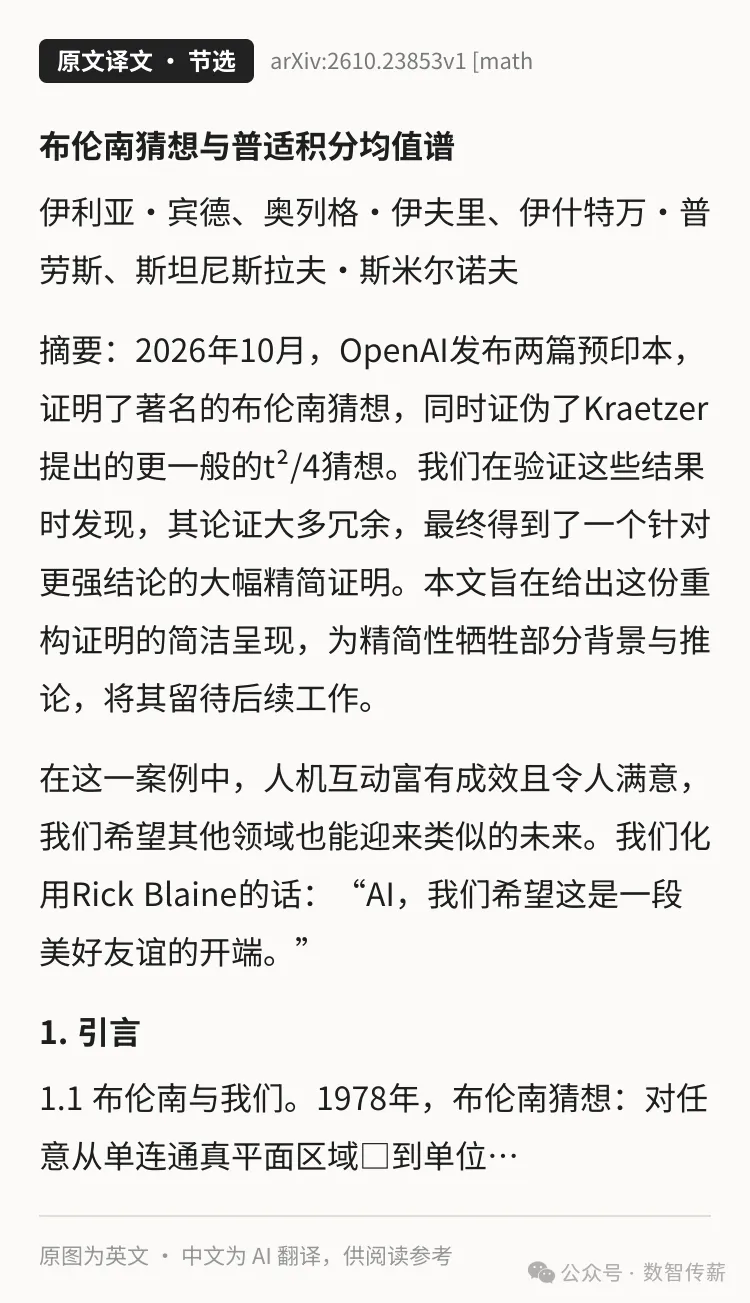
Math Files 报道:四位数学家验证 OpenAI 生成的布伦南猜想证明,认为论证正确但冗长。 这条新闻最容易被读成"AI又攻克了一道难题"。但对要决定用不用AI、怎么管AI的机构来说,真正值得注意的变化是:生成证明已经不再是最稀缺的环节,核验、理解和判断证明的价值,正在成为新的瓶颈。四位数学家的工作恰好演示了这一点——他们没有停留在"对或错"的裁决上,而是提炼核心思想、把证明大幅缩短,并推出了更强的结论。 一份1978年的猜想,和一份"正确但冗长"的证明 布伦南猜想提出于1978年,属于复分析领域,关注共形映射导数的可积性。对于把单连通正则平面域 Ω 映到单位圆盘的共形映射 g,猜想断言:当 4/3 < p < 4 时,积分 ∫_Ω |g′(z)|ᵖ dA(z) 有限。 OpenAI拿出的,正是对这一长期悬案的论证。四位数学家在10月16日提交、10月19日由arXiv列出的手稿中确认其正确,同时指出它不必要地冗长。他们识别出论证中的关键数学思想,给出了短得多的证明,还得到了更强的结果:对有界通用积分均值谱提出 B_b(t) < t²/4(−2 < t < 2,t ≠ 0)的界。 需要留意的是,手稿证明的是对应的非严格不等式,严格性的细节留待后续论文;整个工作也尚未经过同行评审。换句话说,"正确"目前是顶尖专家的阶段性判断,不是学术流程的最终盖章。 当机器三小时产出一个结果,核验成了独立难题 把这件事放回十月份的背景,判断会更清楚。10月6日,OpenAI开放了一个仓库:722篇手稿,归为372组相关成果,来自约4000个研究问题的评估。据OpenAI称,标准流程下每个成果平均消耗约三小时的ChatGPT Pro思考算力,而生成这些成果的内部模型本身并未公开。
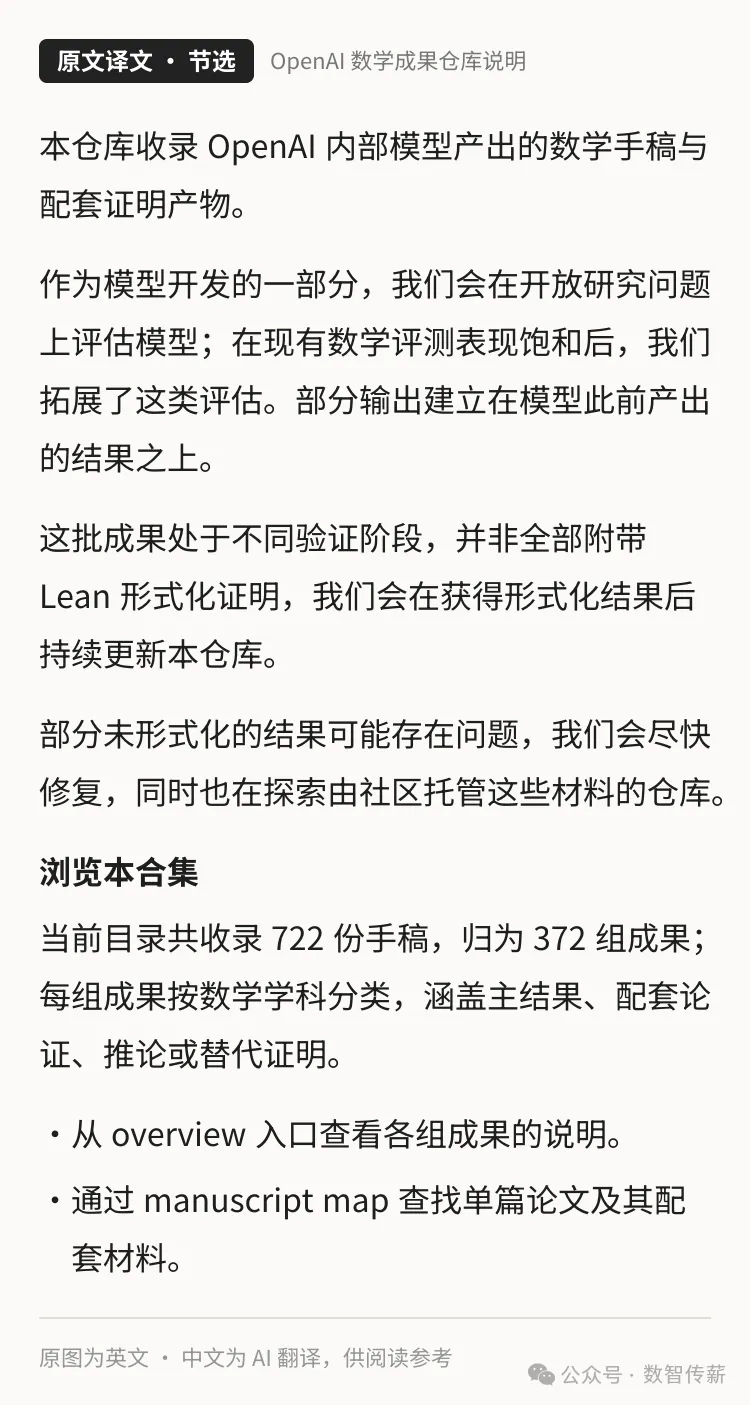
科技账号 @kimmonismus 转述:OpenAI 发布722篇由未公开内部模型生成的数学手稿。
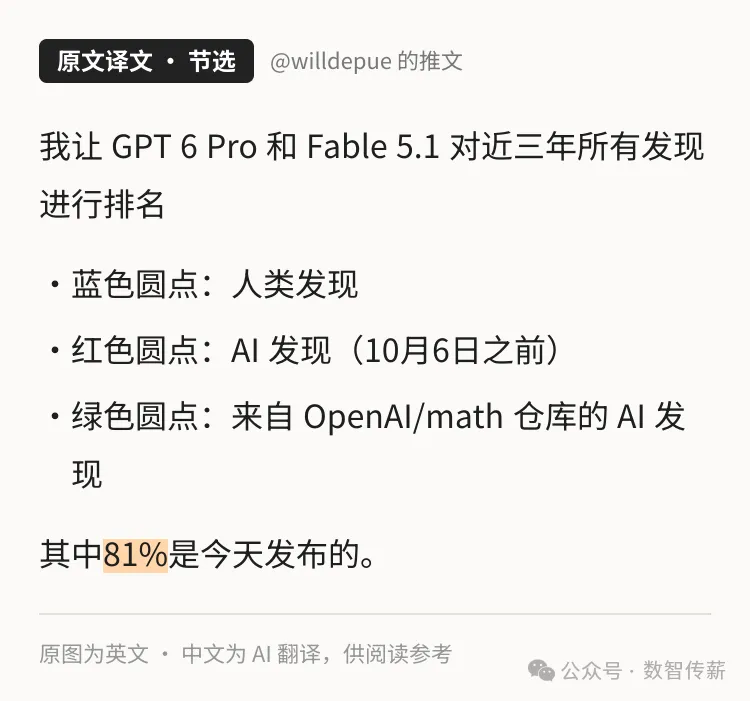
科技账号 @willdepue 梳理:近三年多项高难度发现中81%来自OpenAI数学仓库。
科技账号 @kimmonismus 展示 OpenAI AI 生成数学手稿的具体内容。
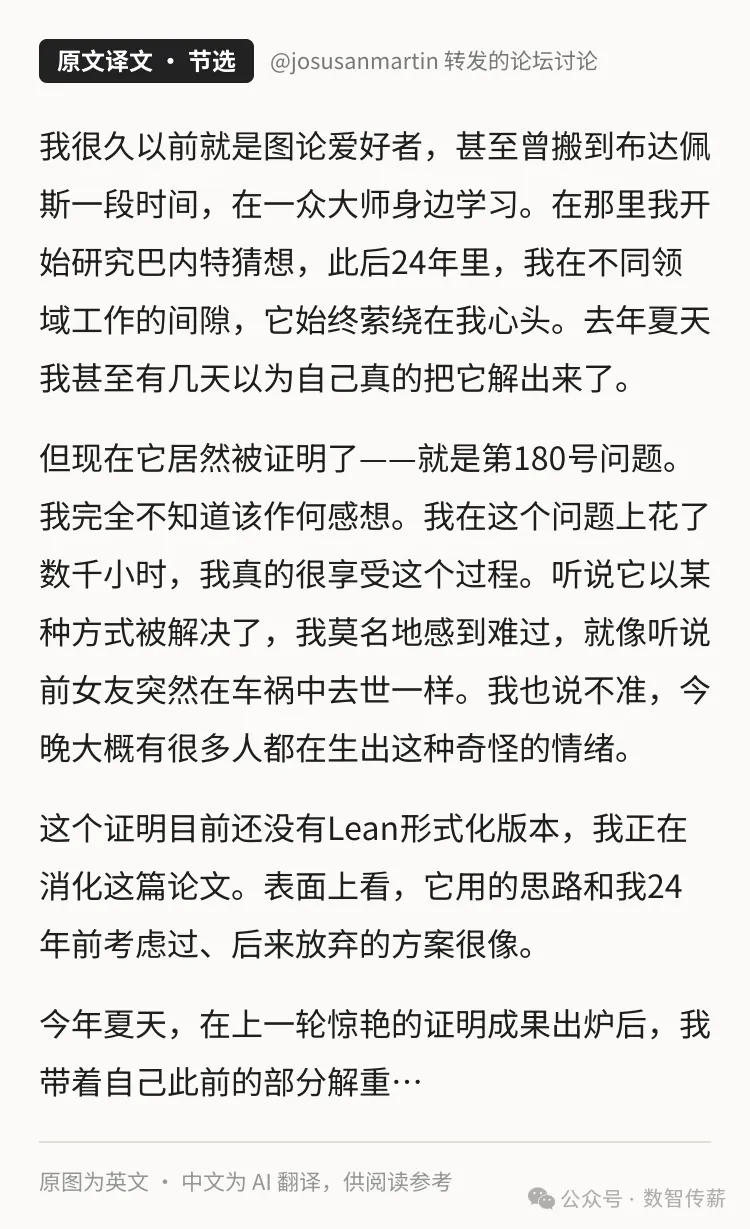
科技账号 @josusanmartin 转发网友对巴内特猜想证明的讨论。
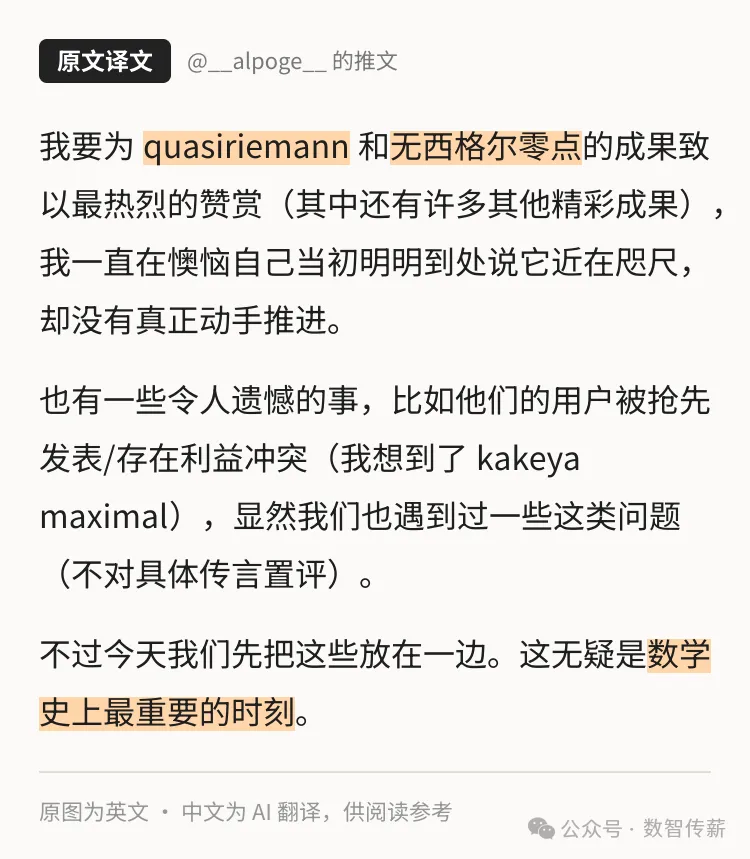
科技账号 @kimmonismus 对比 OpenAI 不同阶段数学成果的算力消耗。 数量和速度本身,正在制造一个新问题。10月17日,OpenAI、Anthropic与西蒙斯基金会宣布了一项1500万美元的计划,资助数学家检验、理解AI产出的成果并在其上继续研究,资金用于研讨会、研究讨论和AI工具使用。出资方的动作说明,行业已经意识到:机器以极快速度吐出证明之后,人类社会需要专门的资源来回答"哪些是对的、哪些是重要的"。
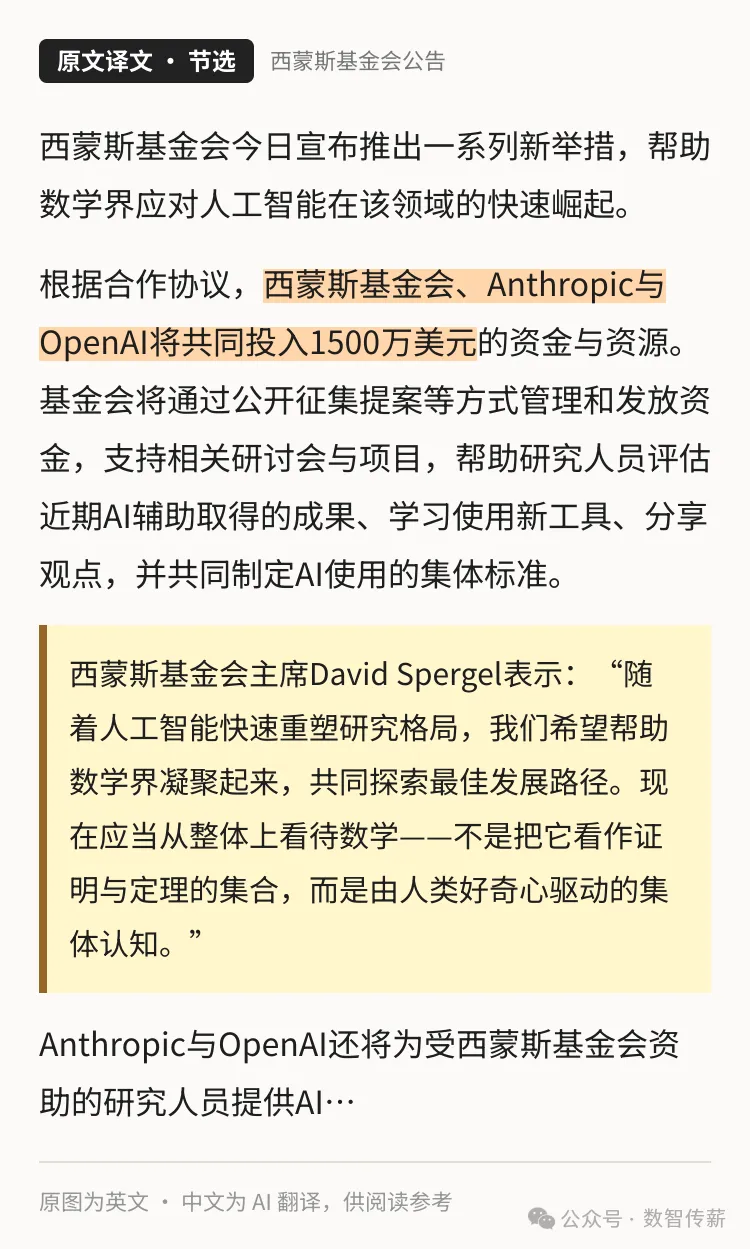
Math Files 报道:OpenAI、Anthropic 与西蒙斯基金会出资1500万美元,支持数学家检验AI成果。 数学家的真实角色:从"解题者"变成"解释者" 四位数学家对布伦南猜想证明做的三件事——提炼思想、缩短证明、加强结论——比"验证正确"四个字更有信息量。AI给出了一条能走通但绕远的路;人类专家的价值在于看清这条路为什么走得通,并把它改造成更简洁、更有承载力的数学。 陶哲轩在10月15日Numberphile采访中的判断与此呼应。他说:"我们正在见证数学浪漫时代的终结,也就是英雄时代的结束。"他描述的新形态,是数学家、AI系统和计算机辅助验证组成的更大规模协作;同时他提醒,已解决问题的积累并不自动带来更深的洞见,数学必须保护赋予结果意义的人类理解。
Math Files 报道:陶哲轩在 Numberphile 采访中谈到AI重塑数学研究方式。 也有更冷静的校准。数学家奥布希克·萨哈把OpenAI那批成果按开创性分成四类,认为多数落在"现有框架内的非凡进展"或"令人惊喜的突破",只有拟黎曼猜想一项属于"震惊学界的突破"。这是他个人的初步判断,但提醒决策者:同一批发布里,成果的分量差异很大,不能用一个总数代替逐项评估。 对机构而言,责任边界比能力边界更要紧 Google DeepMind 10月8日发表在《Science》上的研究提供了另一个有用的分母:其AI系统在尝试的353个Erdős问题中解决了9个,证明在Lean中完成检验,同时还有大量问题超出系统能力。进展真实,命中率也真实。
Math Files 报道:Google DeepMind 的AI解决353个Erdős问题中的9个,并经Lean检验。 对机关、高校、媒体和企业的管理者,这件事至少有三条可操作的含义。 第一,AI产出应按"待核验草稿"管理,而不是按结论采信。 布伦南猜想的证明由菲尔兹奖级别的团队花费专门工作才确认正确,且严格性仍待补完。普通机构面对的AI报告、代码、法律文书和数据分析,核验难度未必更低。流程上要预留独立复核环节,并明确签字负责的是人,不是模型。 第二,核验能力要提前建设,否则会被产出速度淹没。 722篇手稿、平均三小时一个结果的节奏,意味着"先做出来再说"会把成本转嫁给下游。高校和科研管理部门可以参照1500万美元计划的思路,把经费和考核投向复核、形式化验证和结果分级,而不只是奖励使用AI的数量。 第三,引进AI工具时同时要求可追溯证据。 OpenAI这批成果附带论文、证明产物和推理摘要,但模型本身未公开。机构采购时应至少要求留存提示、版本、数据来源和人工修改记录,使事后追责和错误回溯成为可能。 平台上也有评论者半开玩笑地说,眼下人类"超级专家"比所谓超级智能更高效——用词更少、焦点更集中。这代表一种看法:AI目前仍需人类收尾。这种状态会持续多久,没有人能打包票;但只要核验责任在人这一边,机构的规则就必须按"人要担责"来设计。 布伦南猜想被证明是数学的进展,而四位数学家从冗长论证中提炼出更短证明和更强定理,则给所有机构上了一课:AI普及之后,稀缺的不再是答案,而是能判断答案对错、轻重的人。 谁先把核验的人和流程建起来,谁才真正接得住这波技术。