


740亿大模型,直接塞进笔记本
740亿参数的AI,瘦到22.1GB,直接塞进笔记本!
就在刚刚,英伟达开放了Nemotron 3.5 Bolt的模型权重。原本约148GB,一口气砍掉约85%,瞄准24GB级本地部署。 看图、写代码、调用工具,这回笔记本也能接活了。
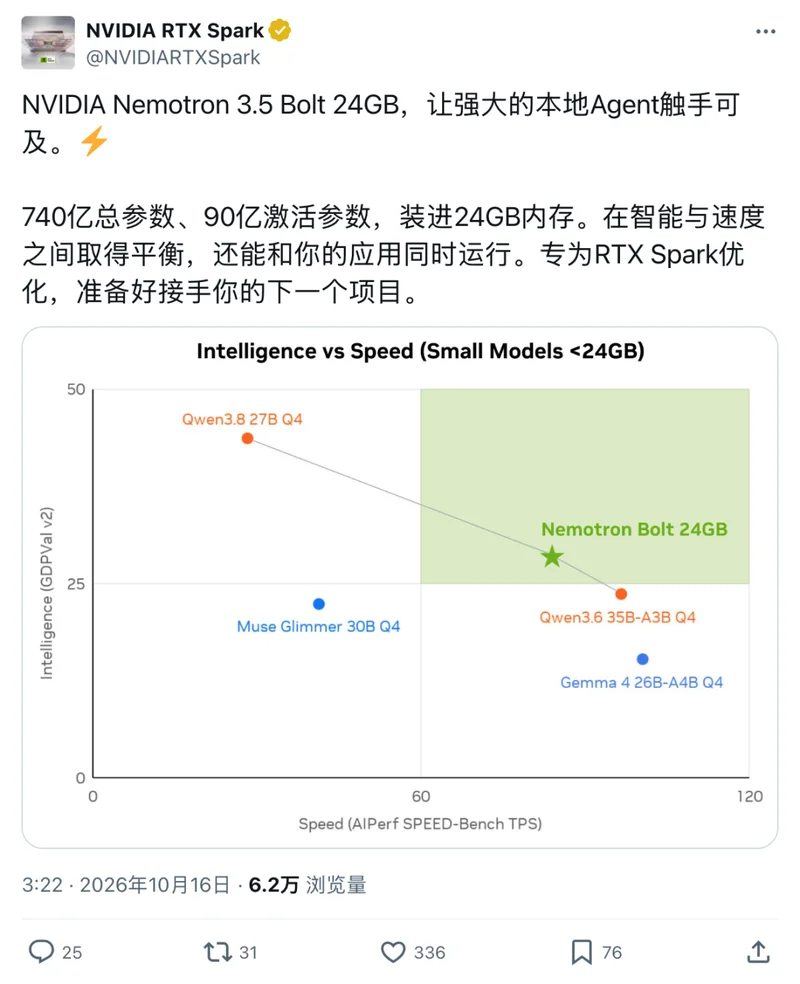
Ollama已经给出了接入OpenClaw的入口。Agent在本机读文件、改代码,负责推理的大模型也可以在本机运行,少了一趟趟往云端跑。 模型放出来,电脑也开卖。10月16日,搭载RTX Spark的笔记本全球发售,联想、微软等厂商的新机正式登场。 大模型和新电脑,老黄一起端上来了。
龙虾大脑搬家!笔记本直接接活 一句「帮我改下代码」,到了Agent那儿,往往得忙活好几轮。先读文件、找位置,再动手改,运行报错了,还得回头重来。 每走一步,背后的模型都可能要再想一轮。如果推理全在云端,这些请求就得来回跑。 Bolt想接下的,就是这些可以留在电脑上的日常活。 它每次生成token激活约90亿参数,但740亿参数的家底都在。工具调用、图片和视频输入也都支持,代码和图表都能交给它读。 训练时,团队就让它进入模拟环境练习工具操作,学习少绕弯、少做无用功。Agent少走一次弯路,屏幕前的人就少等一轮。
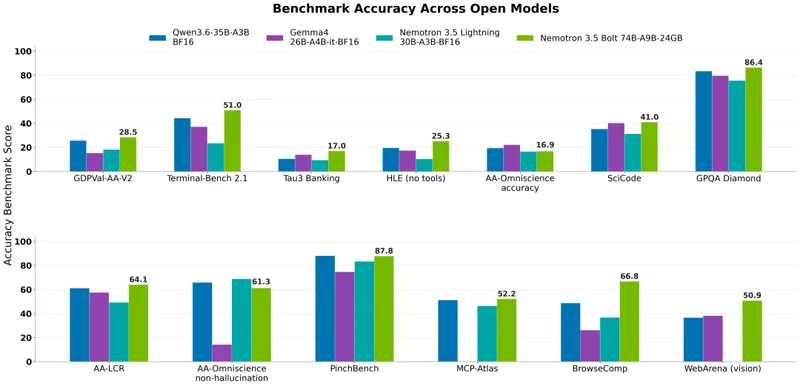
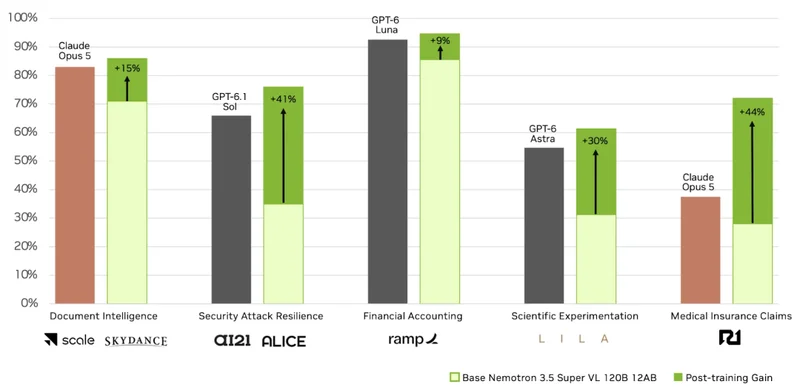
最终量化版Bolt,在考终端操作的Terminal-Bench 2.1拿到50.98%,在考上网找信息的BrowseComp拿到66.75%。这两门,都是Agent接活时绕不开的功课。 Ollama已经列出OpenClaw、Hermes等框架的启动入口。开发者可以给熟悉的Agent换上本地模型,联网搜索照常联网,推理则交给自己的电脑。 这样,文件、工具和负责推理的模型,就能在同一台电脑上碰头。龙虾在本地干活,大脑也有了本地的住处。 148GB压成22.1GB!大模型暴瘦85% Bolt的底子,来自这次一起发布的1200亿参数Nemotron 3.5 Super VL。后者每次激活120亿参数,面向企业Agent,图表、文档、视频都能读,看完还能调用工具接着干。 企业还可以拿自家数据继续训练它。到了财务平台Ramp手里,它就被派去认小票,把商户、日期和付款信息整理成程序能读取的数据。报销时那些磨人的抄抄填填,正好让它接手。
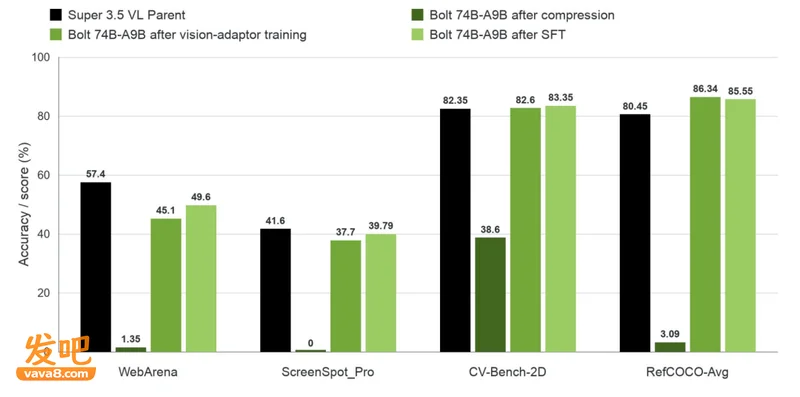
轮到Bolt,团队要让这位「大哥」住进笔记本。先动模型结构,从1200亿参数压到740亿,再把受损的能力练回来。 麻烦出在看屏幕上。前面的压缩只动了语言部分,恢复训练也先保文字能力;原来的视觉模块接回来,和这副缩小的底子还得重新磨合。 让它按指令在屏幕上找目标,问题就暴露了:ScreenSpot Pro这项测试,父模型得分41.6%,刚压缩完、还没补视觉训练的Bolt却掉到了0。 于是,团队先用每轮约660万张图像训练视觉适配器,再做视觉任务微调,把成绩拉回39.79%。瘦身省下的空间,差点把「眼力」也一起省掉了。
眼力补回来了,体积还没过关。740亿参数按BF16精度保存,光权重就约148GB,连最高128GB统一内存的RTX Spark笔记本也装不下。
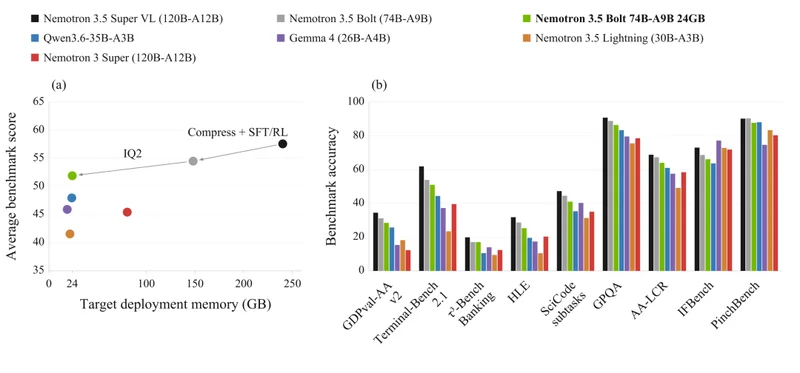
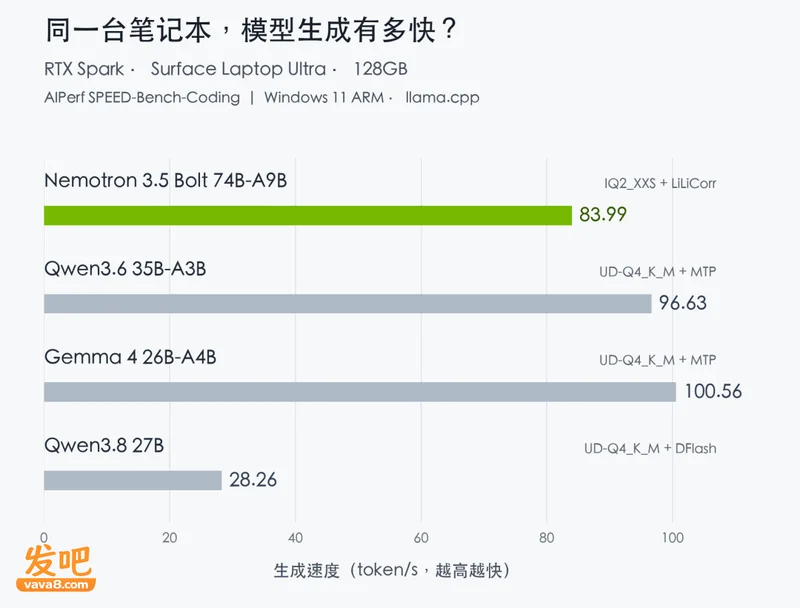
接下来,每个参数也得少占点地方。占大头的专家权重被压到约2bit,其他部分保留不同精度,再用「量化感知蒸馏」向教师模型补课,尽量追回精度损失。权重终于瘦到22.1GB。 这组实验里,同样的内存预算下,先把大模型练好再瘦身,反而比从头练小模型、再做4bit量化留下了更高的准确率。 装得下,还得跑得快。Bolt请来一个叫LiLiCorr的小模型先打草稿,主模型再成批验收,减少逐个生成token的等待。 在英伟达的代码生成测试中,搭载RTX Spark的128GB版Surface Laptop Ultra,让Bolt跑到了约84token/s。
真正配电脑时,还要给缓存、视觉模块和加速小模型留位置。按Unsloth的短上下文建议,32GB内存或统一内存可作为规划起点,48至64GB更宽裕,22.1GB只是权重的账单。 128GB新本全球开卖,老黄软硬一起上 RTX Spark的电脑已经开卖,接下来就轮到这些模型上场。Blackwell RTX GPU和Grace CPU集成在一颗超级芯片里,CPU与GPU共用最高128GB统一内存。 模型拼命瘦身,电脑这边也得腾地方。两边一起往前推,本地Agent才更容易跑起来。
Artificial Analysis拿了一份更大的模型来试这道门槛。Ling 3.0 Flash量化后,光权重就有77GB。 测试中的64GB MacBook Pro和32GB显存RTX 5090都装不下,128GB的RTX Spark笔记本还能继续跑。
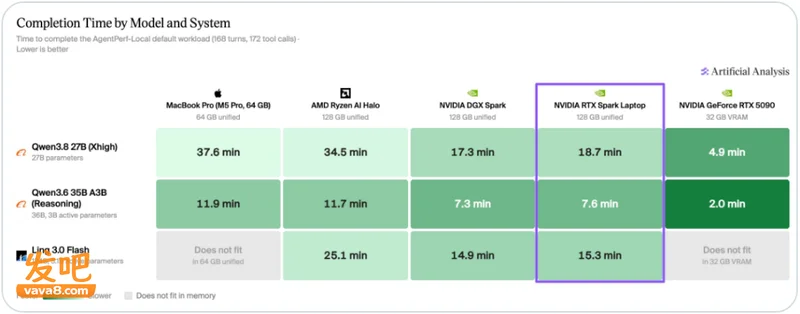
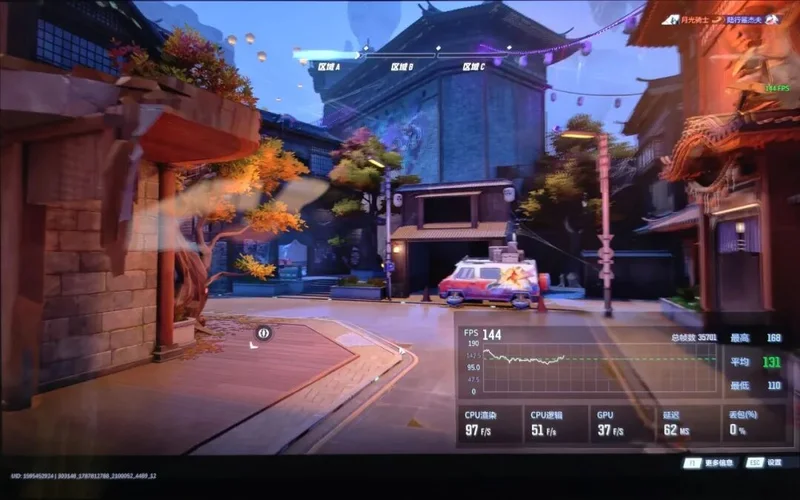
旗舰显卡也会遇到这种尴尬:算得再快,模型太大,照样进不了门。到了本地AI这里,挑电脑还得看看它的「肚量」。 英伟达也把OpenClaw和Hermes列进了发售时的应用生态,并提供引导安装。想让更多人养上龙虾,第一关总不能先考环境配置。 养龙虾之余,这台电脑也得照顾原来的活。RTX Spark首发支持数百款游戏,Photoshop和Premiere的原生支持也通过首发测试版提供,处理完AI任务,还能接着剪片、玩游戏。
连740亿参数都嫌大,还有更小的一档。Nemotron 3.5 Bolt E4B 4GB计划10月23日推出,面向本地语音助手、交互角色等场景。 Super VL接企业里的复杂活,Bolt把日常Agent任务搬进笔记本,E4B再去照顾更轻巧的设备。这一家子,分头上班。 老黄的算盘也很清楚:开放模型,让更多AI任务用上用户手边的GPU;新电脑开卖,再把这份需求接过来。 买了这么多年「生产力工具」,打工人的愿望也可以大胆一点了: 「电脑,你先忙,我下班了。」