


拆解Bengio:从n-gram到可学习词向量
经典论文赏析:从 n-gram 到可学习词向量,拆解 Bengio 2003 神经概率语言模型
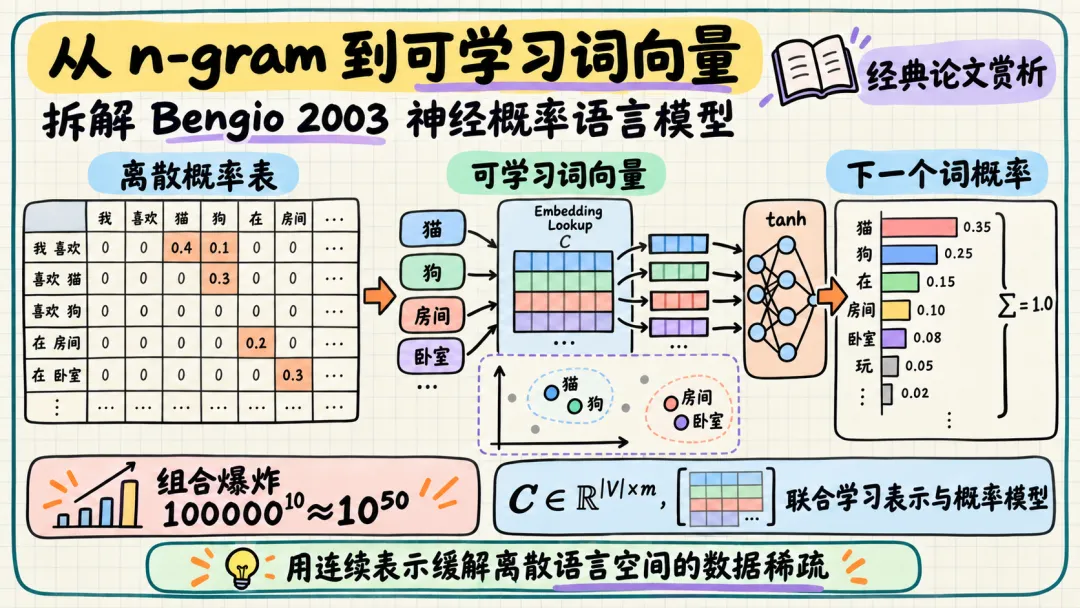
2003 年,Bengio、Ducharme、Vincent 和 Jauvin 发表了A Neural Probabilistic Language Model[1]。这篇论文出现时,“语言模型”主要还是 n-gram 的天下;神经网络并不是新概念,分布式表示也已有更早的研究,但把「词表示与语言概率模型放在同一个目标下联合训练」,并在大词表实验中给出有竞争力的结果,是这篇论文最重要的贡献。 它所处理的矛盾至今仍然熟悉:语言由离散符号组成,可能的词序列数量却以指数速度膨胀。若模型只能记住训练语料里出现过的片段,它就无法可靠地处理新组合;若模型能够把相似词映射到相近位置,一条训练样本便可能同时改善许多从未出现过的句子。 这篇文章不从“词向量很有用”这一结论倒推历史,而是沿着原论文的推导路线,拆开它的概率假设、网络结构、梯度流、计算瓶颈和实验结论。 01 一个无法存下的概率表 语言模型要回答的问题是:给定前文,下一个词出现的概率是多少?对序列w_1, w_2, ..., w_T,联合概率可以按链式法则写成: P(w_1, ..., w_T) = ∏_{t=1}^{T} P(w_t | w_1, ..., w_{t-1}) 这个等式没有近似,但它并没有直接解决问题。随着t增大,条件部分会越来越长;几乎每段完整历史都只出现一次,甚至从未出现。 传统做法是引入马尔可夫近似:只保留最近n-1个词。 P(w_t | w_1, ..., w_{t-1}) ≈ P(w_t | w_{t-n+1}, ..., w_{t-1}) 于是,一个 n-gram 模型看起来只需要维护“长度为n-1的上下文到下一个词”的概率表。但这个表仍然大得惊人。若词表有 10 万个词,仅考虑长度为 10 的序列,离散组合数就是: 100000^10 = 10^50 现实语料只会覆盖其中极小的一部分。问题不只是内存放不下,更在于统计证据极度稀疏:模型看到“The cat is walking in the bedroom”,并不会自然地把证据迁移给“A dog was running in a room”。在符号表里,cat和dog是两个毫无距离关系的编号;替换一个词,整段 n-gram 就成了另一项。
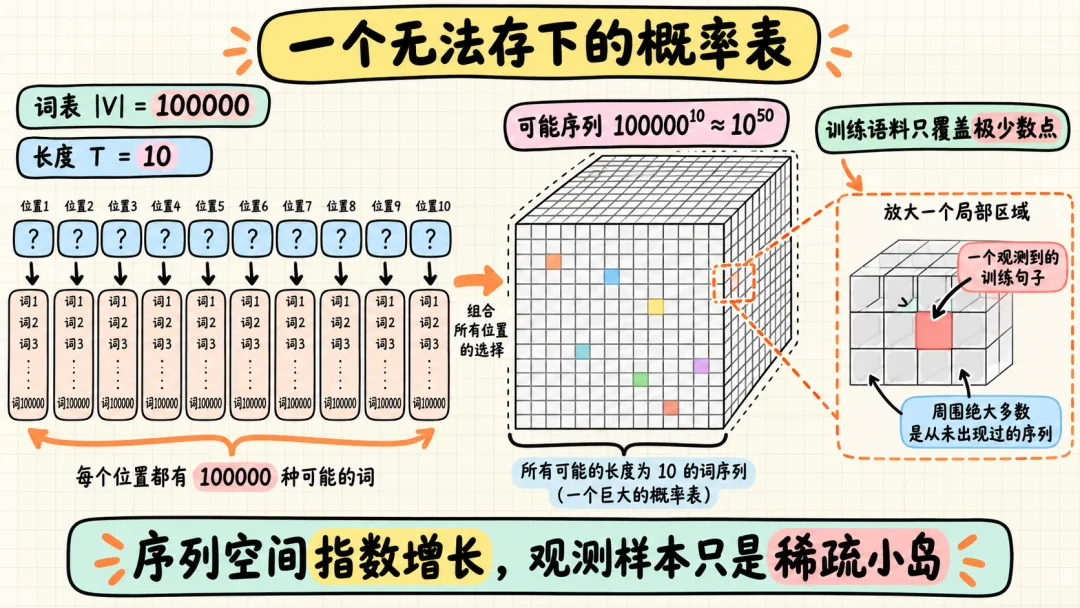
这就是论文所说的「维数灾难」:变量数量稍有增加,可能组合便呈指数增长,而数据量不可能同步增长。语言模型真正需要的,不是更勤奋地保存一个永远填不满的表,而是一种能在不同序列之间共享统计强度的表示方式。 02 n-gram 如何泛化,又为什么不够 n-gram 并非简单地“见过就计数、没见过就给零”。成熟的统计语言模型会使用平滑、回退和插值:高阶片段没有可靠统计时,就逐步退回低阶分布。 以预测P(w_t | w_{t-2}, w_{t-1})为例: 三元组证据充足时,优先相信完整的两个词上下文; 三元组稀疏时,退回P(w_t | w_{t-1}); 二元组仍不可靠时,再参考P(w_t); 插值模型则会把不同阶数的估计按权重组合,而不是做一次硬切换。
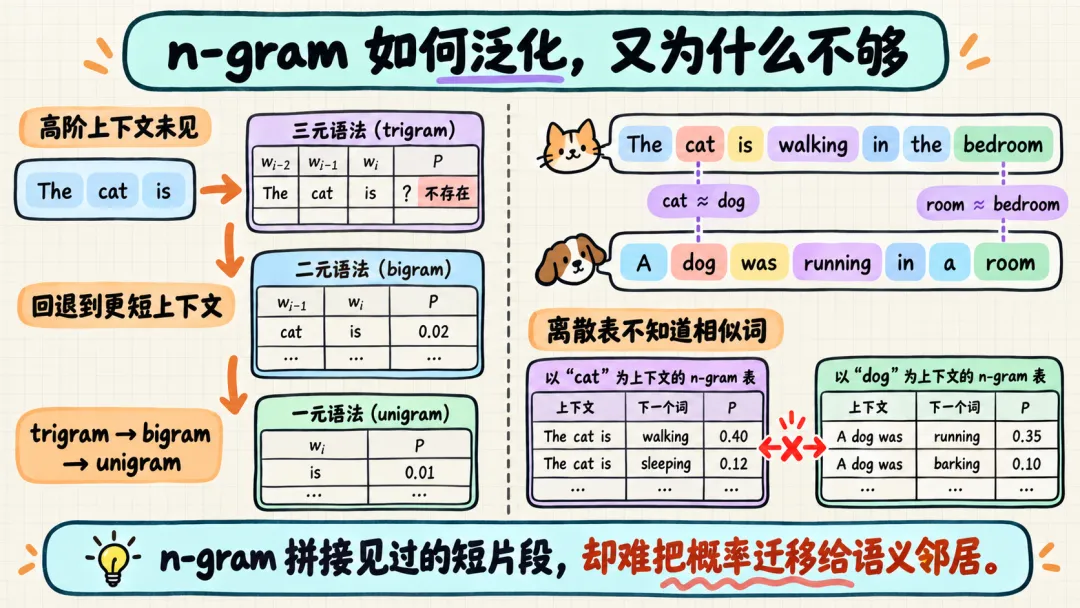
这种机制很有效,Modified Kneser–Ney 至今仍是理解统计语言模型时绕不开的基线。它的问题不是“不能泛化”,而是「泛化主要沿上下文长度发生」:模型通过丢掉较远的词,让更多样本落进同一个短上下文。 代价也很明确。每退一阶,模型都会损失一部分条件信息;而且它依然不知道哪些词可以相互替换。cat与dog语义和句法角色相近,bedroom与room也存在关联,但离散计数不会自动把这些关系编码进去。除非人为定义类别,或碰巧在相同短上下文中积累了足够统计,否则一条句子的概率证据很难迁移到它的近邻句子。 Bengio 等人把突破口放在“近邻”的定义上:如果词不再只是离散编号,而是连续空间中的点,那么模型就可以用空间距离表达相似性,再用一个平滑函数把相似上下文映射到相似的概率分布。 03 用连续空间对抗维数灾难 论文的核心方案可以压缩成三步: 为词表中的每个词分配一个可学习向量; 用这些向量表示上下文; 用神经网络根据上下文表示计算下一个词的条件概率。 设词表为V,嵌入维度为m。模型维护一个矩阵: C ∈ R^{|V|×m} 词w的向量C(w),就是矩阵C中与它对应的一行。这里的关键并不是“先做一次词向量预训练”,而是C直接属于语言模型参数:它与后面的概率函数g一起,由同一个对数似然目标端到端优化。
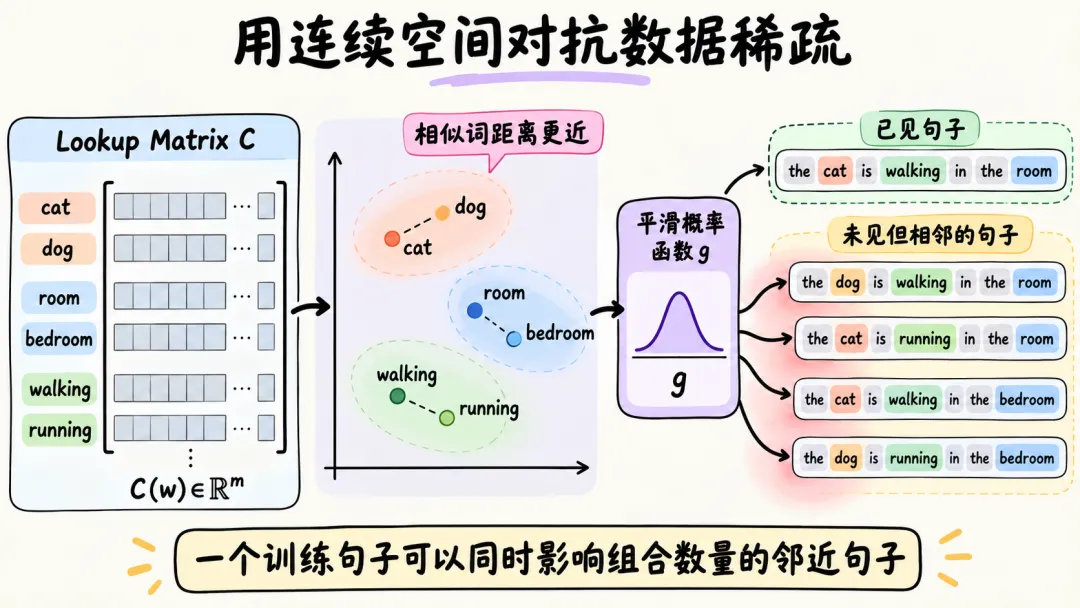
为什么连续表示有助于解决稀疏性?假设训练数据提高了下面这个句子的概率: The cat is walking in the bedroom 如果学习后dog的向量靠近cat,running靠近walking,room靠近bedroom,而概率函数又对输入变化足够平滑,那么这一次参数更新也可能提高许多相邻组合的概率,例如: A dog was running in a room 一条观测因此不再只服务于一个离散格子,而会影响连续空间中的一片区域。更重要的是,多个位置可以同时替换:分布式表示让组合数量仍然庞大,却不再要求每个组合都拥有独立参数。 不过,“相近”必须理解得准确。模型优化的是下一个词预测,不是词典释义复现。两个词靠近,表示它们在训练语料和当前架构下具有相似的预测作用;这种关系可能包含语义,也可能主要反映句法和搭配。另外,该模型为每个单词只学习一个静态向量,多义词的不同含义仍被压在同一行参数里。 04 完整拆解网络结构 现在把论文中的前馈网络逐层展开。模型取最近n-1个词,把各自的向量按位置拼接: x = [C(w_{t-1}); C(w_{t-2}); ...; C(w_{t-n+1})] ∈ R^{(n-1)m} 这里必须是“拼接”,而不是求和或平均。因为前馈网络本身没有序列结构,词向量处于拼接向量的哪一段,就承担了位置信息:上一个词和上上个词会进入不同坐标区域。 隐藏层计算为: a = tanh(d + Hx) 随后得到词表中每个候选词的未归一化分数: y = b + Wx + Ua 最后经过 Softmax: P(w_t=i | w_{t-1}, ..., w_{t-n+1}) = exp(y_i) / Σ_j exp(y_j)
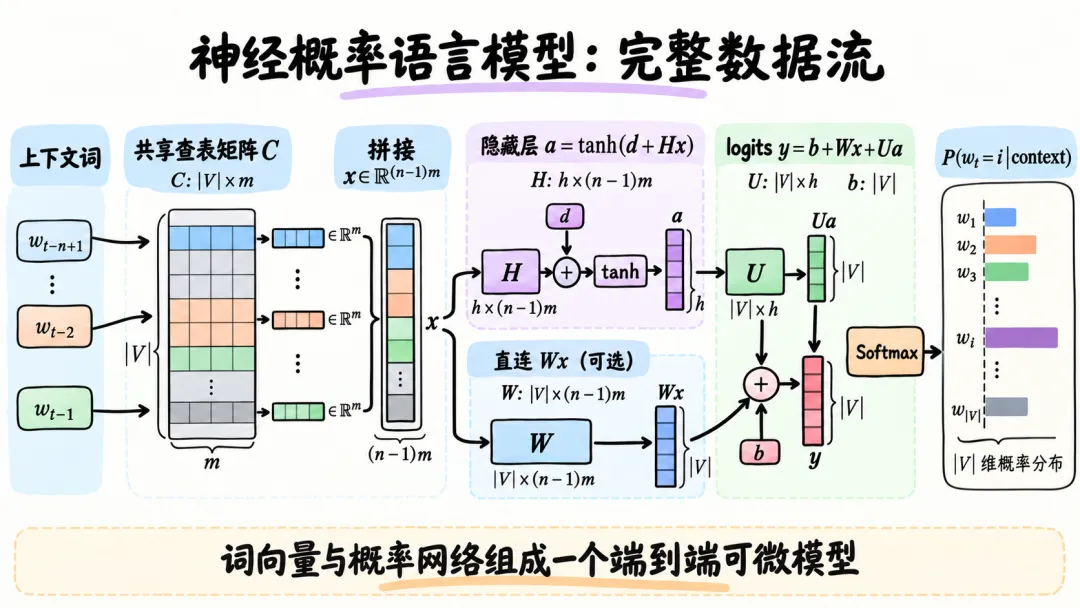
这条计算图包含两条从上下文到输出的路径: 非线性路径x → H → tanh → U → y,负责学习上下文词之间更复杂的组合关系; 可选的直接路径x → W → y,让输出层直接使用词向量特征。 若隐藏层宽度为h,主要参数形状如下: C ∈ R^{|V|×m}:词向量查找表; H ∈ R^{h×(n-1)m}、d ∈ R^h:上下文到隐藏层; U ∈ R^{|V|×h}:隐藏层到词表输出; W ∈ R^{|V|×(n-1)m}:上下文到输出的直接连接,可选; b ∈ R^{|V|}:每个输出词的偏置。 把这些项加起来,含直接连接时参数总量是: |V|(1 + nm + h) + h(1 + (n-1)m) 这揭示了模型的一个重要性质:参数规模随词表大小|V|和上下文长度n线性增长,不再随n指数增长。但“参数不再指数爆炸”不等于“训练已经便宜”,因为输出层仍要为词表中的每个词计算分数。论文后半部分的大量工程工作,正是为了处理这个问题。 05 词向量是怎样被训练出来的 论文使用最大似然训练模型。忽略边界符号后,目标可以写为平均对数似然加正则项: L(θ) = (1/T) Σ_t log P(w_t | w_{t-1}, ..., w_{t-n+1}; θ) + R(θ) 其中: θ = (C, H, d, U, W, b) 训练样本由“上下文窗口 + 真实下一个词”构成。真实词只用来定义损失目标,不会作为当前预测的输入。论文采用随机梯度上升:每处理一个样本,就沿着提高真实下一个词对数概率的方向更新参数。
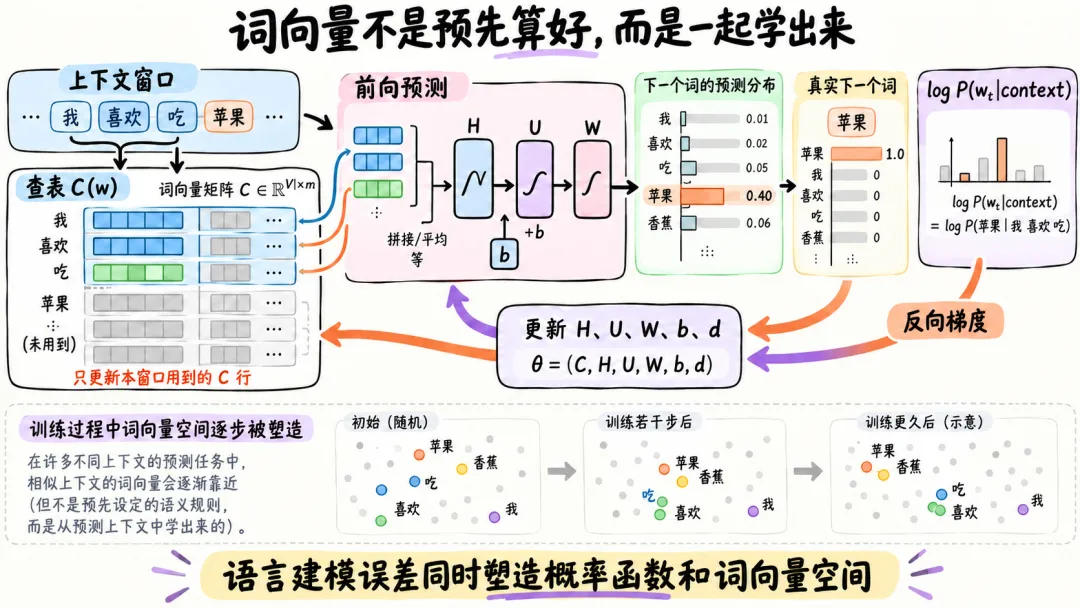
梯度的传播路径可以按计算图反向阅读: Softmax 误差先作用于输出分数y; 梯度更新U、W、b,并传回隐藏状态a与上下文表示x; 经tanh和H继续传播,更新H、d; x是若干词向量的拼接,所以梯度最终进入矩阵C中对应上下文词的那些行。 对单个样本而言,C并不会整表更新:只有当前窗口出现的词所对应的行收到梯度。但同一个矩阵在所有位置、所有句子中共享,语料不断滑动后,大量词向量都会被反复修正。 这也解释了“可学习词向量”的真正含义。它不是在网络外部先计算一个固定特征,再把结果交给语言模型;它是预测模型内部的一层参数。某个词向量向哪里移动,取决于这种移动能否让相关上下文更准确地预测后续词。论文也尝试过由 LSI 等方法预先构造的固定分布式特征,但没有取得同样的效果。联合训练让表示专门适配目标任务,这是二者的结构性差别。 06 真正的计算瓶颈在输出层 嵌入查找本身很便宜,隐藏层也只处理固定长度的上下文。真正昂贵的是 Softmax:每预测一个词,模型都要为词表中的全部|V|个词计算y_i,再完成指数运算和归一化。 当词表接近两万、隐藏层有数百个单元时,矩阵U的计算已经占据训练成本的大头。词表扩展到十万甚至百万量级后,这个问题只会更突出。
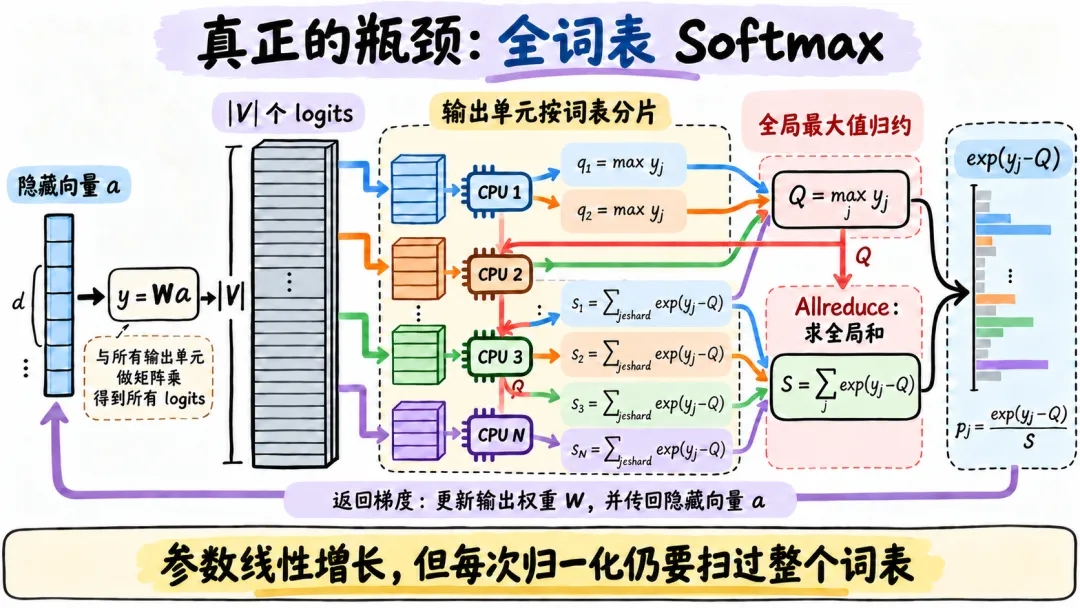
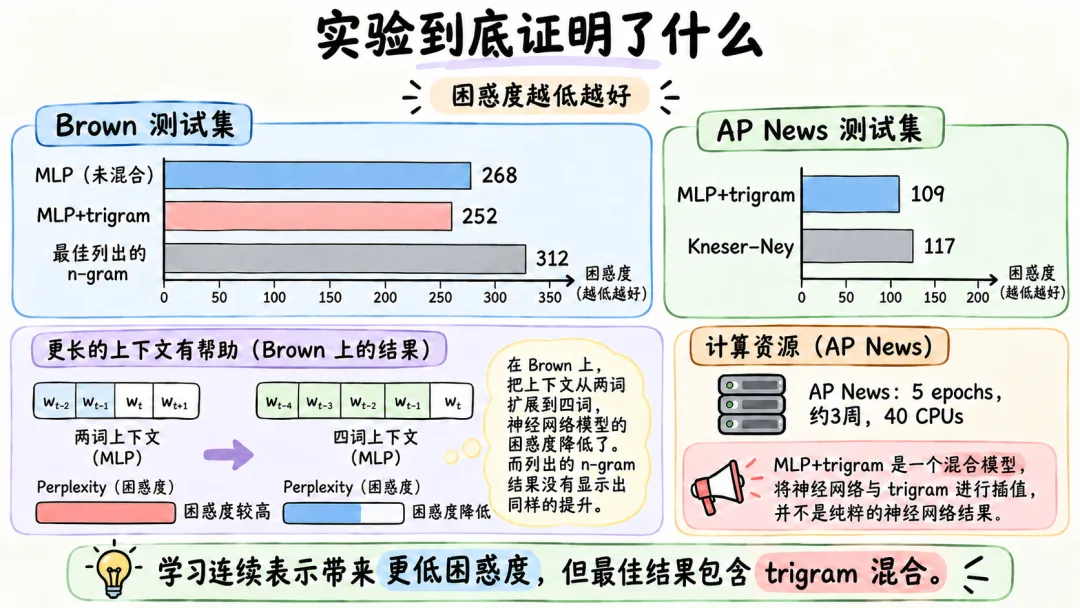
论文给出了两类并行方案。共享内存机器可以让多个处理器异步更新参数;网络连接的机器则按输出单元切分词表,每个处理器负责一部分y_i。但 Softmax 分母跨越所有分片,因此仍需两次全局归约: 各分片先计算局部最大值,再归约得到全局最大值Q = max_i y_i; 各分片计算exp(y_i-Q)的局部和,再归约得到全局总和S; 用exp(y_i-Q)/S得到各词概率,并在反向阶段合并梯度。 减去Q不会改变 Softmax 结果: exp(y_i-Q) / Σ_j exp(y_j-Q) = exp(y_i) / Σ_j exp(y_j) 它的作用是避免指数运算溢出。这套流程今天看仍然熟悉:模型参数可以分片,局部矩阵乘法可以并行,但精确归一化会制造跨设备同步点。 论文在 Associated Press 新闻语料上训练五轮,大约使用 40 个 CPU 跑了三周。这个数字很能说明问题:连续表示把统计建模从指数参数表改造成了可训练的函数,却把主要困难转移成了大规模矩阵计算和全词表归一化。后来围绕分层 Softmax、采样式目标、词表切分与硬件并行的大量工作,都在继续处理这项代价。 07 实验到底证明了什么 语言模型通常用困惑度(perplexity)评估。若测试序列平均负对数似然为: NLL = -(1/T) Σ_t log P(w_t | context_t) 那么困惑度为: PPL = exp(NLL) 它可以理解为模型面对每一步预测时的平均不确定程度;数值越低越好。由于概率相乘会迅速变小,实验实际计算的是对数概率。
论文在两个英语语料集上做了主要实验:
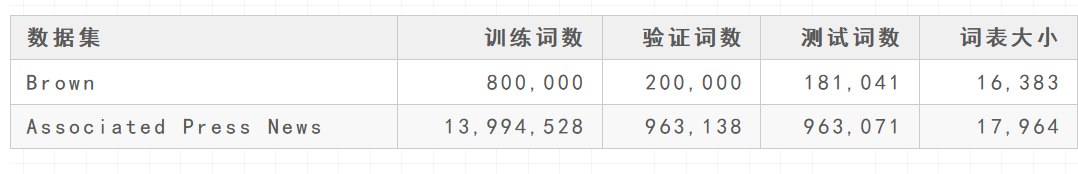
Brown 语料的表格中,单个隐藏层配置MLP1在不与 trigram 混合时,测试困惑度达到 268;表现最好的神经模型与 trigram 混合结果是 252。论文列出的最佳 class-based n-gram 为 312,Modified Kneser–Ney 系列大约在 321—323。 Associated Press News 上,最佳神经模型与 trigram 的混合结果是 109,表中最佳 Kneser–Ney 结果是 117。 这些数字支持三点结论。 第一,学习连续词表示确实能改善未见或稀疏组合的概率估计。第二,神经模型和 trigram 具有互补性:最佳结果来自混合,而不是把传统模型完全丢掉。第三,在 Brown 语料的相关配置中,扩大神经模型的上下文长度带来了收益,而表中更高阶的 n-gram 没有呈现同样改善,这与两类模型的泛化方式差异相符。 同时也要控制结论边界。这不是“所有纯神经模型都击败所有 n-gram”的证明:论文的最佳数字包含插值混合,超参数和算力也会显著影响结果。它证明的是,在当时的两个语料与实验设置下,联合学习的分布式表示提供了传统离散平滑之外的有效泛化来源。 08 哪些设计保留到了今天 把 2003 年模型与今天的大语言模型并排观察,会同时看到清晰的继承关系和巨大的结构变化。
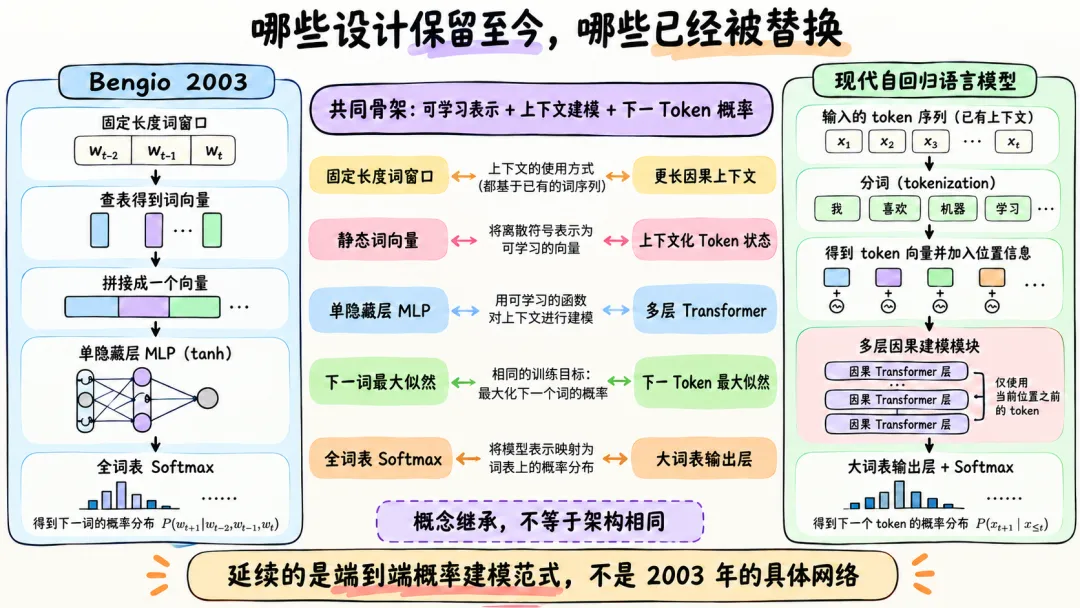
保留下来的核心思想包括: 「查表式可学习表示」:离散 token 先映射为连续向量; 「端到端联合训练」:表示层不是独立特征工程,而是由预测目标共同塑造; 「下一 token 概率建模」:训练仍可写成条件概率对数似然之和; 「共享参数带来的泛化」:相似上下文经过同一组权重处理,统计证据可以跨样本迁移; 「大词表输出的成本」:输出投影和 Softmax 至今仍是显存、计算与并行设计的重要部分。 被替换或大幅扩展的部分也同样关键:
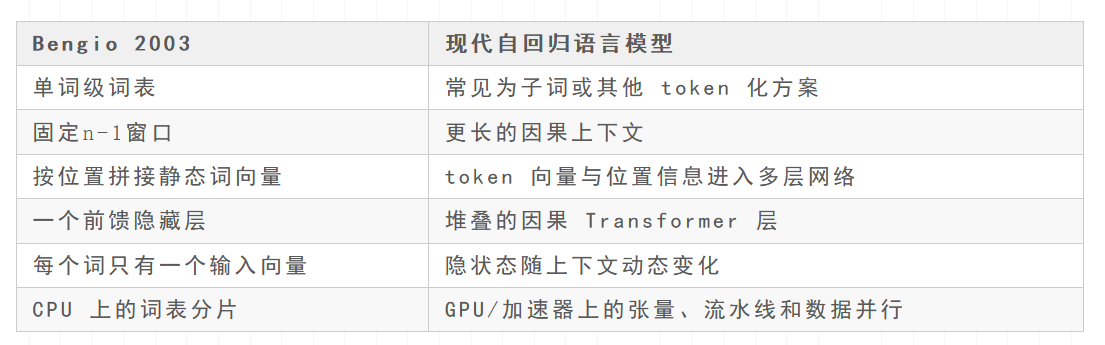
因此,称这篇论文“已经发明了 Transformer”并不准确;称它“第一次提出词向量”也不准确。它更重要的历史位置是:把「可学习的分布式词表示、神经网络上下文函数与规范化语言概率」组织成一个清晰、可联合优化、可在大词表语料上验证的系统。 现代模型的网络主体已经完全不同,但训练范式的骨架仍能辨认出来:离散 token 进入连续空间,经过共享的可微函数形成上下文状态,再通过词表分布预测下一个 token。 09 一张图总结
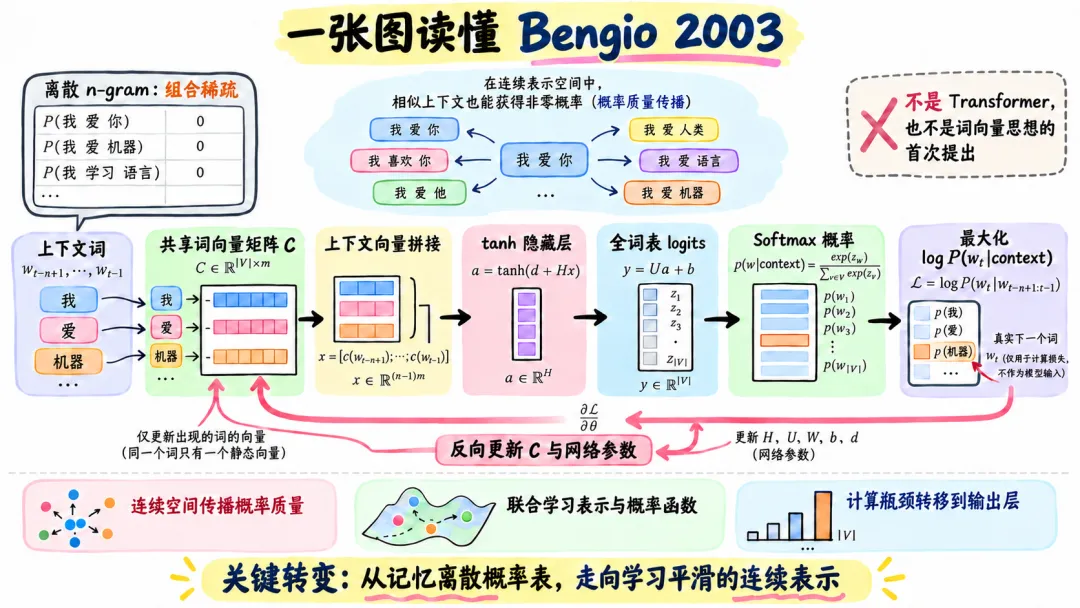
回到这篇论文最初面对的问题,可以把整条技术路线概括为: 离散序列组合数随上下文长度指数增长,完整概率表不可行; n-gram 通过平滑、回退和插值共享统计,但主要依赖缩短上下文; 矩阵C把每个词映射到m维连续空间,近邻词可以共享预测证据; 上下文向量x由最近n-1个词向量拼接,前馈网络计算隐藏状态和全词表分数; 词向量与概率模型由同一个最大似然目标联合训练,梯度只更新当前上下文涉及的嵌入行; 参数量从组合爆炸变为近似线性增长,但完整 Softmax 带来了新的计算与通信瓶颈; 实验显示神经模型提供了不同于 n-gram 的泛化能力,而且二者混合能取得更好的困惑度。 它的局限也非常具体:固定窗口截断了更远依赖;每个词只有一个静态向量;单词级词表带来未登录词问题;浅层前馈网络的表达能力有限;全词表 Softmax 又十分昂贵。后来的语言模型几乎逐项改造了这些部件。 但论文完成的范式转移没有消失:语言模型不再只是查询离散计数表,而是开始在一个由任务目标塑造的连续空间里学习“哪些上下文应该彼此接近”。这一步把统计语言建模真正带进了可学习表示时代。