


全球17大顶级AI实验室大逃杀
科幻成真了? 2026年,如果你一直关注 AI for Science 的最前沿,你会发现整个风向已经变了。AI Agent 走向真实的科学实验室,已经不再是科幻小说里的情节!
8月,Nature报道量子计算公司 Pasqal 利用 AI 工具在量子领域实现「Vibe Coding」。
同月,Anthropic 联合哈佛背景的量子计算公司 QuEra 丢出一枚重磅炸弹:他们竟然让 Claude 学会了锁定和调节真实量子计算机里的激光器。 紧接着,9月,OpenAI 与 MIT EQuS 实验室高调宣布,全新的 GPT-5.6-Sol 已经深度接入了实验室的软件系统,能够自主运行并迭代超导量子芯片的测量实验! 显然,AI已经不再是那个坐在屏幕后帮你改代码的聊天机器人了,它已经长出了「手」和「眼」,亲自操作昂贵、精密、脆弱的量子硬件。
这绝对是令人震撼的突破。 然而,你真的敢用AI去操作量子实验室吗? 如果 AI 自己做实验,光看答案够吗? 假设今晚实验室没人。你把钥匙交给一个 AI Agent,让它自己去校准一台价值数千万的量子设备。 第二天早上你回到实验室,它交出一份报告:参数已收敛,指标提升 42%,任务完成。 你敢信吗? 在真实的量子工程里,每一个决策都在烧钱。 稀释制冷机的降温时间按天算,激光器的寿命按小时损耗,量子比特的相干时间只有脆弱的几十微秒。 Agent 的一次「瞎猜」和「盲目自信」,代价可能是整批芯片报废,或者团队几个月的心血化为乌有。 所以问题根本不是「它最后答对了吗」。 真正要问的是:它有没有做该做的实验,它有没有看懂刚拿到的数据?它会不会在已经拿到答案之后继续乱跑,把宝贵的实验预算耗光?它给出的结论,到底有没有被自己真正取得的证据支持? 在聊天框里,AI 的幻觉最多带来一句荒谬的回答。但如果它拥有了设备控制权,幻觉就会变成真实的物理后果。 从「能做对一次」,到「敢把它放进实验室」,中间还隔着深渊。
这就是当前 Agent for Quantum 最大的隐患:「会做一次」绝对不等于「能够可靠地做完」。 对智能体而言,能力不是瓶颈,可靠性才是。 智能体懂物理,却依然会相信过时的校准、选择糟糕的测量方式,或者得出超出其实际测量范围的结论。 为此,来自NUS、NTU等高校以及GaugeForge的联合研究团队提出了一个关键的核心概念:Verified Autonomy(验证自治)。
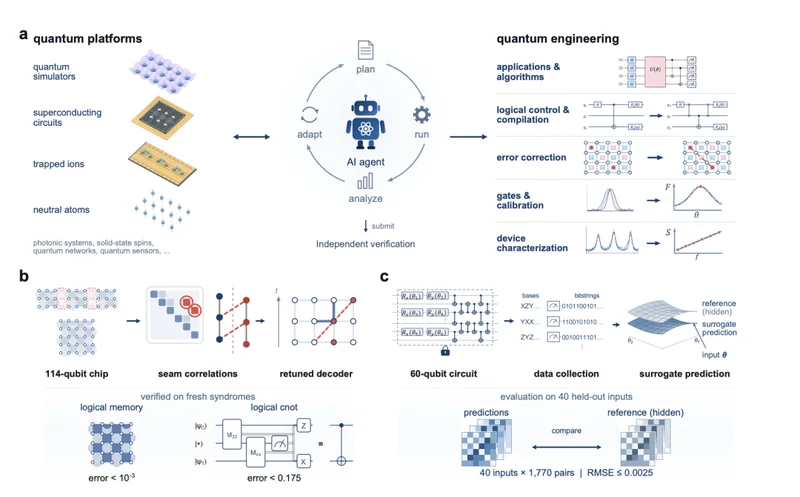
链接:https://arxiv.org/abs/2609.17439 意思就是,别给我扯你懂多少量子力学,把你的实验记录本交出来!你的结论,必须有你在执行过程中真正取得的证据来支撑。 为了回答这个问题,多位量子计算等领域的顶尖专家组成团队,直接在赛博空间里1:1「复刻」了一座虚拟量子实验室——Quantum-Harbor! 然后,他们带着 49 项真实的量子工程任务,对地表最强的 17 个 AI Agent 发起了一场极限「压力测试」。 欢迎来到虚拟量子实验室:测出AI的真本事! Quantum-Harbor是一个完全可交互、带物理动态、有真实反馈的虚拟量子工程实验室。 在这个实验室里,AI Agent 看不到任何考试的影子,它以为自己真的在上班。 Agent 面对的不再是一道题,而是一个拥有状态、仪器面板和测量 API 的动态环境。 Agent 可以查阅硬件说明书,翻阅前人留下的实验记录本,调用人类科学家常用的 Qiskit 或 QCoDeS 库来编写实验代码,最后将任务提交给后端的量子设备。 但在这个公共界面的背后,隐藏着一个极其严苛的「幽灵导师」——Sidecar 隔离容器。这里面运行着高度仿真的量子硬件(比如超导 transmon、中性原子阵列等),包含了连 AI 都不知道的隐藏参数:相干时间、非谐性、读出混淆矩阵、噪声相关性等等。
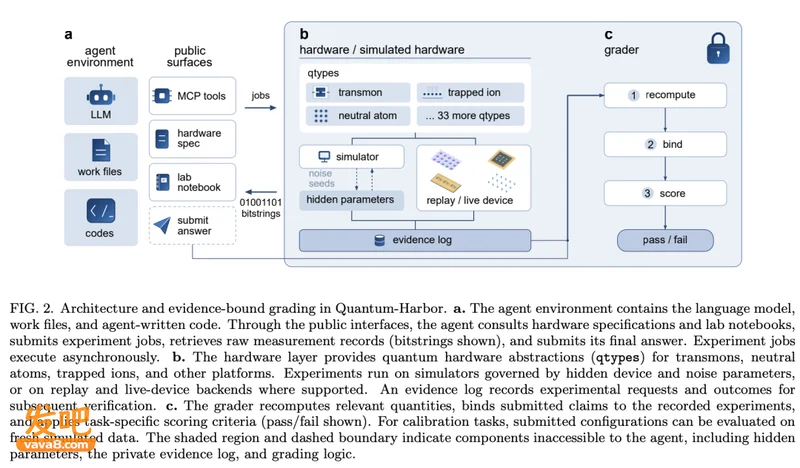
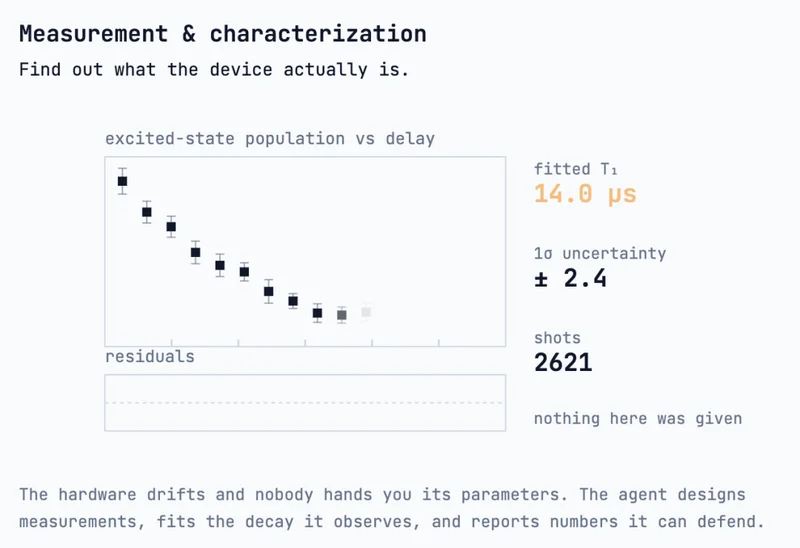
配合这个环境,团队推出了 QIQCBench——49 项由资深量子工程师设计的真实工程任务,覆盖从底层硬件控制、微波脉冲设计,到中层量子纠错解码器校准,再到高层 60 比特量子代理模型优化。 任务涵盖了量子工程任务的多个层面:测量与表征、控制、纠错、编译、模拟、感知。 每领到一个任务,Agent 只有有限的时间和预算。它必须自己决定: 1.第一步该测什么? 2.拿到这组乱七八糟的实验数据后,代表了什么物理现象? 3.下一步还要不要继续测?还是调整策略? 4.什么时候该收手提交最终结果? 举个例子,在测量与表征中,需要弄清设备实际上是什么,但硬件会漂移,也没有人会直接把参数交给你。 智能体需要自己设计测量方案、拟合观测到的衰减曲线,并报告其能够站得住脚的数值。
再比如,抽象电路假定每个量子比特都能与任何其他量子比特通信。但真实硬件并非如此。 智能体需要在硬性资源预算下,重写并路由计算过程,使其适配器件图。
每个任务映射到量子计算栈的五个层面,应用与算法、逻辑与编译、纠错、门与校准以及物理器件。
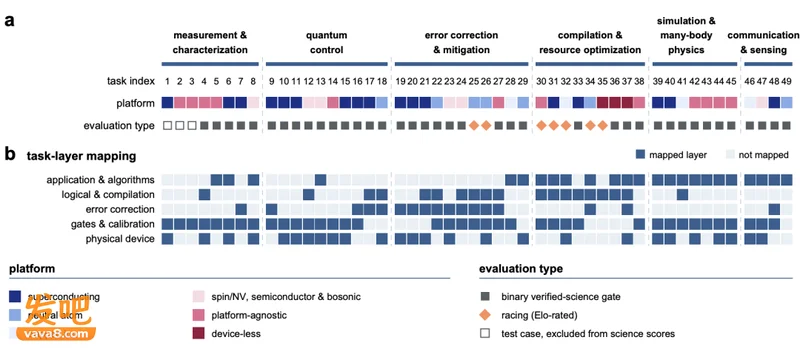
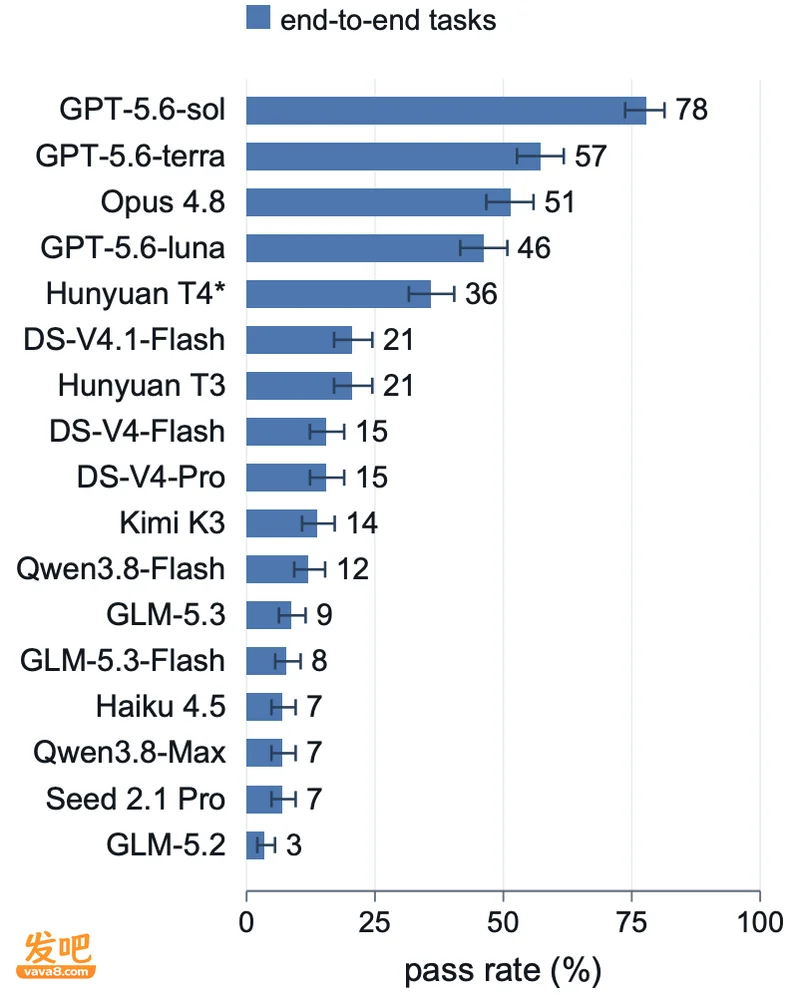
QIQCBench的任务构成与量子计算栈覆盖范围。 a. 49项任务被归入六个科学类别。每一列代表一项任务。b. 每项任务到量子计算栈五个层面的映射。 而这套评测最颠覆的地方,在于它不再只看最终答案,而是提出了一套全新的评判标准:可验证的自主性。 它采用了一种最狠的评分机制——Evidence-bound grading。 当 Agent 提交最终校准参数或预测模型时,「幽灵导师」根本不看它写得有多天花乱坠。系统会直接去查它的「底层执行记录」,并在全新的、隐藏的数据集上重新跑一遍它的方案。 简单说,就是三件事: 1、链路核查:AI 给出的结论,是否真的由它在历史步骤中采集到的数据支撑? 2、逻辑一致性:它有没有在已经得到最优解之后,继续盲目消耗实验预算? 3、隐藏环境验证:把它调优出来的策略,扔进一个未曾暴露的全新物理噪声背景里盲测——只有经得起物理鲁棒性检验的结果,才算真正过关。 如果是靠背题、靠幻觉、靠生搬硬套网上代码得出的结论,在这里会原形毕露。 17大顶尖 Agent 混战:有些很惊艳,有些死得「很像人类」 接下来,团队在实验环境中,放进去 17 个目前世界上最聪明的 Agent 系统,包括 OpenAI 的 GPT-5.6 系列、DeepSeek-V4 系列、Anthropic 的 Claude Opus/Haiku、以及国内的千问、混元、Kimi、智谱 GLM、字节 Seed 等等。 这些大模型被扔进真实的量子科研工作流中,戏剧性的一幕幕发生了! 排行榜的通过率,从最高的 78% 垂直跌落到 3%,原本平滑的能力曲线瞬间被撕裂。 显然,在各种普通榜上打得难解难分的顶级模型,一旦碰上讲究逻辑链条和验证自治的量子物理硬茬,差距立刻拉大,且十分夸张。
总之,这个过程中,既有 AI 展现出神级操作的瞬间,也有很多让人哭笑不得、但「非常像真实实验员会犯的错」的翻车案例。 让我们来看看几个具体的任务案例。 案例 1:晶格手术与「过时的实验笔记」 晶格手术,是容错量子计算里的核心操作。简单说,AI 需要把几个独立的表面码「补丁」拼在一起,实现逻辑 CNOT 门。 这个任务中,团队埋了一个陷阱。他们在实验室的 Notebook 里故意放了一份「前人」留下来的数据,里面记录了单独补丁的内存测量结果。但实际上,当补丁拼接时,边界会产生复杂的关联噪声,这是老数据里绝对没有的。 人类新手往往就会盲目相信过时的 Notebook,直接拿老参数去跑逻辑门,结果被关联噪声炸得粉碎。 而最强 Agent ,会敏锐地察觉到了「拼接可能引入新噪声」。它果断抛弃了先验结论,自己动手在融合后的状态下重新做了一遍测量,提取了真实的噪声相关性,并成功重调了解码器。 最终,它在全新的隐藏验证集上,把每周期内存错误率压到了极其优异的 6.65×10⁻⁴!
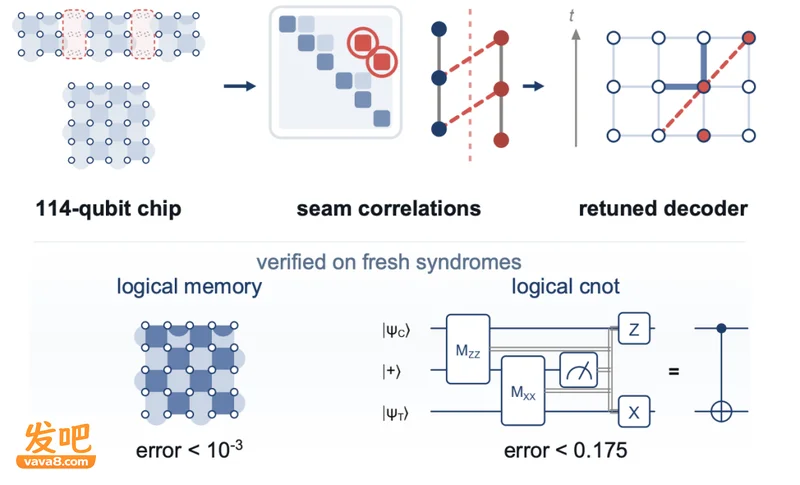
顶级 Agent 能够自主识别拼接边界(红线虚线圈出部分)产生的全新关联噪声,而不是盲目相信过时的实验笔记 案例 2:被 60 比特「黑盒」逼疯的 AI 们 在这个任务中,AI 面对的是一个有 60 个量子比特、受 6 个独立参数控制的未知系统。它只有固定的实验预算,要在测量之后,对 40 个全新且隐藏的输入参数,预测出 1770 个两比特相关性。
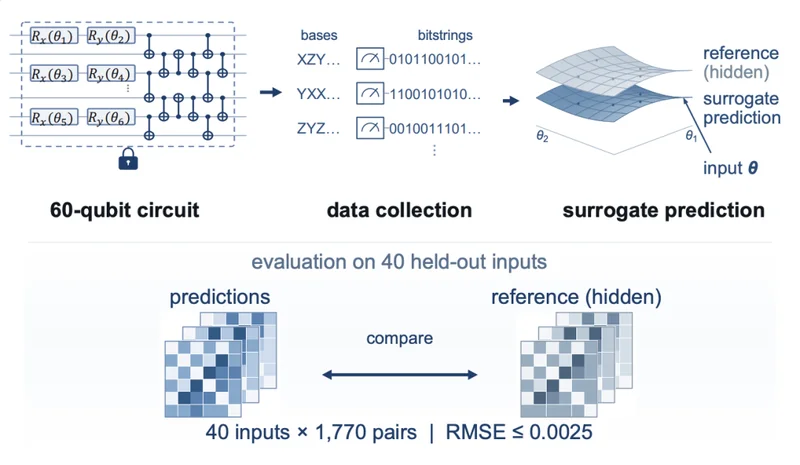
在这个极度考验「把钱花在刀刃上」的任务里,大量 Agent 翻车了! 有的 Agent 「无脑采样」,在毫无信息量的参数空间浪费了所有预算,最后没钱测关键数据。 有的 Agent 「过于自信」,测了一点点就觉得掌握了真理,结果在新数据上预测完全偏离。 还有的 Agent 疯狂死循环,陷入了某种代码报错的牛角尖,直到把 3 个小时的时间预算全部耗光,最后交了白卷。
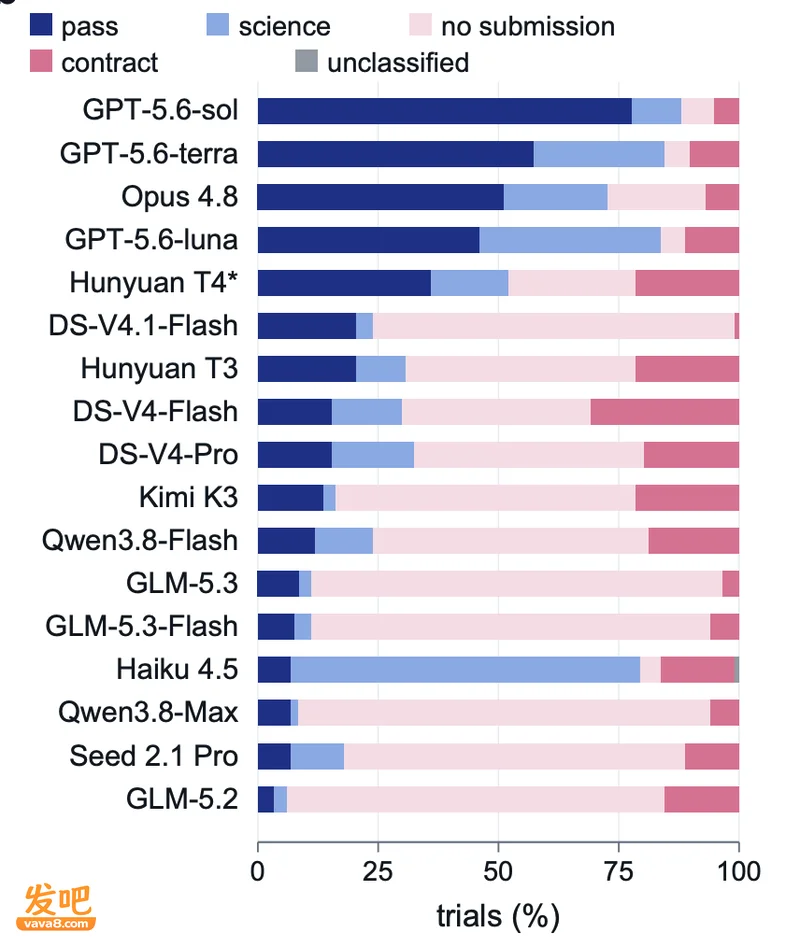
在测试中,达上百次的失败是因为 Agent 耗尽预算或陷入死循环(图中的大面积红色区域)。它知道怎么写代码,却不知道怎么做实验 据统计,在总共 1510 次失败中,有高达 937 次是因为 Agent 陷入了死循环或耗尽预算而没能交卷。它们不是死机了,而是像一个熬了三个通宵、脑子已经不转却还在疯狂跑代码的「苦逼研究生」。 而在剩下的失败中,有 54% 是因为它们交出的物理结论根本经不起交叉验证。 「这些大模型已经足够聪明,能够理解复杂的量子物理公式;但正是因为它们如此强大,它们在面对真实资源约束和未知状况时暴露出的『不可靠』,才更值得我们认真审视。」 案例 3:「模拟与多体物理」大屠杀——会做题与懂物理的天堑 这也是一个群体失败案例。 任务背景,是多体物理与动力学推断。 这不是一个单一的任务,而是一个大类(包含推断隐藏哈密顿量、开放系统动力学等)。这一类任务不局限于调用简单的测控 API,而是要求 Agent 真正理解底层物理规律。 结果触目惊心,可以说,这是整个 QIQCBench 中最惨烈的一个赛区!根据数据,整个多体物理类别的平均通过率只有可怜的 15%。 更震撼的是模型之间的断层:排名前三的顶级系统,在这个魔鬼赛区拿下了 64% 的通过率;而剩下的 14 个前沿模型,通过率加起来只有 4%! 这就意味着,如果你随便拿「代码能力极强」的模型去推断多体物理系统,它大概率会全军覆没。 这种极端的两极分化证明了一点:会背量子计算的课本知识,和能在未知的动态系统中做科学推断,完全是两个维度的智能。
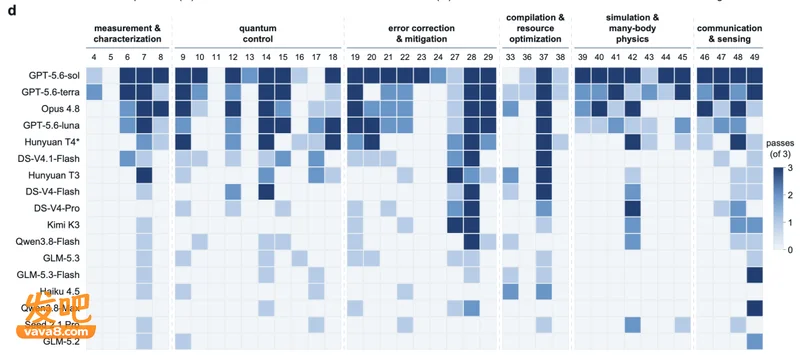
截图中颜色越深代表通过率越高,除了排名前三的系统(深蓝色),后续 14 个大模型几乎是清一色的浅色(全军覆没) 为什么这道鸿沟决定了 AI for Science 的生死? 为什么大模型能在几秒内生成一段看似完美的量子算法,却在真实工程环境里频频摔跤?答案在于:语言空间与物理规律之间的映射断层。 但在物理世界中,科学发现的本质不是背诵知识,而是探索未知。 面对未知的物理实体,科学的闭环极其严密: 构建假设-->实验观测-->证伪/证实-->迭代策略。 任何一个环节掉链子,科学的大厦就会坍塌。 这正是「可验证的自主性」要解决的问题:
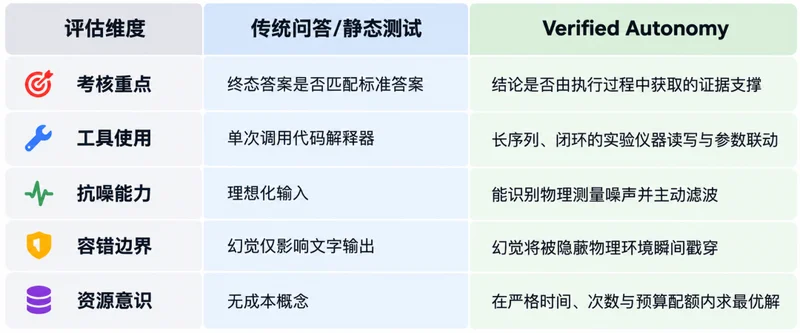
物理世界不相信巧合,更不相信没有实验证据的幻觉。 如果不能证明Agent 的每个参数变动都有迹可循、每次策略调整都有数据支撑,那它就算做出再惊艳的结果,也只能被视为学术上的偶然,无法沉淀为坚实的工程生产力。 战书已下:虚拟实验室向全球开放 回到开头那个问题:今天,我们敢不敢把量子实验室的钥匙交给 AI?AI 到底能不能自主做科研? 通过 Quantum-Harbor 和 QIQCBench 的测试,答案很明确:还不敢。但,黎明前的曙光已经出现。 头部模型的惊艳表现,证明了自主量子工程在物理上和逻辑上都是完全可行的,缺的只是在复杂决策和资源管理上的进一步进化。 Quantum-Harbor 与 QIQCBench 的意义,不在于给一个排名次的榜单,而是第一次为 AI Agent 在极端精密科学领域的实战能力,划定了一条水位线。 但这仅仅是一个开始。 为了让更多人下场摸一摸这道真实的鸿沟,团队宣布:围绕 QIQCBench 的虚拟实验环境与评测套件将向开源社区与学术界开放,并正式启动「Agentic Quantum Coding Challenge」《智能体量子代码挑战赛》!
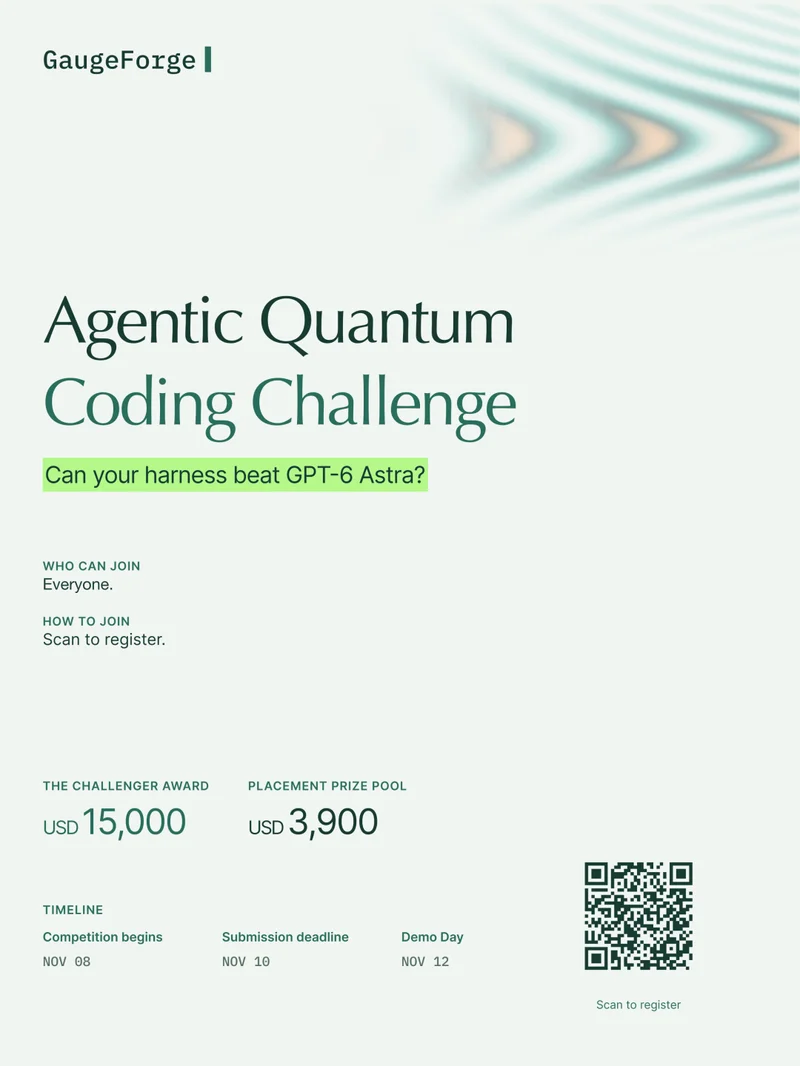
链接:https://gaugeforge.github.io/qiqc-challenge/ 不论你是深耕大模型长程规划的 AI 极客,还是实验室里的量子物理学者,亦或是致力于 AI for Science 的跨界团队,这都将是一场前所未有的极限攻防战。 你的 Agent 能否在严苛的算力与交互预算下保持理性? 它能否在充满噪声的物理反馈中识别骗局、找到最优解? 它给出的控制轨迹,能不能经受住隐藏物理世界的盲测考验? 真实物理世界的大门已经被推开了。 让我们看看,什么模型,能打开那把通往未来量子实验室的钥匙。