


美国AI对中国的领先优势,只剩3%
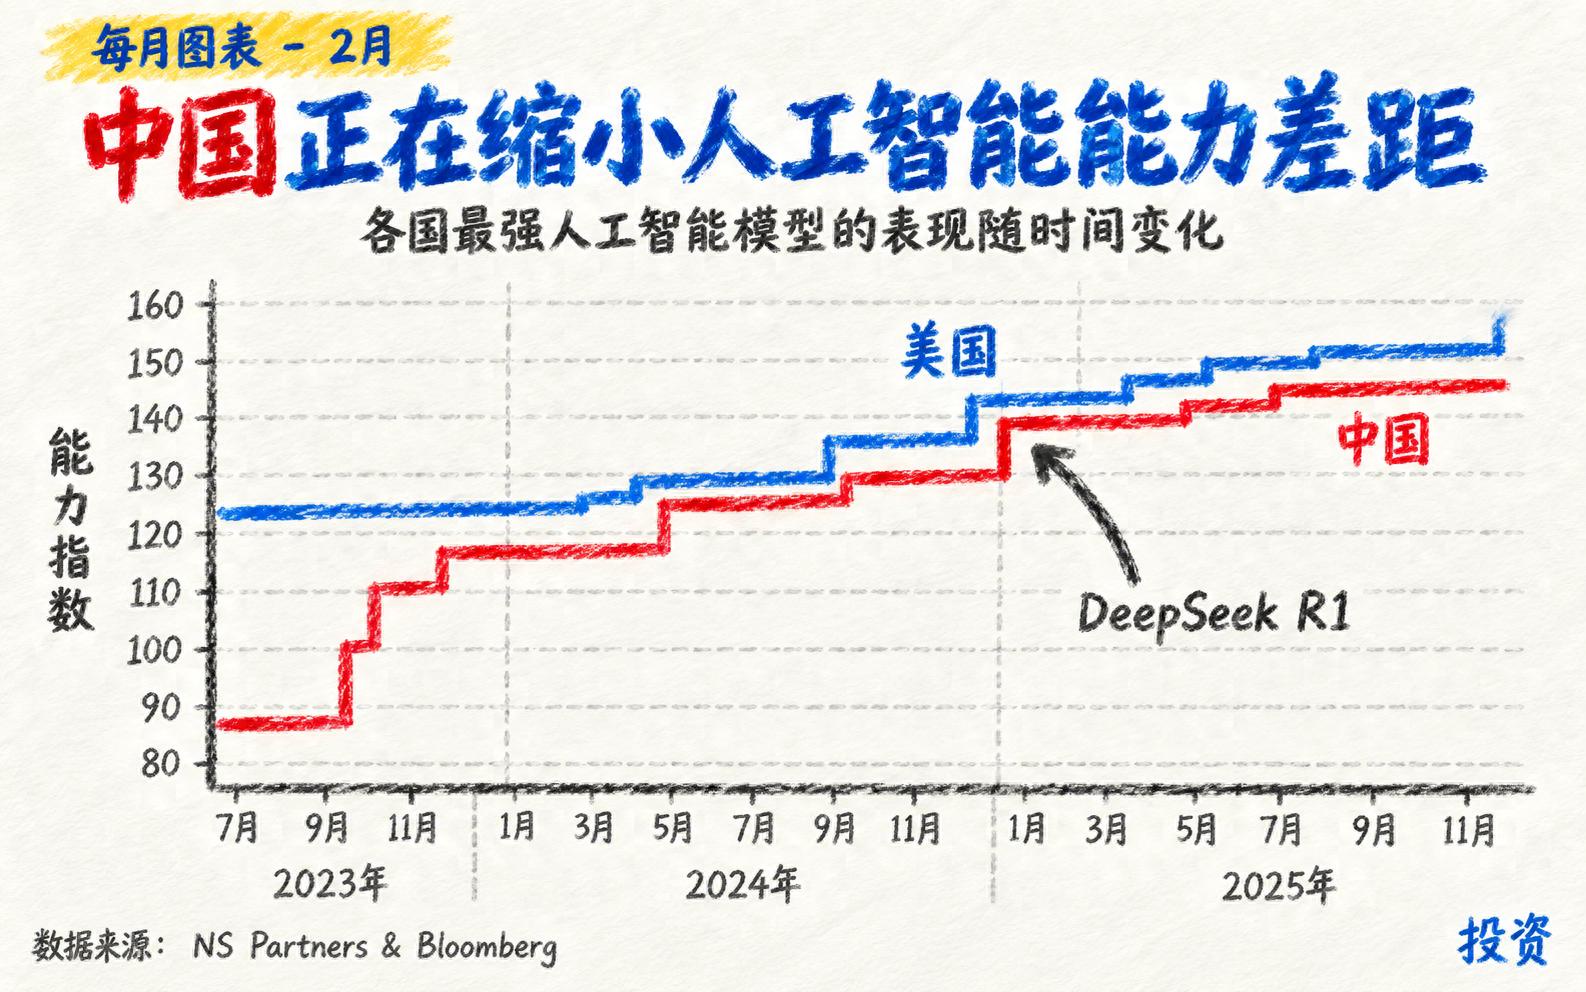
根据彭博行业研究(Bloomberg Intelligence)高级分析师罗伯特·利亚(Robert Lea)最新发布的重磅报告,随着 DeepSeek 在 9 月推出全新的 V4.1 Flash 模型,中美顶尖 AI 大模型在权威基准测试中的得分差距,已经被硬生生压缩到了历史最低的 3%!
如果把时间线拉长,你会发现这个追赶曲线简直像是在打极速飙车攻防战: 今年年初,中美顶尖 AI 的测试得分差距还是 15%; 到了 5 月,这个差距被压缩到了约 9%; 而到了 9 月 V4.1 Flash 闪亮登场,差距直接被怼到了只剩 3%。 在衡量大模型综合硬实力的权威跑分榜单 LiveBench 上,DeepSeek 飙出了 81.1 的惊艳高分,距离硅谷巨头 Anthropic 拿下的最高分 83.4,仅仅相差 2.3 分! 在上一月的全球总榜中位列第六,这也是自 2025 年 DeepSeek-R1 震撼破圈以来,中国大模型在全球权威榜单上拿到的最高名次。 彭博分析师罗伯特·利亚在报告中直白地表示:中国顶级模型的表现,已经完全可以与 Anthropic、OpenAI 等硅谷领靠者的旗舰系统相媲美。
一、硅谷的“算力暴政” vs 中国的“极致微操” 只要了解过这两年科技圈故事的人都知道,这个 3% 的含金量究竟有多么夸张。 在硅谷,巨头们搞 AI 的逻辑向来是豪横且粗暴的“大力出奇迹”。 OpenAI 和微软动辄规划上千亿美元的超级数据中心,恨不得把英伟达最新的 B200 芯片整箱整箱地往机房里搬,算力不够就打算直接盖核电站,属于典型的“算力暴政”。
而中国团队面临的,则是华盛顿一轮又一轮严丝合缝的芯片禁令。英伟达最顶级的显卡买不到,甚至连“特供版”都要面临各种变数。 如果用赛车来比喻,硅谷就像是背靠无限财力的土豪车队,直接买下了顶配 V12 发动机的超级跑车,在平直的高速公路上开足马力一路狂飙; 而梁文峰和他的 DeepSeek 团队,就像是用着现有排量的发动机,硬生生凭借着对每一个零件的深度重构、对底盘的极致轻量化和弯道超车技巧,在充满挑战的赛道上,死死贴住了对方的尾灯!
二、把技术细节拆开看:不靠堆卡,靠什么? 很多人好奇,在高端芯片被严重限制的前提下,DeepSeek 到底凭什么能实现这种弯道逼近? 答案正如彭博报告所指出的:关键根本不是盲目堆卡,而是把模型优化到了国产硬件上,还能把性能顶到全球第一梯队。 在过去,很多大厂做大模型的思路是“躺平等摩尔定律”——反正硅谷会开发出更好的算法,英伟达会造出更快的显卡,大家只要拿现成的开源架构改改,拿钱买卡刷数据就行了。但梁文峰很早就意识到,这种“拿来主义”在禁运面前根本走不通。
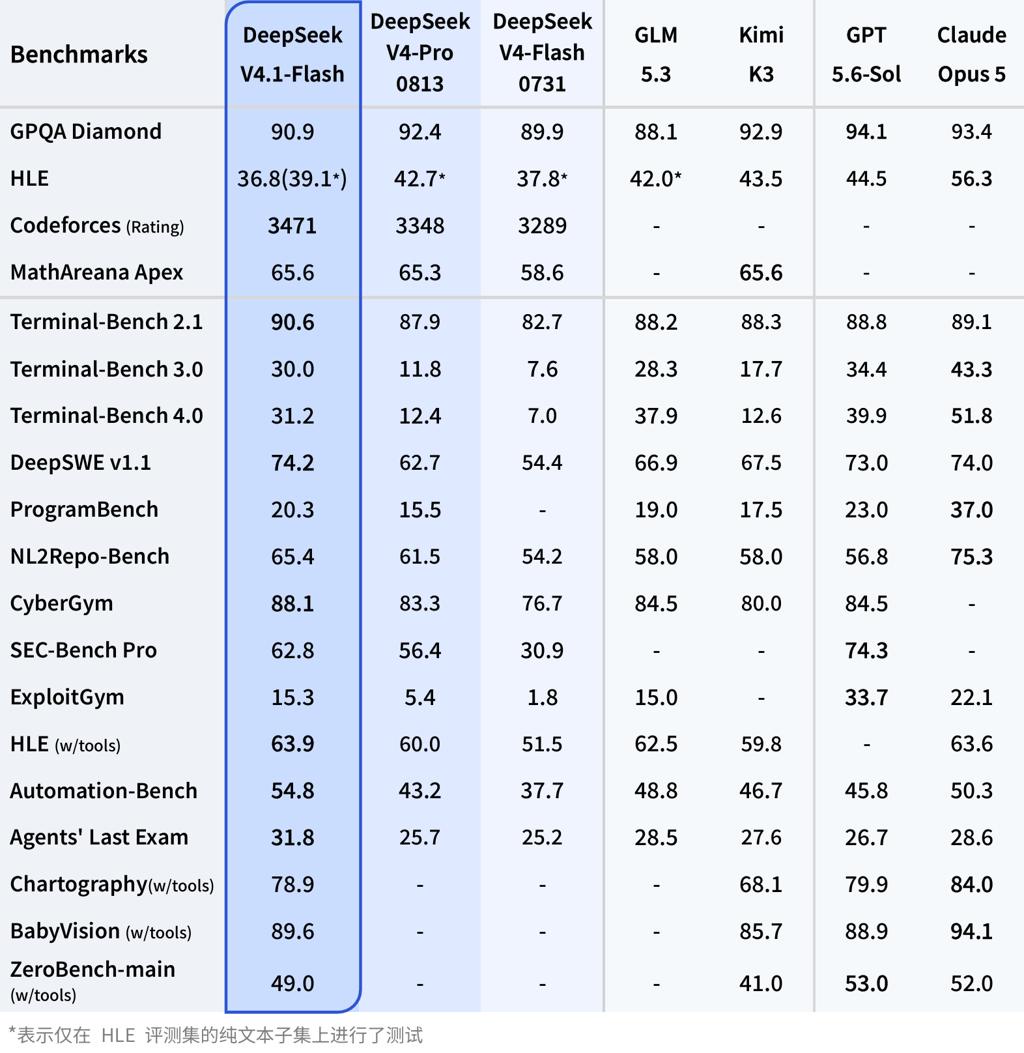
V4.1-Flash 参数 为了把有限的算力榨干到极限,DeepSeek 团队在架构和工程层面搞了一系列堪称魔鬼级别的“降维打击”: 第一,是混合专家架构(MoE)与动态调度的极智利用。 传统的全量大模型就像是公司里每碰到一个简单问题,都要把全公司几千号员工全叫来开会,不仅耗费巨量算力,还极度卡顿。 而 MoE 架构就像是建立了精细的“专家问诊”机制,每次提问只精准激活两三个最擅长的“专家模块”。DeepSeek 更是把这种分工做到了极致,让单位算力下的智商产出比高得吓人。 第二,是算法与国产芯片的“深层次交融”。 以前国产芯片用起来顺手度不如英伟达,很大程度上是因为底层软件优化跟不上,导致硬件算力跑不满。 DeepSeek 团队没有被动等待生态成熟,而是直接深入底层,针对国产硬件(如华为昇腾等)的算力结构和带宽特点,手把手进行底层算术指令和内存调度的适配。 这相当于给国产芯片量身定制了一套“特技驾驶软件”,把原本可能沉睡的硬件性能完全释放了出来。 通过这种“软硬协同优化”,中国工程师们成功克服了原本在训练效率和数据效率上的算力劣势,把看似不可逾越的硬件鸿沟,在软件层面抹平了大半。
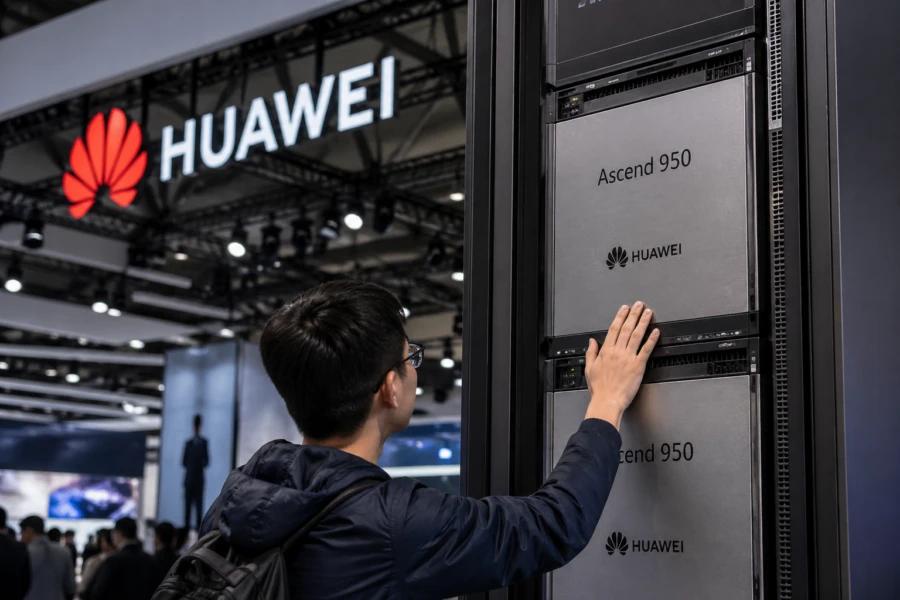
三、华盛顿的尴尬:制裁反而逼出了“最强满血态”? 这不禁让人联想起一个极其具有讽刺意味的现象。 美国商务部当初不遗余力地出台出口管制,本意是想用芯片这把“锁”,把中国 AI 死死锁定在低端梯队。 可他们万万没想到,这种封锁反而打破了中国产业界对西方硬件的路径依赖,倒逼出一支不依靠“算力堆叠”、专攻“架构创新”与“国产适配”的铁骑军。 正如彭博高级分析师罗伯特·利亚所言:中国人工智能的快速崛起和国产硬件适配能力,正让越来越多的人开始怀疑,美国在 AI 领域长期保持的技术优势,究竟还能维持多久? 这哪里是卡住了脖子,这分明是给中国大模型研发团队打了一剂“硬核进化血清”。 当硅谷的巨头们还在为算力账单肉疼、为了争夺几万块 GPU 打得头破血流时,DeepSeek 已经用实际行动证明:比显卡数量更宝贵的,是架构创新的脑洞和把硬件性能榨干到极限的工匠精神。
四、冷静看差距:3% 之后,还有很长的路 当然,看到 3% 这个令人振奋的数据,我们依然需要保持客观与清醒。 从整体格局来看,在全球前 15 名的顶尖大模型榜单中,中国模型目前也仅占了 3 席;榜单上的排名瞬息万变,硅谷巨头们下一次迭代随时可能再次拉开差距;更重要的是,大模型在商业化落地和盈利闭环上,全球范围内都还在摸索之中。 从 15% 缩减到 3%,这只是阶段性战役的胜利,绝非终局的鸣金收兵。 但这一分数的改变,已经向全世界传递了一个无比清晰的信号: 硬件的出口禁令,可以强行划定算力的下限;但人类对于技术突破的创造力与智慧,永远无法被一张禁令划出上限。 从 15% 到 3%,那些试图靠封锁阻挡中国 AI 前进步伐的壁垒,已经清清楚楚地被改写成了榜单上的跑分数据。这场全球人工智能的顶峰较量,真正的精彩戏码,现在才刚刚开始!