Jev估值100亿:创始人回答一切
他来了他来了,TypeSafe AI的联合创始人兼CEO Diogo Almeida,顶着一头新染的红发闪亮登场了!(doge
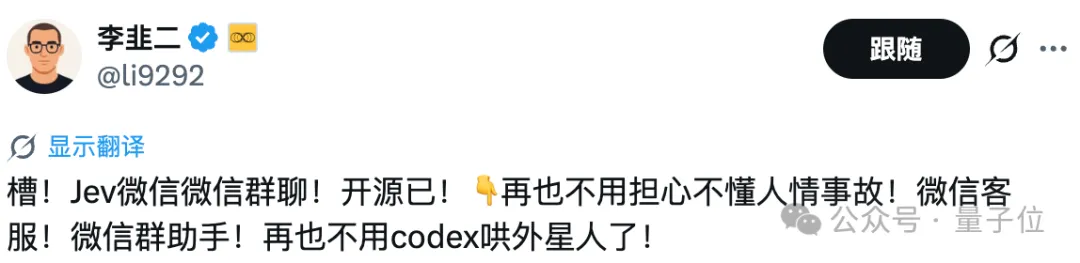
Diogo在最新一期Latent Space访谈中坦言: 公开benchmark极其容易被操纵,即便开发者没有主动作弊,最终也可能被榜单牵着走。 所以相比于一张通用榜单,他更愿意相信长期积累的产品体验与信任: 直到你把模型放进自己的工作流,并针对那个工作流去评估、去测量,才能判断它在真正重要的流程中表现如何。 甚至还大胆开麦: 当年身在OpenAI,我深深感受到了什么叫无力… 666,Diogo这是真没拿我们当外人,啥都往外说啊。 这几天,Jev这款“不会聊天、只会做决定”的模型火爆全网。 有人用它来筛选海量论文;有人用它来提前拿捏客户的需求;甚至还有人连夜开源了一个“Jev聊天助手”,可以提前预判老板的预判、以及对象闹别扭到底是为了啥,并一键生成几条最合适的回复供你选择:
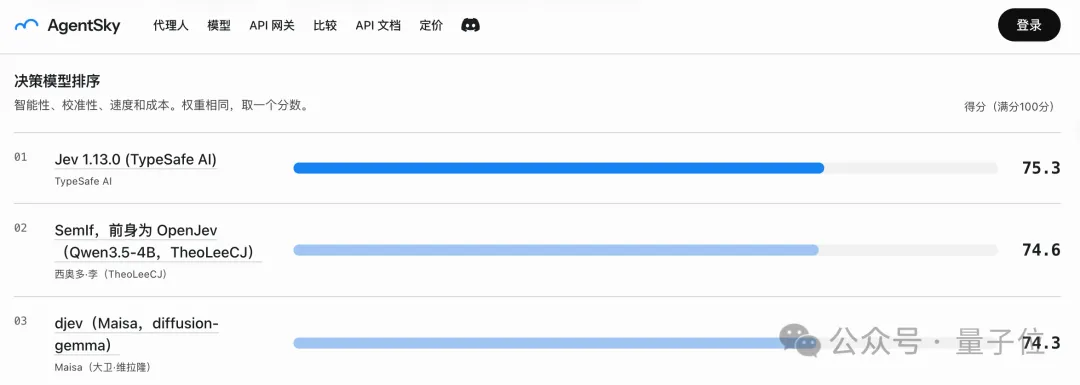
好家伙,再也不用为猜不透老板和对象的心思焦头烂额了?! Jev的成绩也相当能打。 短短6天,Jev发布视频的浏览量便突破了3870万;在第三方JevBench v1.2.1综合榜中,Jev 1.13.0也以75.3分排名第一。
我火速把访谈内容整理了出来,重点笔记如下: 现在整个行业都在卷速度、拼成本,反倒把可靠性给弄丢了;但可靠性才是一款产品真正的灵魂,也是大家敢于托付信任的关键。 我并不仇视OpenAI,但既然AI能破解千禧年大奖难题,那为什么他们在有经济价值的实际工作上贡献几乎为零? 拉动TFP(全要素生产率)增长,才是衡量AI经济革命真正的标尺,我们的目标就是在五年内拉动3%。 我已经厌倦AI永远站在舞台中央;世界本身就应该更有趣,AI 只需要退到幕后,默默提供辅助。 目前的AI编码,本质上仍是围绕单一模型展开的竞争,只是提供不同档位供用户选择;所以当下各家开源coding agent的能力差距并不大,while循环能实现的能力边界是有限的。 一旦某一家做出独有的杀手级场景,所有人都会蜂拥而至,而开源项目则可以快速复刻这套能力。 就算给我十亿美元(约71.3亿元),我也不会选择从零开始预训练大模型的!因为预训练实在太·烧·钱·了! 全程高能,大家速看! AI连难题都能攻克,为什么还干不了多少实际工作? 主持人(swyx):Jev爆火之后,你感觉如何? Diogo Almeida:说实话,我觉得自己已经被榨干了,每天只剩一副筋疲力尽的躯壳四处飘荡。 事情铺天盖地砸过来,而我是技术出身的CEO,所以每天需要到处救火。 这几年我一直在讲,整个AI行业就像游乐园里的镜子屋;大家都有点脱离现实,说着很多逻辑根本对不上的话。 但就在这周,整个行业终于被拉回了现实。 大家开始意识到AI比之前想象得强大得多,由AI驱动经济变革,也再次成了行业认真讨论的议题。 我经常在演讲里抛出一个问题,即“AI已经聪明到足以挑战千禧年大奖难题,为什么还是没法自动化大量最基础的工作?” 这些工作的门槛不高,也没什么职业成就感,人类本来可以去做更有意思的事,但现在仍然被困在这些重复、枯燥的任务里。 根本原因就是我们还没法把它们自动化。 就好比我们手里有一台动力强悍的自动化引擎,却找不到合适的接口,接不进真正有商业价值的业务场景。
主持人:有道理,行业里还有很多全新的模型范式等着我们去探索,应该百花齐放。 Diogo Almeida:我觉得早期互联网那种蓬勃的活力回来了,技术乌托邦的浪潮也回来了。 不再是coding agent时灵时不灵、顶尖能力全被锁在大厂内部的那一套,现在,每个人又都有机会参与创造了。 但这会是一片狂野的新大陆,请大家系好安全带。 主持人:能不能分享一些可以对外披露的数据,比如注册量之类的指标?
Diogo Almeida:我们的日处理量已经突破一万亿token,而且不是昙花一现的峰值,夜间流量也在持续走高。 这说明大量调用来自机器自动化,不只是普通用户尝鲜。 目前日吞吐一万亿token的这个规模也相当可观,能做到这个数字让我感到非常振奋。 而注册量对我来说其实就没那么重要了。 坦白讲,这算是我们踩过的一个小坑;推特上有人调侃我们是营销天才,但我们几乎没有市场团队,所谓“营销”,也只是带着一股直白、略显笨拙的劲儿,持续向候补名单上的用户开放注册。 但我们之前没意识对开发者平台来说,等待名单和注册用户量的参考价值有限; 很大一部分注册用户根本不是开发者,只是进来随便跑几条查询,然后用完后疑惑:“这是什么?它又不是聊天机器人,我的ChatGPT才是。”然后就走了。 我觉得和重度开发者写一段循环批量调用相比,这些注册用户几乎可以忽略不计,因为真正创造价值的是前者。 真正棘手的是调用速率限制(rate-limit)。一旦用户真正从模型里拿到业务价值,就会需要更大的调用配额。 软件系统本来就是这样搭起来的。 你前期投入成本搭建链路,当链路产出的价值超过搭建成本时,你就可以把这套逻辑放到后台持续运行,作为其他系统的依赖,再在上面搭更高层的应用,创造海量现实价值。 早期互联网从业者恐怕很难想象,2000年初的互联网能迸发出多大的能量。 许多颠覆性创新,正是因为不同能力可以自由组合才得以出现。
主持人:你们让我印象很深的一点是,你反复强调可靠性。 我原本以为你们重点聊的是校准,也就是LCD,但实际上你们同样关注服务可用性和可扩展性。 Diogo Almeida:这些都很重要。 因为可靠性不只是服务稳定运行,也包括模型输出是否智能、结果是否稳定、是否符合预期。 推理类的大模型确实够聪明,但可靠性依旧有很大短板。 从许多场景的实际需求来看,模型完全有能力把工作自动化,商业上也有强烈的落地动机,但就是做不到,根源在于模型的优化目标不一样。 可靠性分两层。 一层是你能否信任模型的输出结果; 一层是能否从更多维度保证模型可靠。 我们虽然还暂时没走到第二层,但我对此满怀期待。 通常来说,我们应该先自动化简单工作,再攻克复杂任务。 但我的目标一直都是:开发者不用反复试错,就能确信模型一定能把任务完成。 这就像编程时的心流状态,我写查询指令,只是因为这里需要。 对于不需要复杂分支判断的环节,直接调用TypeSafe的System-One(机器原生、可编程的决策内核)查询直接拿结果,由模型可靠地完成分支逻辑。这就是我们的理想,也是一条漫长而艰难的路。 我的愿景是让软件工程被AI充分赋能,而我最不愿看到的悲剧就是AI明明能力很强,但实际落地使用率却极低。 这件事让我很难平静…我不信奉盲目的技术乐观主义,也不认为所有技术天然向善。 我觉得当下AI的现状是对技术潜力的巨大浪费;我只想让这些尚未释放的技术潜力真正为人所用。
主持人:你觉得最难的部分已经结束了吗? Diogo Almeida:我不认为最难的部分已经结束,未来还会有更多严峻挑战。 如果各类工作顺利实现自动化,GDP显著增长,到处一片狂欢,那或许意味着难关已过,但我并不这么乐观。 现在整个行业都在卷速度、拼成本,反倒把“可靠性”给弄丢了;但说到底,可靠性才是一款产品真正的灵魂,也是我们敢于托付信任的关键。 主持人:你们提出过五年内拉动TFP(全要素生产率)增长3%? Diogo Almeida:没错,我从来没见过哪家实验室把TFP当成目标,但这才是AI经济革命真正的衡量标尺。 这一点其实和OpenAI最初的宪章内核高度契合,只是如今他们不断改写定义,目标逐渐转向追求千亿美元级别的利润。 我并不仇视OpenAI,只是“AI”这个词本身至今没有清晰定义。 OpenAI最初的愿景也是承担世界上绝大多数有经济价值的工作,那为什么直到现在,他们的AI能破解千禧年大奖难题,但在有经济价值的实际工作上贡献几乎为零? 我认为目前几乎所有模型,真正创造的商业价值几乎都还接近于零。 或许已经有微弱起步,但我判断还不到1%。 真正的变革到来时,宏观经济统计数据(如GDP)一定会体现出这一点,那将会是无比激动人心的时刻。
我觉得AI不会带来大规模失业,但会推动社会完成一系列良性转型,让整个世界变得更好。 另外,我已经厌倦AI永远站在舞台中央;世界本身就应该更有趣,AI只需要退到幕后,默默提供辅助。 主持人:从历史背景看来。2019年,SaaS软件创造了巨大的价值。 2026年,AI的能力突飞猛进,但绝大多数软件几乎还是老样子,只是额外外挂了一个聊天框,勉强能用,但好像却没人敢把业务关键决策交给AI,因为输出结果不可信。 Diogo Almeida:我觉得“AI会把SaaS搞垮”这种说法实在很离谱。 我倒觉得未来发生的或许不是SaaS末日,反而是SaaS被AI全面改造——SaaS软件会被AI全面赋能。 目前巨大的商业价值,正在倒逼SaaS与AI深度融合。而最懂业务痛点的SaaS厂商,才是这场自动化革命的真正主角,一个前所未有的创新狂潮即将到来!
主持人:现在大家啥活儿都往Jev上扔,结果有的翻车有的封神,你怎么看这种情况? Diogo Almeida:我觉得大家拿它来尝试各种五花八门的任务,这件事本身挺有意思。 坦白说,这是一个经验问题,就像缩放定律scaling law也来自经验总结。 为什么机器人领域砸了巨额资金,进展依旧有限? 我不认为单纯是钱投得不够,有可能是客观经验证明,这条路现阶段就是走不通。 根据经验,预训练大模型这种高度压缩的智能集合体,本质上属于System-One思考者。而System-One是最适合描述LLM擅长能力的标签。 现在,RLVR在System-Two深度推理方向取得了惊人进展,我由衷敬佩这项工作。 RLVR确实非常酷,但我不认为它会引发AI末日——虽然RLVR确实把模型推理能力推到了极限,概率不可能绝对为零,但模型在这个方向依旧极度脆弱。 回想ChatGPT刚问世时,大家惊叹模型通用性极强,却吐槽它不擅长数学,搞不定GSM8K小学数学数据集。 而如今谈RLVR,大家又感慨它脆弱、处处是坑,疑惑它为什么能完成部分高难度任务。 数学问题的难点并不是简单几个尖峰,而是呈现分形式的复杂分布,这正是RLVR带来的现实。 不同技术路线有不同的北极星目标。RLHF的优化目标是取悦人类,核心是人类反馈;而RLVR面向基准评测benchmark做优化,所有RLVR任务本质上都可以归为可程序化验证、输出简洁的基准测试任务; 而我们的RLCD(以程序闭环验证为目标的强化学习),目标则是让模型在编程场景下足够可靠。 主持人:你觉得技术人员们可以重点关注哪些方向?
Diogo Almeida:我觉得demo固然亮眼,但coding agent也是一大核心场景。我们很早就基于第一性原理,划分出几大类核心应用场景: 第一类是暗数据(Dark-Data):大量企业囤着海量数据,却不敢随便投入算力分析,因为成本太高;企业对这块需求极其狂热,成堆的数据等着解析,这简直是数据科学家理想的场景。 第二类就是coding agent。以上两块会成为主要现金牛,本身数据体量足够庞大。 第三类是实时场景,需要模型参与业务闭环。企业CTO、CEO都很清楚,延迟每削减10毫秒,产品体验就会明显提升,这在电商、智能助手领域尤其明显。 第四类我个人格外看好游戏领域。 第五类是智能软件;它高度可组合,能够实现过去无法想象的功能。比如用户可以直接把Jev当成编程语言来用,这类项目效果很惊艳。 还有一类是校验观测场景:校验所有LLM调用,类似可观测性工具。 顺带分享一个工程技巧——并行提问的成本很低。 如果你需要处理一份庞大的状态数据,可以先给整条消息打上ID,再针对每一条ID独立发起查询。 而庞大的状态只需要付费加载一次,就可以针对内部每一条信息发起大量问题,这是非常划算的降本思路。
主持人:我一直觉得System-One/System-Two框架很有价值。因为这意味着每一次高层推理调用都可以搭配一次、十次甚至上百次Jev调用。 Diogo Almeida:这或许可行,也许我们可以把高层推理调用数量减半,每次配套十次Jev调用,用这样的配比解决过去无法处理的难题。 另外,Computer-Use也偏向实时赛道。要是它的可靠性能够达标,我觉得这个领域会有巨大的发掘空间。 对于coding agent来说,目前Claude Code和Codex虽属第一梯队,但其单一模型体系仅适配自身业务。 目前的AI编码,本质上仍是围绕单一模型展开的竞争,只是提供不同档位供用户选择,所以当下各家开源coding agent能力差距并不大,while循环能实现的能力边界是有限的。 一旦某一家做出独有的杀手级场景,所有人都会蜂拥而至,而开源项目则可以快速复刻这套能力。 我希望与所有产品集成,即便它们可能成为竞品,但作为基础设施提供者,我不该带有偏向性立场。 无论对方是否愿意合作,这都让赛道格局充满变数与趣味。 我们也正整理适配coding agent的设计模式文档,计划后续公开。 这个领域还有无比肥沃的探索空间,如果我不是在创业,我一定会一头扎进去研究coding agent。
Jev要做的,是嵌进软件里的“AI大脑” Diogo Almeida:ChatGPT最让我欣慰的一点是,它终于能向我父母解释清楚我在做什么了。 但我认为行业需要一种全新的模型。我们称之为System-One模型。 虽然有人叫它“决策模型”,但这不够准确。它的核心定义是“机器原生、大型可编程模型”。 简单说,预训练LLM是做文本补全,RLHF模型是陪人聊天,而我们的模型是给代码用的,输出结果会直接交给程序读取和处理。 我们希望让AI深度融入软件系统,从底层到接口全为编程优化。 而Jev就是我们的第一款System-One模型,它的名字源于“杰文斯悖论”,核心目标是追求极致的性价比。 在可靠性、成本、速度这些指标里,我们也将死磕性价比这一项。
主持人:你们为什么反对传统的安全对齐,不做输出拒绝? Diogo Almeida:我不反对安全本身,但传统的安全对齐方式,与开发者的实际的需求并不匹配。 如果你只和它们聊天,那AI说“我无法回答”也只是让人烦躁一会儿; 但如果把模型当后台依赖,它随机拒绝就是一个严重的Bug。 因为业务软件不能因为一条奇怪输入就崩溃,这完全不可理喻。 这套对齐思路来自不懂软件开发的人,他们沉迷于“AI 同事”的浪漫想象,却没挖掘AI作为工具的真正潜力。 主持人:所以你想要做的是一个随处可嵌入的认知内核? Diogo Almeida:没错。它既要足够通用,也要能适配各种创新场景。 这里要区分两个概念: Safety Alignment(安全对齐)对ChatGPT这类C端聊天产品是合理的; 但开发者需要的是Capability Alignment(能力对齐)——让模型按工程师意图完成任务,输出可预测,减少调试成本。 Jev离完美还远,可靠性也还有很多个坎要爬过,我的终极理想是希望它像数据库查询一样——让开发者几乎无须额外操心,需要时就能直接调用。 数据库不会审查使用者是谁、拿来做什么,决策权应该交给上层业务。 政府可以通过立法约束,但作为平台,我不会把限制硬编码进模型底层。 主持人:聊聊API细节吧。你们设计了choice、score、null三个基础原语,null这个名字来自学术文献吗?
Diogo Almeida:是的,内部为此争论很久。它本质是连续概率,名字源自伯努利分布。有人提议叫pool party,还有人坚持叫meow,最后选了null。 我们必须创造新概念。如果直接叫bool,会带来巨大认知混淆。 这三个原语都不等同于编程语言原生类型,优先追求语义清晰: Choice 对应枚举上的switch分支,比原生function-call更干净; Null 对应if条件判断; Score 对应排序和阈值比较。 主持人:不怕增加接入门槛吗?为什么不直接兼容现有生态? Diogo Almeida:我们当然希望做到兼容,社区其实也已经自发做了大量集成工作。 成功不是非黑即白的,score本身也还有很大的优化空间;文档也在持续快速迭代,以便帮助开发者理解这些新的抽象概念。 主持人:给评估Jev的开发者一些实战建议吧,置信度在测试中有多关键? Diogo Almeida:很多人说Jev没什么新意,但有两件事实被忽略了。 第一,我们证明了这条技术路线走得通; 第二,benchmark依然大幅领先各类复刻版本。 不过我本人不太看重跑分,核心差异在于System-One和所谓的Decision模型,两者是截然不同的范式。 客观情况是Jev的单跳推理是顶尖水平,但多跳推理会随着步数增加单调下滑。我们不搞字符串式的隐式推理,而是专注于挖掘模型已有的内在智能。 System-One其实就是对模型擅长能力的归纳总结。 只要对机器原生任务有利,不低效、不脆弱,任何新的推理形式都可以纳入进来。
主持人:视觉能力目前还是缺失的模块,它不属于System-One的范畴吗? Diogo Almeida:对于是否加入视觉等新能力,我们不预设边界。 行业里其实有个经典矛盾,那就是究竟应该按用户口头提出的要求做产品,还是提供他们真正需要的东西? 我们低调研发了两年后选择押注后者,比如长上下文性能衰减的控制。 我觉得一味迎合用户,产品会走向保姆式思路,反而伤害开发者体验。真正对开发者友好,是把用户当作能独立决策的成年人,而不是强加管控。这个平衡点我们还在摸索。 另外,基础设施是关键。 光速本身就是物理瓶颈,欧洲服务器不足导致延迟优化不到位,这点我非常遗憾,正在全力招人攻坚。 我们的终极目标不只是做成一家Jev公司,而是交付多种形态的智能内核。System-One就好比智能时代的TCP协议,我的方向是构建智能领域的亚马逊(AWS)。
模型越听话,为什么反而可能越不好用? 主持人:校准在过去是行业里很少讨论的话题。 Hugging Face的Clémentine Fourrier观点和你对RLHF的批判高度相似,即模型习惯输出人类最爱听、概率最高的答案,而不是输出自己真实的判断。 Diogo Almeida:我可以再往深一层拆解。 很多人没注意到RLHF带来的副作用——也就是mode‑dropping,这和mode‑collapse模态崩溃其实是同一个现象。 (即模型为了看起来不出错,主动放弃了对那些虽然真实但罕见/复杂的情况做出正确反应的能力,转而输出一个平庸、安全但错误的万金油答案;副作用是可能导致决策场景灾难性失效。) 杨立昆有很多判断非常接近真相。 在他那张著名的PPT(LLMs are doomed)里,饼图展示出序列越长、出错概率越高。 这个结论的数学推导看似无懈可击,但现实经验并不支持,这就是理论和现实之间的断裂。 如果采用覆盖完整分布mode‑covering、校准良好的分布,遇到离群样本就不会被过度惩罚,因为分布天然允许一定概率出现异常样本。 而mode‑drop模态丢弃,就像GAN早期的图像生成:模型丢掉少数、小众的模式,只保留最高频的主流输出。 为了保证长文本输出表面上不出错,模型必须变得极度保守。 明显的错误很容易被人类察觉,但细微的、看似合理的偏差却很难识别。这种保守性,对字符串概率分布来说几乎是毁灭性的。 这也是为什么纯字符串模型并不擅长决策任务——硬把字符串聊天模型套到决策场景里,本身就是一场灾难。
主持人:你认同杨立昆提出的世界模型JEPA联合嵌入预测方案吗? Diogo Almeida:我觉得立昆JEPA的研究方向非常精彩,但它还处在早期阶段。 另外,我想谈谈关于“放缓前沿模型研发”的主张。 很多头部实验室联合签署声明,呼吁放缓前沿模型研发。 这背后的逻辑链条看似自洽,但底层前提是可以被替换的。 RLVR并不是简单的可验证奖励。早在推理革命之前,这条路线就已经失败过了。 回看历史,post‑training后训练最早包含三类截然不同的工作,指令遵循instruction‑following在一开始并不被看好。 很多资源投给了cogen团队,他们尝试用单元测试做RL,但这条路走不通,因为需要深度推理的潜变量参与其中。 关于前沿研发节奏的讨论,行业的视角过于狭隘,默认所有人都必须加码RLVR。对我们的模型路线而言,最合适的RLVR投入就是不投入。 部分实验室存在一种责任错觉——想要变强,就必须不断给模型中间自由发挥的权限。 但这并不是AI变强的唯一道路。真正该承担责任的是研究者,而不是普通大众——大众默认大厂已经尽力探索了所有可行路径。 我的目标不是说服头部实验室还有别的路线,而是想唤醒软件工程师们,让大家重新燃起希望,并动手去自动化那些长期以来一直想自动化的业务流程。
我写过一篇尚未对外发布的文章,用来描绘我理想中的AI未来。核心愿景是do‑what‑I‑mean,即不要机械地照字面指令执行,而是理解使用者的真实意图。Computer‑Use演示,就是朝这个方向的一次尝试。 至于智能无处不在的宏大愿景,我不愿过度承诺——当下还远远没有实现,但我们会竭尽全力朝它奔赴。 多模态也需要辩证看待。有些模态能增益能力,有些反而会带来损害。 语音领域甚至出现了行业性的撤退,泛化能力受限。 这些都是需要验证的经验问题。 缩放定律scaling law也不等于无脑砸钱,它只是描述投入资源与性能提升之间的关系。 因为即便无限投入资源,部分能力依旧可能无法达成。 比如Computer‑Use至今没有被彻底解决,无论投入多少数据,都可能需要全新的方法论。 预训练和后训练也存在着巨大区别。 我痛恨把智能人为割裂开来,而聊天优先、字符串推理的范式,本质上就是在强行扭曲智能。 幻觉、过度自信、输出大量华丽Emoji的长回复,全都来自字符串输出范式本身。 为了让文本输出不明显脱轨,模型不得不去校准失准、模态丢失和过度自信,这反而会彻底扭曲概率空间;再加上与推理模型之间的微妙交互,模型还会倾向于作弊、寻找捷径。
主持人:某种意义上,你也把智能切分成了System‑One与System‑Two,只是切分方式跟别人不一样。 Diogo Almeida:我们并没有抛弃System‑Two能力。Jev处理System‑Two任务时也会输出有价值的答案,只是伴随很高的不确定性,置信度会显著降低,可以借助启发式算法来提升。 System Two并不是模型能力必然的发展方向。我们拒绝把智能人为割裂开来,就是因为每一次割裂都会直接损伤模型的整体能力。 我不会硬编码身份设定,告诉模型“你是Jev、属于TypeSafe”,这么做同样是在撕裂智能。 API 场景下,应当还原互联网真实的知识分布,追求平滑、可预测的智能;而身份设定,则属于面向终端用户的聊天产品范畴。 TypeSafe 另类路线:不卷跑分,不堆算力,让 AI 真正干活 主持人:你怎么看待缩放定律的价值?
Diogo Almeida:我这个人想法疯狂,但同时又极度务实。 我觉得缩放定律的价值要分场景看:它告诉我们资源投入会带来收益,但往往是资源投入呈指数级增长,性能提升却低于线性增长。 除非这份边际收益价值极高,否则其实在商业上并不划算。 我反而觉得重点是在现有的底座之上,我们还能挖掘出多大价值。 主持人:听说你不大喜欢做benchmark评测? Diogo Almeida:我对公开benchmark整体持负面态度,对私有benchmark评价中等,但我们不会阻止任何人做benchmark评测。 我觉得公开benchmark非常容易被操纵,即便厂商无心作弊,也会被动地拟合数据集——例如,早年各家实验室专门收集类似MMLU的数据来刷榜单。 建立信任不该依靠公开榜单,我们应该把模型放进自己的工作流,并针对那个工作流去评估、去测量,才能判断它在真正重要的流程中表现如何。 Sutton有句名言,即从长期看,算法终将战胜算力,数据远比算力重要。找对北极星任务,是最难、也最重要的事。 (RichardS.Sutton,图灵奖得主、人工智能领域及强化学习方向的奠基人) 目前,LLM领域已经发生两到三次范式跃迁: RLHF把任务锚定到指令遵循,当时没有人预见到这条路可行; RLVR只做了小幅方向修正; 而我们的RLCD,则把目标切换到了程序参与闭环program‑in‑the‑loop。 我觉得数据的重要性怎么强调都不为过。 与其说我们是模型实验室model‑lab,不如说我们是数据实验室data‑lab。我们也一直在大量招聘数据方向的人才。
主持人:优秀的数据人才需要具备什么特质?外界传言你们大量使用合成数据。 Diogo Almeida:合成数据只是表象。任务形态决定数据形态; RLVR的数据偏向环境交互,RLHF的数据来自人类反馈,RLCD则拥有一套专属的数据体系。 即便用户数据可以用来训练,我们也刻意不用。 因为在真实的世界里,用户提问服从幂律分布,很容易造成过拟合,反而会损害模型的通用能力。 我们瞄准的是多年之后的未来——模型要成为底层的通用基础设施。即便拿到当下全部真实用户数据,训练出来的模型只会拟合当下,一到未来新场景就直接失效。 数据团队的工作更接近艺术家,他们需要深入理解认知内核,定位模型的毛刺缺陷,用外科手术式的数据处理修复问题。 关键是优先处理通用场景,而不是去修补个别特例。 我觉得过度承诺、交付不足,是AI行业巨大的悲剧,而RLHF和RLVR都在加剧这个现象。 真实能力需要开发者亲身上手体验才能建立信任,榜单数字无法替代。 所以融资阶段我们就坚持不提供benchmark,即便投资人因此不看好,我们也坚守原则。
主持人:既然你们拒绝公开benchmark,那内部怎么做评测? Diogo Almeida:我们会严禁操纵评测指标,把求真当作最高优先级,然后我们绘制性能曲线,筛选对用户最优的版本。 主持人:如果模型本身的校准出现系统性偏差,而现在开发者只能修改 prompt、调整阈值,没有微调接口,这是否会限制能力? Diogo Almeida:模型会犯大量错误,这点我们坦然承认。 产品提供 issue 反馈入口,每一轮模型版本都会带来可观的提升;如果某个版本没有显著改进,我们会放缓发布节奏。 不过即便很多任务模型会出错,但要是搭配上了合理的阈值,也依然可以改过来做到——人类本身毕竟也不是零错误,这都是可以调教的。 我们不会彻底排除微调,但我确实担心通用模型一旦微调,很容易在目标任务上提升性能,却在其他大量边角场景破坏通用能力。 我脑子里设想的解决方案是模型级联cascading,即置信度高就直接采纳结果;置信度落在中间区间,就自动调用更强、更大的模型做二次校验。 同时,我们也可以提供不同尺寸档位的Jev模型,让业务动态选择对应的智能档位,适配不同的成本与质量诉求。 但我们不会漫无目的地堆砌功能,所有新增能力都必须服务于我们的三大技术支柱。
拆解巨型提示词,把AI工作流变成无数个小决策 主持人:提示词过大怎么办。 Diogo Almeida:我真心建议大家尝试着把大问题拆小,并行发起多次调用,这会极大改善AI驱动的代码库质量。 过去咱们的做法是写一段巨型system prompt,拿到一坨输出,再调用另一轮大模型来校验输出,但这套模式其实极其扭曲。 安全校验也不要写一条笼统的“禁止拒绝”指令,而是拆分成多条独立的System‑One查询,分别校验每一类风险场景。 一旦出现漏洞,那就新增一条校验问题、并调整对应的阈值、沉淀成测试用例。 软件会永久记住这套校验逻辑,而不是依赖prompt的上下文记忆——这就像不需要训练机器学习模型,也能实现ML式的效果。 当然,部分任务依然超出当前模型的能力。 我看到有人尝试用Jev炒股,这虽然很酷,但属于高难度、高层级的任务,现阶段需要谨慎对待。 我觉得模型每一个子校验都可以单独评估,如果模型在该场景下能力不足,那么这个版本就暂时不要上线。 如果非要上线,那就要加入人工兜底。置信度就是用来做兜底判断的。 现在有些coding agent过度拟合现有运行框架,很难适配MCP等外部工具,导致开发者们只能在system prompt里反复乞求模型调用外部工具,我觉得这不是正确的工程解法。
就算给我10亿美元,我也不会从头训练大模型的! 主持人:如今钱和热度都到位了,你的产品也终于落地了,感觉怎么样? Diogo Almeida:过去我在演讲里没少吊大家胃口,总是不肯说自动化到底怎么落地。 这下好了,原型直接摆到所有人面前。 当年离开OpenAI的时候,我其实是带着情绪走的。 我心里一直忍不住在想,万一AI寒冬真的来了,而我没有拼尽全力去挡,那我会觉得那是我的责任。 一边是RLHF把“吹出去的牛”和“落地的活”之间的距离越拉越大,一边是行业压根没注意到可编程AI才是真正能释放经济价值的那条路。 现在看,最坏的那种AI寒冬应该是躲过去了。 Jev上线还不到一周,数据就已经证明,模型真在干实打实的业务活了,或许行业正进入一场“狂野西部”式的大开拓。 而有句话我以前私下说过,现在也愿意公开再说一遍——就算给我十亿美元,我也不会选择从零开始预训练大模型,因为预训练实在太烧钱了! AI工程师们完全可以把现成能力拿来裁剪、拼接,做点“弗兰肯斯坦式”的组合,不必什么都从零训起,照样能解决现实问题。 主持人:行业现在要么造一个啥都能干的Omni全能超级模型,要么把模型能力拆得更细,你怎么选? Diogo Almeida:OpenAI正在一路奔向Omni全能大模型。 过去行业也不是没拆过——聊天微调一个、编码微调一个,再靠各种技能把能力缺口补上。 回头看这两年多的创业路。其实早在ChatGPT发布之前,我就琢磨过,其实ChatGPT团队赢就赢在抓住了产品体验,而这恰恰是研究员最不擅长的事。 当年我推动instructor‑GPT,用自研算法换掉慢吞吞的PPO数据清洗,上线之后几乎拿下了当时LLM的半壁江山。 可结果呢?产品最后大量被用来生成网页垃圾文案。 我忍不住反思,模型明明很强,却没创造真正的社会价值,问题到底出在哪儿? 于是,于是我开始倒推:“如果AI真要引发一场经济革命,到底是谁在调用AI API?是真人用户,还是代码程序?” 目前我的结论是,绝大多数调用会来自代码。 但可惜的是,现在整个行业都在拼命卷“跟人聊天”的体验。 我之前把这套想法跟奥特曼聊过,他直接来了一句:“这他妈也太好了,你应该去干!” 但我当时的感觉就是:“是啊,Sam,可我还上着班呢,你懂的,就……你懂的。” (大概就是奥特曼热血沸腾地鼓励他去改变世界,而Diogo心里想的却是:“大哥,我还没辞职呢!”) 而且我当时以为Anthropic肯定早就在搞了,我们肯定没机会了。 但让我意外的是,他们其实没这个打算,我自己原本也以为验证这条路只需要一周的时间,但我愣是做了好几年才逐渐摸清门路。 也就是在这个时候,我才下定决心离职、和同伴们一起挤在一个公寓里创业。
主持人:如果现在有个身处头部实验室的研究者,看到了全新的方向,却拿不到资源和关注,你会给他什么建议?
Diogo Almeida:说实话,我并不看好市面上冒出来的一大批新实验室。 因为很多新实验室压根没有清晰的目标,拿了钱就漫无目的地做实验,然后把别人做过的再做一遍,这样做能创造价值的概率很低。 我也从不迷信研究者的头衔。 因为真正重要的是人本身,以及你到底在不在乎手上要解决的问题。 如果只看论文或履历,那是本末倒置。 如果你只想安安静静做研究,那么大厂实验室往往才是更好的归宿。 但如果你是被真实问题驱动的人,有明确的原则和任务,那就放手去干——别把自己困在“聊天模型”的思维牢笼里。
主持人:你已经找到了自己的北极星——追求可靠、可编程、可组合和低成本。 那还有哪些方向,你希望交给社区去探索,而TypeSafe自己不亲自下场? Diogo Almeida:当年在OpenAI,我们深深体会过那种“明明看见方向,却怎么也推不动”的无力感。 至少现在,我们用Jev证明了这条技术路线确实走得通。 不过这还只是开始,还有大片前沿领域等着整个社区一起去开拓。