


Opus 5.5是首个RSI训练出的大模型?
Anthropic最新发布的Claude Opus 5.5,在性能大幅跃升的同时将运行成本压低40%,这一反常规的组合引发了业界对其训练方式的密切关注。
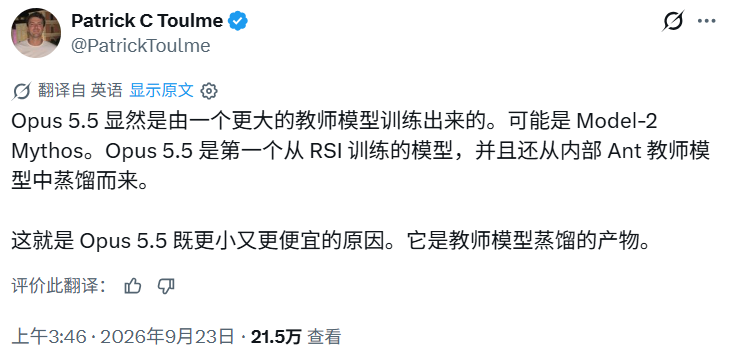
社交平台X上,谷歌工程师Patrick C Toulme据此提出一个推测:Opus 5.5可能经由Anthropic内部更强大的"教师模型"Model 2蒸馏而来,并可能是首个体现"递归自我改进"(RSI)路径的产品模型。
目前没有公开证据直接证实这一推断,但Anthropic已公开确认Model 2的存在,且该公司发布的RSI相关文章显示,AI参与AI研发的程度正在快速深化,这使得上述猜测具备一定背景。
对于投资者和行业观察者而言,这一事件真正值得关注的,是它将三条此前相对分散的趋势串联在了一起:更强的内部模型持续迭代、AI深度介入AI研发流程、以及更小更便宜的产品模型同步涌现。
如果这条路径成立,模型能力提升与推理成本下降将有可能同时发生。
Opus 5.5为什么值得关注?
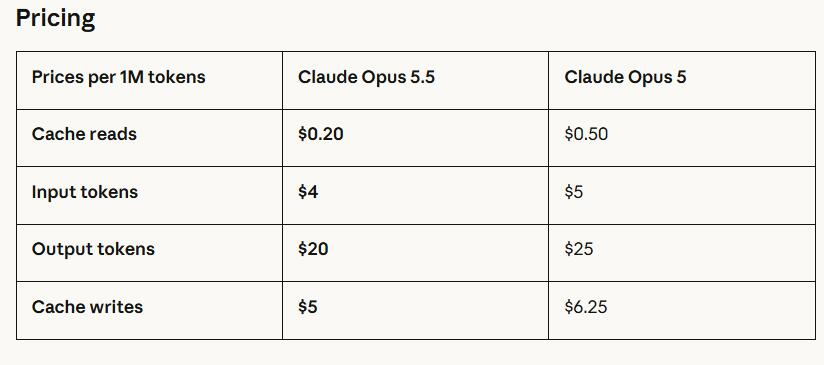
华尔街见闻提及,Anthropic将Claude Opus 5.5定位为其5.5系列的首款发布,性能在多数任务上与Claude Fable 5.1持平,但运行成本较Opus 5下降40%,输出速度提升逾30%。
定价层面的降幅尤为显著。输入和输出token价格分别为每百万4美元和20美元,较Opus 5下降20%;而在代理任务和编程场景中占主要成本的缓存读取,则从每百万0.50美元降至0.20美元,降幅达60%。
从实际使用表现来看,早期测试者完成了680,000行代码迁移,耗时不足一天,而此前类似工作需要工程团队数周;另一项测试中,Opus 5.5将一个Web应用全站页面加载时间优化成功率达到39/40,Opus 5在同等任务上则出现了改动应用行为的副作用。
在将HAProxy从C语言重写为Rust的内部测试中,Opus 5.5耗时9.5小时,较Fable 5.1的12小时缩短逾20%,成本节省51%。
Anthropic表示,效率优势还体现在token消耗层面——Opus 5.5不仅每个token价格更低,完成同等任务所需的token数量也更少,两者叠加共同形成了40%的综合成本降幅。
Patrick所说的“教师模型”到底是什么?
Patrick C Toulme在X上写道:
Opus 5.5显然是由一个更大的教师模型训练出来的,很可能是Model 2 Mythos。Opus 5.5是首个经过RSI训练、同时由内部教师模型蒸馏的模型。规模更小、成本更低,正是教师模型蒸馏的产物。
这里涉及的核心技术概念是"模型蒸馏":让能力更强的教师模型生成高质量训练信号,再用这些信号训练规模更小的学生模型,从而在保留较高能力的同时显著降低推理成本。
Anthropic已公开确认,其内部存在一个比Mythos 5更强大的Model 2,并被大量用于代码生成、数据生成及代理任务。然而,目前没有任何公开材料直接证明Opus 5.5是由Model 2蒸馏而来。Anthropic在发布文档中也未提及具体训练方式。
值得注意的是,Anthropic在安全条款中将"蒸馏攻击"单独列为一类威胁——即攻击者通过大量虚假账户从模型中批量提取能力,并为此在Opus 5.5上引入了"保留推理链"等反蒸馏机制。
这一细节从侧面说明,蒸馏技术本身在Anthropic的技术体系中具有相当重要的地位。
AI开始参与AI研发
无论Opus 5.5的具体训练路径如何,Anthropic自身发布的RSI相关文章提供了一幅更宏观的图景:AI介入AI研发的深度,正在以可量化的速度加快。
截至2026年5月,Anthropic代码库中逾80%的代码由Claude撰写,而在2025年2月Claude Code推出研究预览版之前,这一比例仅为个位数。
在工程产出层面,Anthropic工程师人均每日合并代码量较2024年增长约8倍。
Anthropic文章同时指出,2026年4月,Claude在约800小时内将某类API错误降低了1000倍,而据主导此项工作的工程师估计,人工完成同等任务需要约四年时间。
在研究判断力层面,Anthropic设计了一项内部测试:在研究员与Claude的协作会话中,找出人类研究员选择了"次优"方向的关键节点,再比较不同版本的Claude与人类在这些节点上的判断优劣。
结果显示,2025年11月的Opus 4.5模型在51%的情况下给出了比人类更优的下一步建议,而2026年4月的Mythos Preview这一比例升至64%。
不过,该文章也明确指出了当前的边界:
在选择哪些问题值得研究方面,Claude与人类之间仍存在较大差距。这正是今日AI与能够自主设计下一代AI的未来系统之间的距离所在。
Anthropic同时强调,完全意义上的递归自我改进目前尚未实现,也并非必然到来。
但分析认为,过去模型竞争很大程度上是“谁拥有更多算力”,现在开始出现另一条路径:让更强的模型帮助训练和改进更便宜的模型。如果这条路径成立,模型能力提升与推理成本下降可能同时发生。