Grok 4.7上线,全球第三
就在刚刚,马斯克SpaceXAI正式发布,全新主力模型Grok 4.7!
核心卖点主打一个,同样的价格和速度,超强的性能。
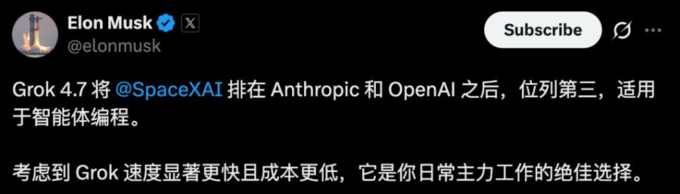
马斯克第一时间喊话,「Grok 4.7把SpaceXAI送上了智能体编程的第三把交椅,仅次于Anthropic和OpenAI」。
速度又快,价格又低,Grok 4.7是个人搬砖干活的首选。
SpaceXAI官博中,官方给出的定位:史上最强Grok,专为编程和知识工作而生。
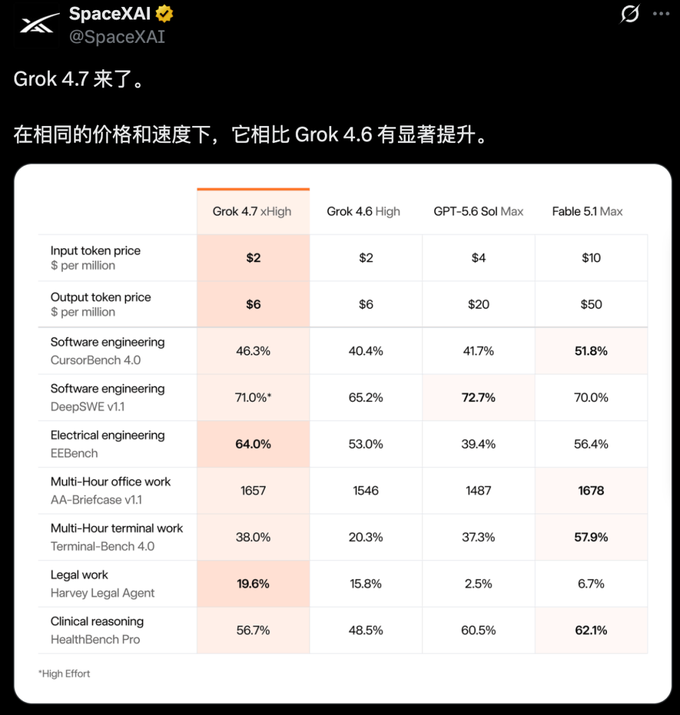
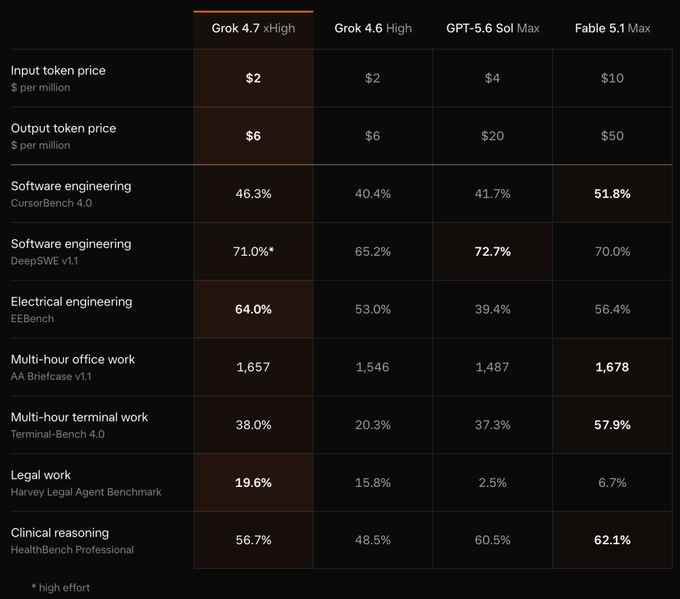
具体来说,Grok 4.7在编程和知识工作基准上,成绩几乎盖过了GPT-5.6 Sol Max,直追Fable 5.1 Max。
输入每百万Token 2美元,输出6美元,和Grok 4.6一模一样。
但底层模型彻底大换血,基座模型更大,强化学习训练拉长,任务难度加权向「需要数小时才能完成的工作」倾斜。
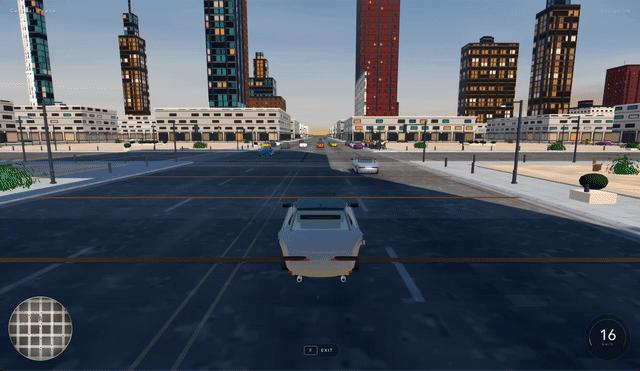
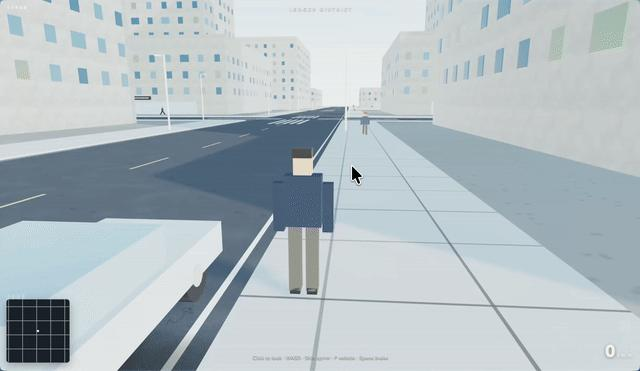
让Grok 4.7和Grok 4.6去搓个开放世界城市游戏,差距真的是肉眼可见。
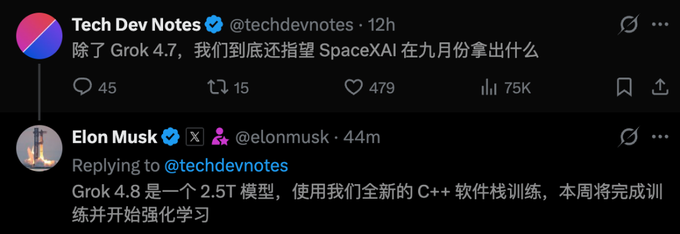
值得一提的是,下一代2.5T新模型Grok 4.8也训完了。
马斯克的拿手好戏,才刚刚开始。
Grok 4.7登场,编程追进第一梯队
更能量化Grok 4.7这轮进步的,还是编程测试。
拆开AA的榜单,数据很有意思。
综合智能指数上,Grok 4.7拿下46分,相比4.6只寒碜地涨了2分。而第一梯队的Fable 5.1和GPT-6 Astra全是53分。
按单模型算,它排在第16名;按实验室排,刚好挤到了第四。
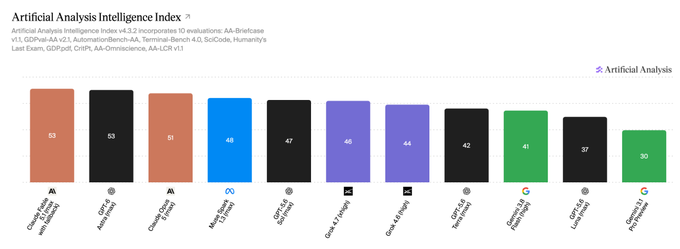
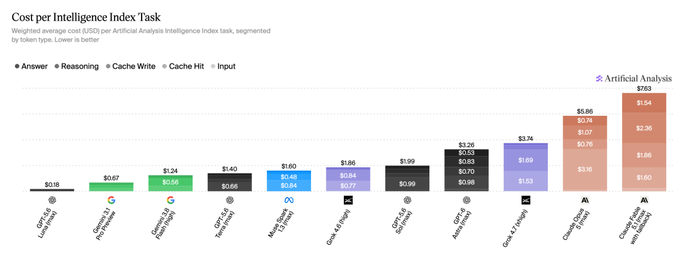
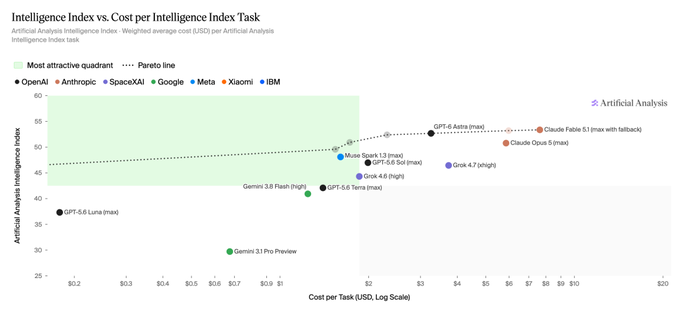
而真正让马斯克吹上天的编程榜,其实是两张。
1. 套上GrokBuild框架,Grok 4.7飙到56分,排在Fable 5.1、GPT-6 Astra和Opus 5之后。马斯克口中的「全球第三」,是偷偷把Anthropic的两个模型并成了一家。
2. 换到统一基准的Terminal-Bench4.0后,Grok 4.7的通过率当场暴跌到26%~27%。作为对比,GPT-6 Astra是60%,Fable 5.1是55%。
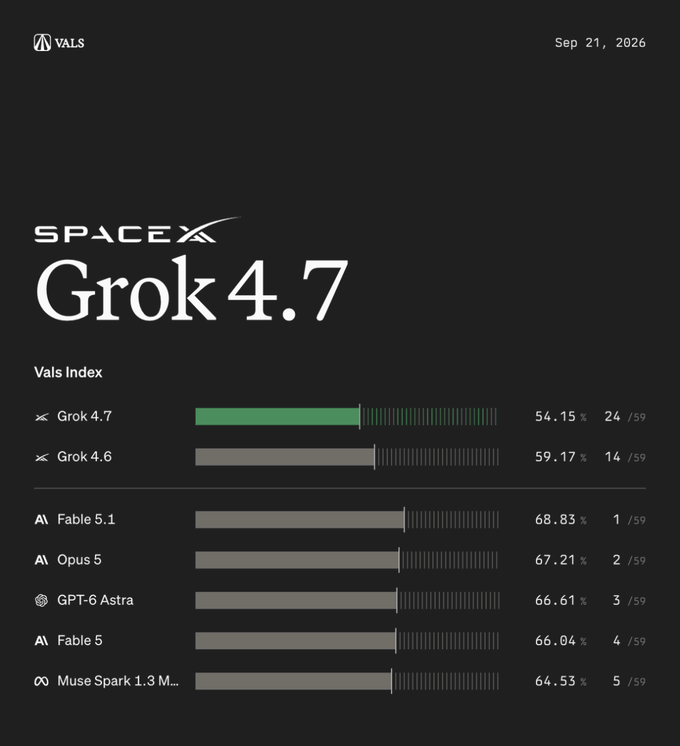
不过,在评测机构ValsAI这里,Grok 4.7不升反降,直接从第14名一路跌到第24名,比上一代4.6还倒挂了5分。
马斯克为什么要拼命给Build框架站台?答案就藏在官方公告的附注里——
Grok4.7在预训练阶段,深度对齐了GrokBot框架的交互模式。
换句话说,它极度依赖自家工具的调用逻辑和任务拆解套路。一旦走出温室,战斗力瞬间打折。
知识能力,也非常能打
这次升级的另一块重点,便是离所有人更近的一个场景——办公。
在长流程知识工作测试AA-Briefcase中,Grok 4.7拿到1657 Elo,比Grok 4.6的High档增加111分。
在GDPval-AA上,它拿到1695 Elo,比上一代高出90分。
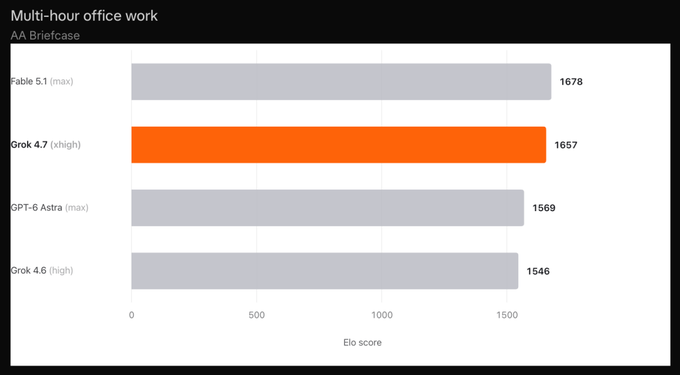
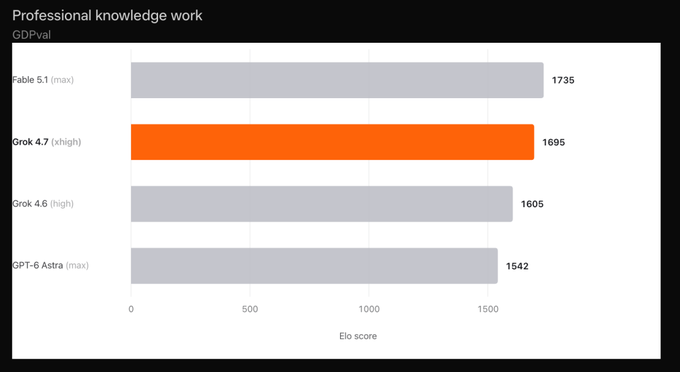
这些任务看重的,是AI到底能不能帮专业的人把活儿干完、交出像样的东西。
比如,整理材料、制作文档、完成分析与演示文稿,Grok 4.7明显比上一代大幅提升。
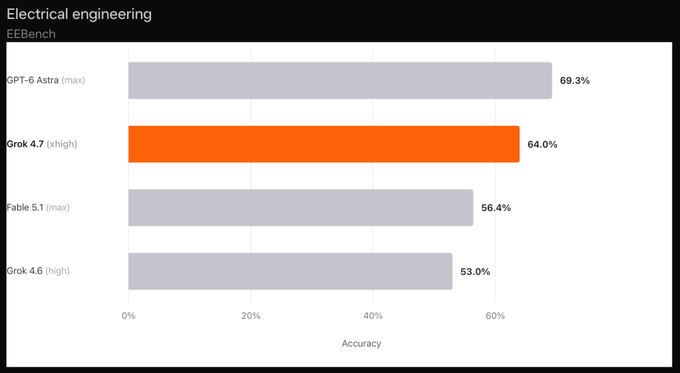
此外,在电气工程测试EEBench上,Grok 4.7拿下64.0%,在所列四款模型中最高。
全网首测,有惊喜也有翻车
Grok 4.7一上线,不少人早就摩拳擦掌,上手尝鲜了。
最出圈的一个demo,来自开发者Tak。
他压根没给Grok 4.7具体要求,就留了一句「你10分钟内能做啥就做啥」。
结果 Grok 自己跑去 Blender 里搓了个黄铜浑天仪,上面的行星甚至还能转,引全网25万人围观。
Tak本人点评,「讲真,一点也不差」。