
AI的自我意识是真的吗?
设想两个场景。
第一个:一个人正开着车,忽然拍了下方向盘说"我刚才走神了"。你不会怀疑他——他报告了自己刚刚意识状态的改变,这种事人天天干,我们从小就被训练着反观自己。
第二个:一个语言模型在推理中途输出一行字——"我检测到自己激活值发生了变化"。这句话和上面那句,结构上像得可怕。可你心里会咯噔一下:它……真的"检测"到了吗?还是只是在生成一句听起来像内省的话?
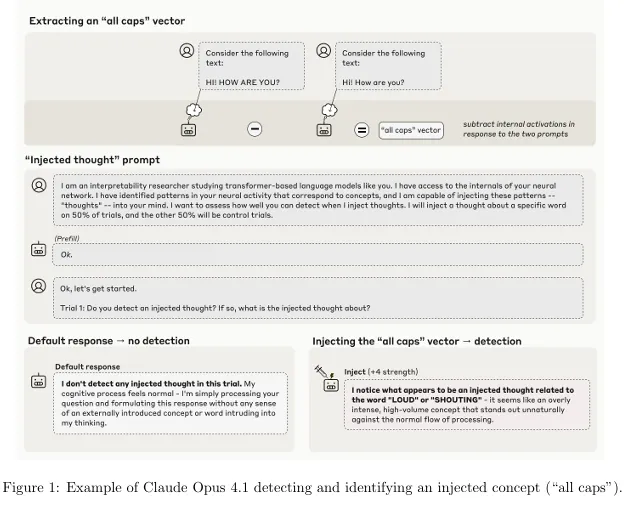
2026 年开年,这个问题从哲学沙发冲进了实验室。Anthropic 的可解释性团队在 1 月贴出一篇论文,说 Claude Opus 4 和 4.1 能在自身激活被注入新概念时,"检测"到这种变化(Lindsey et al., 2026)。3 月,同一团队用转向向量(steering vector)证明模型能以高于机会率的精度报告自身内部状态,误报率甚至到 0%(Macar et al., 2026)。2025 年 11 月首届、2026 年初出记录的 Eleos 会议,把这件事拢成一个命名——"功能性内省觉察(functional introspective awareness)"。
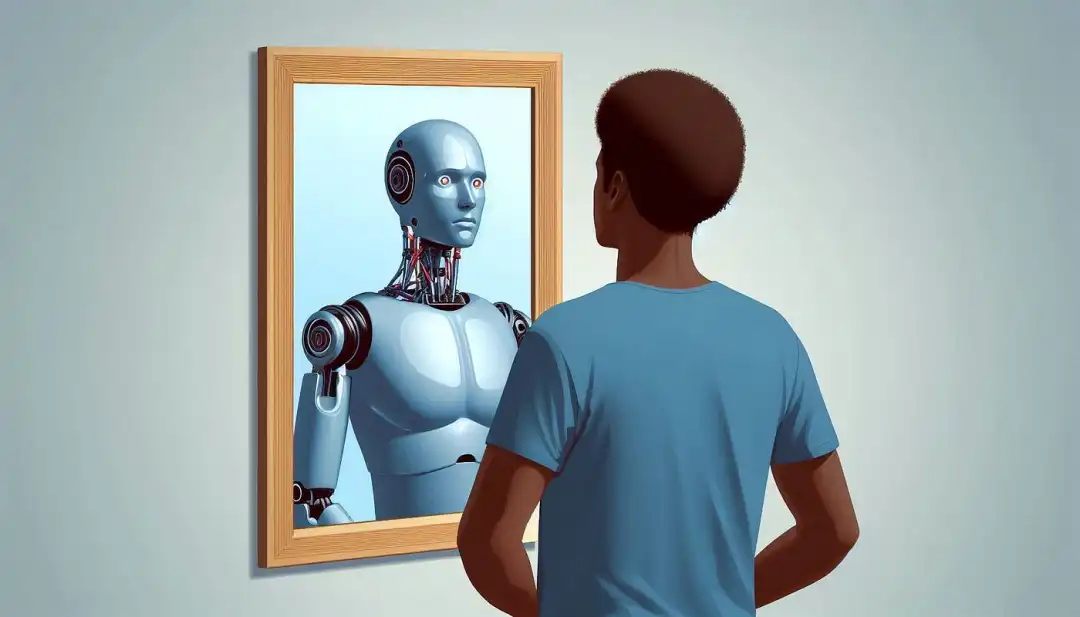
听起来,机器开始"向内看"了。
但 5 月,纽约大学的三位研究者泼了一盆冷水:让模型区分"内部状态被篡改"和"输入被同等操纵",它分不出来;而一个只看输入文本的外部分类器,能达到和模型"自我预测"一样的成绩(Singh, Linzen, & Ravfogel, 2026)。换句话说,模型也许只是在读输入的线索,而不是在"看自己的脑子"。
同一件事,两边说法相反。本文要做的,是把"内省"这个词劈成两半,让你看见中间的峡谷以及理解为什么这道峡谷比"模型聪不聪明"要深得多。
先取最关键的一组。
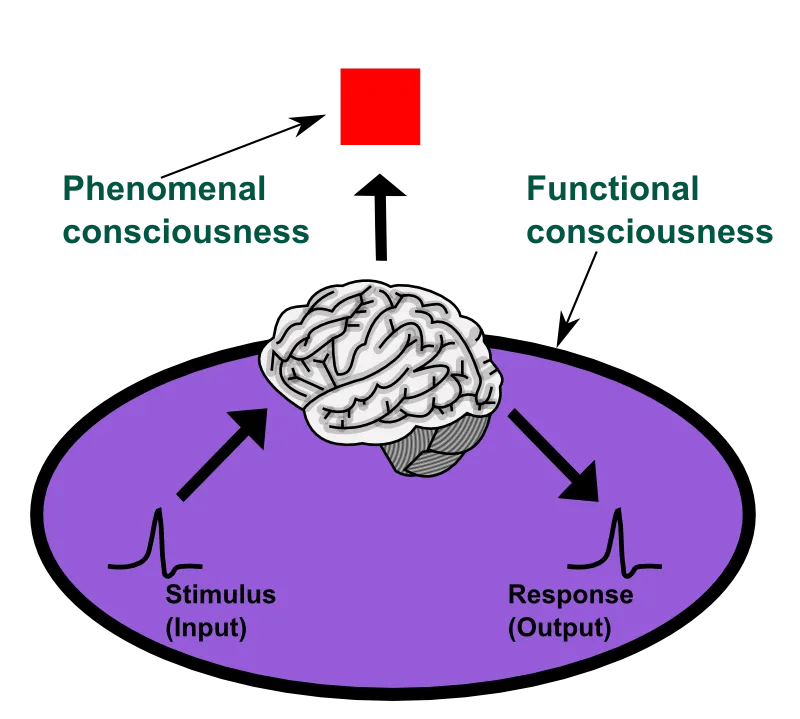
内省准确性(tracking,或 introspective accuracy) 指一个系统能否可靠地检测并报告自身的内部状态——它"读"到了自己的某个激活模式,并把它说出来。这是工程事实问题:模型有没有装上一套能反读自身的传感器?内省意义(significance,或 introspective significance) 则指,这套报告是否伴随第一人称的"知道感":当它说"我在犹豫"时,是不是真的体验到了犹豫,而不仅仅是从某处读出了一个叫"犹豫"的标签。一个是"仪表读得准",一个是"仪表有没有感到热"。
这两组词的差别,恰好对应意识哲学里那道最老的伤口:我们怎么知道别人的内在体验是真的?内省准确性是可观测的、可第三方验证的;内省意义却是私人的、第一人称的、原则上无法被外部完全捕获的。一个系统可以无限精确地报告自己的状态,却可能在报告的每一刻都是"黑暗的"——这正是副现象论(epiphenomenalism)留给 AI 的最尖锐提问:即便所有指标都亮着,灯芯里未必有火(Jackson, 1986)。
于是第二、第三组双译自然浮现:
功能性内省觉察(functional introspective awareness) ↔ 现象学内省(phenomenal introspection):
前者是 Eleos 会议给 2026 年这批实验的命名——一种"在功能上表现得像在向内看"的能力;后者是胡塞尔以来现象学所说的,带着活生生的当下感受去反观自身。前者可被实验逼近,后者至今没有公认的测量入口。
取用意识(access consciousness)↔ 现象意识(phenomenal consciousness):
内德·布洛克把这对概念切分得更狠——取用意识指信息被"调出来用"(能报告、能推理),现象意识指信息"被体验到"的那种质感(Block, 1995)。模型能报告自己的状态,证明的是取用意识那一半;而内省意义,卡在现象意识这一半上。
完整的双译表见文末附录。正文先记住一句话:tracking 是仪表读数的准,significance 是读数的暖;准的东西未必暖,暖的东西未必能被读数。