

当硅谷开始说“打不过国内”
公司、技术、壁垒,甚至一个人最相信的能力,都在被重新定价。
8 月的一个下午,我从旧金山机场出来,上 101 高速往南开。
湾区的夏天几乎没有云,阳光把路面晒得发白。机场附近还是仓库和低矮的办公楼,再往南,风景慢慢被广告牌接管。
这条路的广告牌,一直是硅谷最诚实的风向标。两年前挤满 SaaS,去年还能看到一点消费品牌,今年清一色全是 AI 公司。
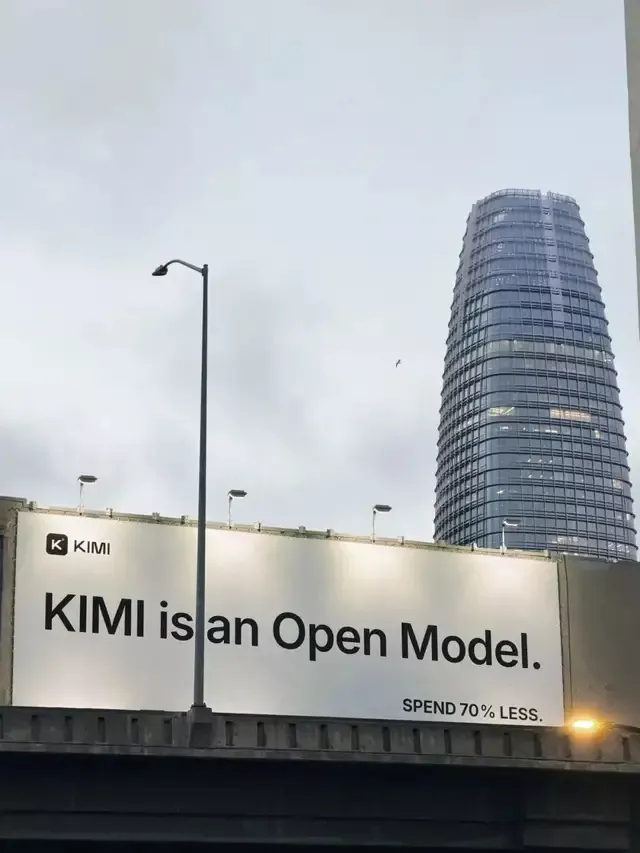
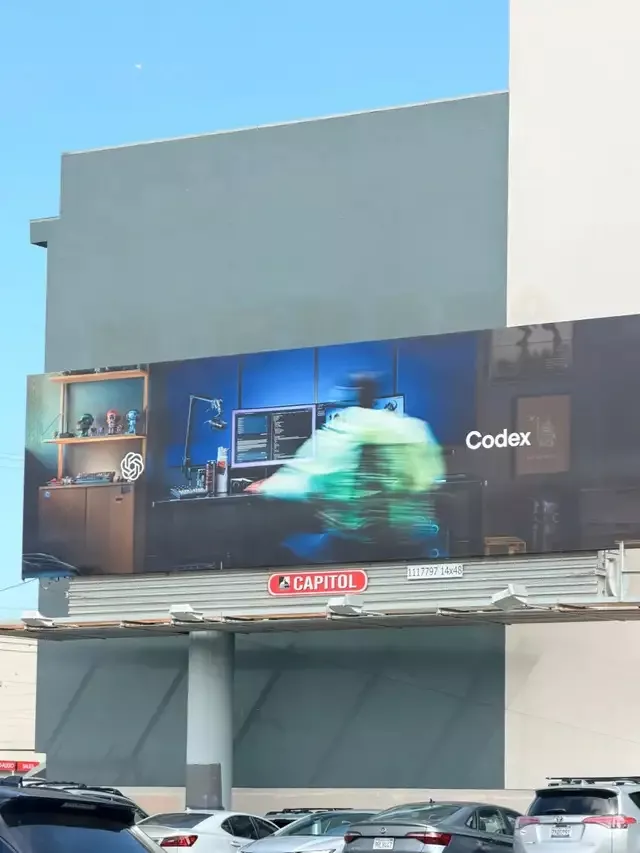
图一:Kimi 也加入了旧金山 “AI 广告牌” 大战;图二:Codex 的广告牌在旧金山越来越多,花了血本与 ClaudeCode 竞争
没有任何迹象表明 AI慢下来了,钱、卡、人还在往这里涌。真正超出我预料的是,一些过去很难听到的判断,开始出现在最核心的人群里。
几位 OpenAI 的朋友,花了很长时间复盘过去一年押错的方向,也认真拆解中国模型公司到底强在哪;Google 的researcher 聊到多模态,很直接地说:“打不过国内。” 这当然不能概括今天中美 AI的整体位置,但几年前,很难想象这样的判断会从硅谷一线的 researcher 嘴里说出来。
大家开始重新估计中美之间的差距到底有多大,不过这个问题也已经没有一个统一判断:在预训练、后训练和多模态上,答案可能完全不同。
另一种变化,发生在过去两年最贵的那批 Neo lab 身上。
Thinking Machines Lab 的 researcher 告诉我,他们今天经历的痛苦,其他 Neo lab迟早还会再经历一遍。而我越来越怀疑,下一家真正跑出来的 Neo lab,不会长成今天这个样子。
这可能是我这次在硅谷最强烈的感受:过去两年形成的很多边界和共识,并没有想象中那么牢固:
最顶尖的 researcher 聚在一起,是不是就能再造一家 OpenAI?美国最好的Lab,是不是在每一个战场上都能领先?模型、数据、应用和算力,到底谁是谁的上游?最强的模型,是不是就应该一直卖最贵的价格?……
甚至连最漂亮的增长故事,也被重新计算:8 月,彭博报道 Anthropic 的 ARR 达到了 650 亿美元,比两个月前又涨了180 亿。放在任何一家公司身上,这都是惊人的增长。但它仍然低于市场此前的期待,一些投资者原本预期,这个数字会达到 700多亿美元。
五个月前我写 “全员 token-maxxing”,那时候硅谷最强烈的情绪是怕跟不上,更多token、更多卡、更大的模型、更快的迭代,速度本身就是答案。
但五个月后,越来越多人开始回头问:过去两年我们最相信的那些东西,到底还有多少成立?
“打不过国内”
这次在硅谷出差,我反复听到一句以前很少听到的话:
“打不过国内。”
说这句话的人都挺核心。有 Google 做多模态的 researcher,也有 xAI 和其他 frontier lab的人,还有的是在研究美国的开源模型。这句话在不同的人、不同的场景里反复出现,听得多了,很难再把它当成随口抱怨。
这里的 “打不过国内”,指向的是一个个具体方向,不同训练阶段、不同模态、不同任务,答案可能完全相反。
做多模态的人,说的是 Seedance;做开源模型的人,盯着的是 K3;有人看到的是数据和operation。同时美国自己的几个开源模型和 Neo lab,进展又明显没有达到预期。
还有在多模态,一个让我意外的是,一直是多模态最坚定的投入者 Google,最王牌的团队也被砍了算力,无论是做图片编辑的 NanoBanana,还是做视频的 Veo(现在的 Omni),虽然在美国都已是绝对的第一梯队,但现在几乎人人都在转方向。当 Google 的researcher 朋友说 “打不过国内” 时,这个背景也很重要。
过去那种拿一张榜单、一条 scaling curve,就给中美模型排出一个总名次的方式,早就失效了。
听得多了,我越来越想弄清楚:到底哪些地方真的追上来了,哪些地方差距还很大,以及为什么会出现这种分化。
先从 pre-train 说起。
过去一年,中国模型公司补得最快的一课,是怎么 “爬 ladder”。
一个几百亿、几千亿参数的模型,很少直接从头跑到尾。团队会先在更小的模型上验证数据、架构和训练方法,再一级级往上scale。梯子搭得够不够完整,决定了一个小实验里的误差,最后会不会在大模型上变成一次几千万美元的失败。
几位 frontier lab 做预训练的朋友告诉我,今年国内头部 Lab 的 scaling ladder已经明显完善,训练方法越来越科学。
所以 pre-train今天是一个有点反直觉的状态:看起来,中国和美国的差距仍然很大,但其实在方法论上已经很接近了,剩下的主要是卡和相应的系统工程经验。
最前沿的 pre-train 依然需要巨量算力,美国 Lab 跑过更多超大规模训练,有更多卡、更成熟的集群,也更知道几万张GPU 跑起来以后,可能会出现什么问题,中国缺的还是这种 “把同一套方法稳定 scale 上去” 的经验。
换句话说,pre-train 的路大家都已经知道该怎么走,只是美国走得更远、跑得更多。
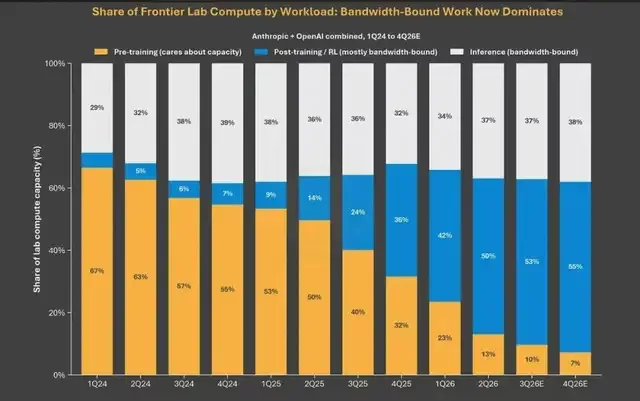
Frontier Lab 的算力重心正在快速转移,Pre-train 的占比持续下降,post-training/RL快速上升。过去拼的是把模型 “训出来”,接下来越来越多算力花在让模型 “变得更好” 和真正跑起来
到了 post-train,就不能这么给答案了,因为事情开始分化。
Post-train 不是一套统一的方法,需要的能力很多:怎么定义问题,怎么设计 environment、reward 和eval,怎么把训练稳定地跑起来,都很重要。但如果看中美之间最容易拉开差距的地方,有三项尤其明显:大规模 RL、humanoperation,以及蒸馏。
中国在这三件事上的位置,并不一样。
最难补的,其实是第一种:大规模 RL。
今天前沿的 post-train,一次 RL 的 Big Run可能要同时占用上万张卡,一个任务要连续跑上千步,中间任何一个环节不稳定,整条 trajectory 都可能报废。你还得知道什么environment 值得搭,什么 reward 真正有效,rubric怎么定义,规模从一百步涨到一千步以后,原来的经验还成不成立。
这些东西很难靠看论文学会,它更像一种只有真正跑过很多次大规模实验,才会留下来的 “肌肉记忆”。
中国过去没有那么多卡,也没有跑过足够多这种规模的 RL,所以这一块的差距,反而比 pre-train 的方法论差距更深。
但 post-train 还有另外一半。
一旦模型要优化的目标已经被定义清楚,接下来需要大量人把数据、标注、评测和反馈一层层铺出来,这就是中国公司非常擅长的地方。
Seedance 是一个很好的例子。字节自己拥有最终的视频分发平台,它比单纯的模型公司更容易知道:一个视频模型到底什么叫“好”?什么样的运镜用户喜欢,什么样的人物一致性不可接受,哪一种生成结果真的有人愿意发出去……这些东西很难靠一个 benchmark去提前定义,分发平台本身就在不停帮它定义 benchmark。
一旦目标清楚,后面的事情就开始变得很 “中国”:快速组织大量的人,把数据、标注、评测和训练一轮一轮往上推。
这里面当然有算法的因素,但越来越多的差距,藏在算法之外。
这也是为什么,在多模态领域,特别容易把中国公司的优势放大。它不像 Coding,很多时候没有一个干净的 “对” 或“错”,大量判断仍然要人来做,目标越模糊,human operation 的价值越高。
OpenAI 和 Google 的朋友,把这种差距概括成了operation(运营)能力:在一些训练目标没有那么标准化的领域,中国公司的优势反而会被放大:一旦方向明确,就可以迅速组织大量人力,来搞定大量数据、标注、评测和后训练的繁杂工作。
美国公司其实也在补这一课。
Meta 最近组建了一个大约 6500 人的内部团队,叫 Applied AI,大量 Meta员工被调去出题、造场景、做评测。有人甚至不是主动申请,而是直接收到调岗通知。