
AI碾碎了书,就像碾碎你的脑子
Anthropic 的巴拿马项目曝光之后,社交媒体上最让人不舒服的一张照片,是一摞被切掉书脊的书。
那些书曾经是完整的。封面、扉页、版权页、目录、正文、后记——所有构成一本书的部件,都还在。但图片中的它们已经不再是书了。书脊被液压切刀一刀切断,散开的书页被送入高速工业扫描仪,逐页过机,图像被提取,文字被 OCR,数据被喂进模型。剩下的纸页被送去回收,打成纸浆,重新变成纸——可能是下一本书的原料,也可能是一张快递单,或者一卷卫生纸。
那句话怎么说来着?书籍死了,书籍万岁。
碎书不是新鲜事
二十年前,科幻大师弗诺·文奇正好预言过这件事。
2006 年的《彩虹尽头》,小说设定在 2025 年——也就是去年。书里有一个诡异的场景:一家公司要数字化一座图书馆的藏书,用的不是翻页扫描仪,而是一台工业碎纸机。书被切碎成细小的碎片,风扇把碎片吹进一个布满高速摄像头的箱子,每一片碎纸都被拍照,然后算法根据碎片边缘的纹理和形状,把文本重新拼接出来。
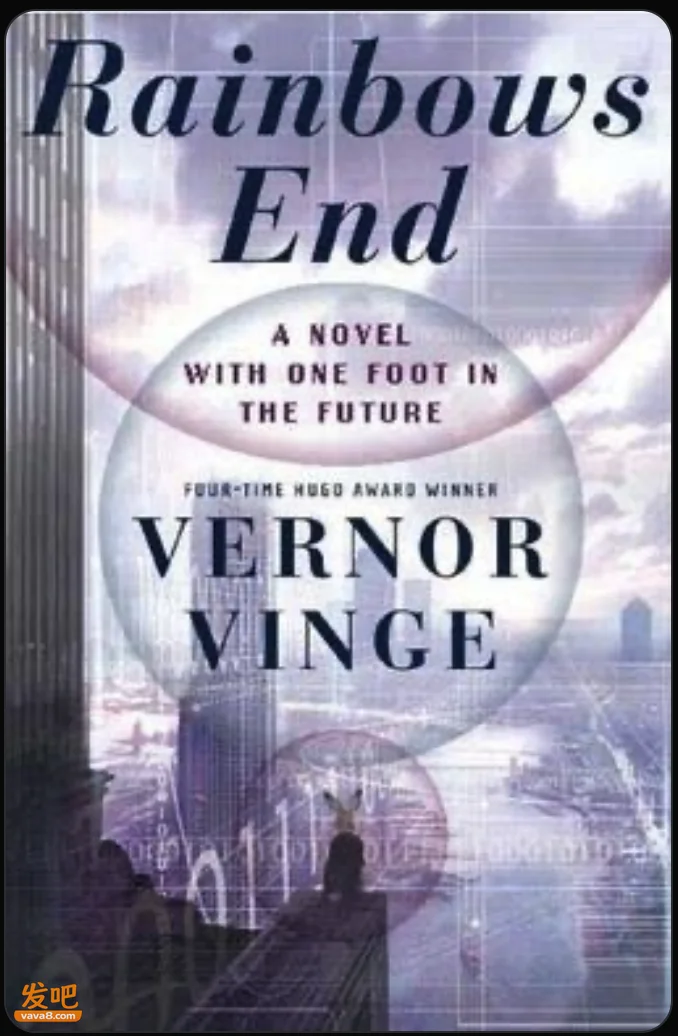
这个方法的灵感来自 DNA 测序的霰弹枪法——把基因组打成碎片,分别测序,再用算法拼回去。用在书上,高效、粗暴、不留余地。小说里,这件事引发了民众抗议,最终被温和的翻页扫描取代。但文奇写下这段的时候,大概没想到二十年后,现实会跳过温和的翻页扫描,直接采用碎纸机方案——只不过把碎片拼接的步骤省了,因为 AI 不需要一本书的完整顺序也能从中学习。
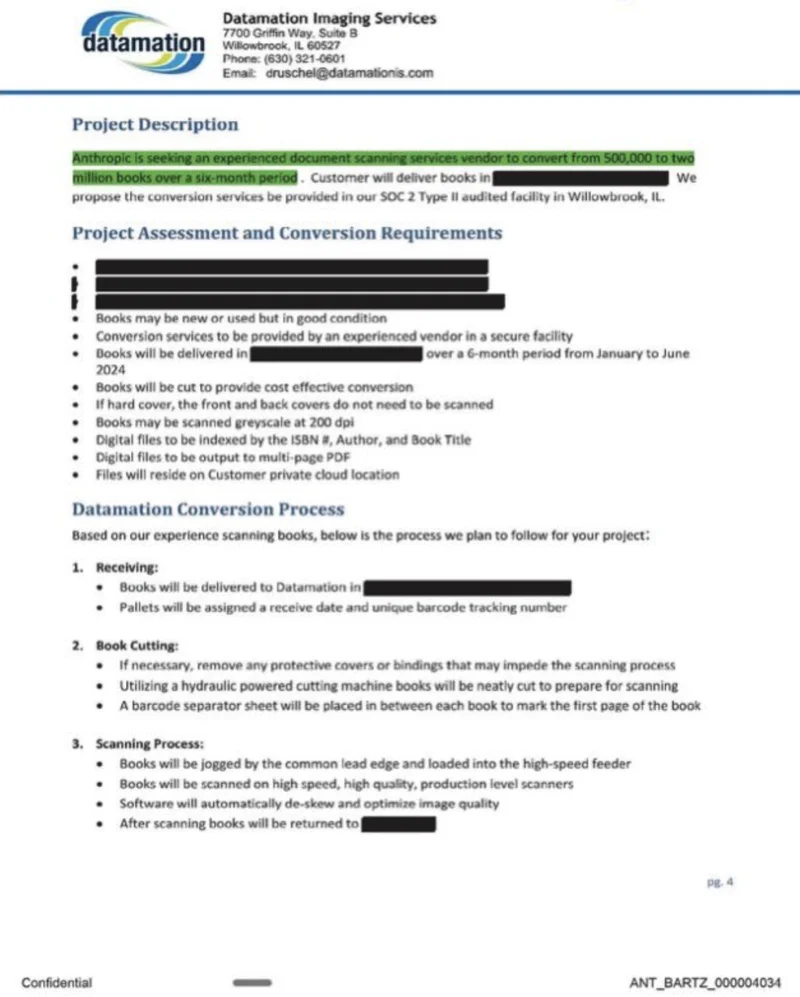
Anthropic 的巴拿马项目,从 2024 年初启动,一年内花费数千万美元购买了数百万本纸质书,切脊扫描后全部销毁。Claude 这么操作是为了钻一个版权法的空子:扫描成电子版是“复制”,那么这就是非法的盗版;但是扫描之后销毁原书,理论上整个世界就没有多一本原书的拷贝,那么这就不违反版权法。
与此同时,Anthropic 还下载了大量的盗版电子书用于训练。法院后来批准了 15 亿美元的和解协议,实际上是针对下载盗版电子书的行为;而购买纸质书扫描之后销毁的行为则没有受到处罚。
法官在裁决中说,用正版书训练 AI 属于合理使用,就像人类阅读一样。这个类比暴露了一个根本的盲区。
阅读的两种死法
人类阅读是线性的、沉浸的、允许怀疑和回退的认知行为。你翻开一本书的第一页,跟着作者的思路往前走,读到第三十页发现前面有个概念没懂,翻回去重新看,再继续前进。这是一个有方向、有节奏、有主体的过程。
AI 训练是并行的、统计的、不可逆的提取。数百万本书同时被切开、扫描、向量化,内容被打散成 token,权重被更新。模型没有读过任何一本书,它只是从书的碎片里提取了统计规律。
法官说 AI 像人类阅读时,他描述的是一种正在消失的行为。大多数人的注意力已经被短视频和信息流重新布线。今天你拿起一本书,翻开第一页,你可能还能读下去。到第五页,一种微妙的焦躁会开始升起,你的手指会不自觉地做出滑动的动作,眼睛开始下意识地寻找加粗的小标题或者分段标记。到第十页,你的大脑已经在自动生成一个问题:这本书的核心论点是什么?能不能用三句话总结?有没有更短的版本?这不是你不想读,而是你的神经系统已经被训练成另一种模式。注意力没有被涣散,而是被重新分配了——从深度阅读所需的持续聚焦,转向碎片化信息抓取所需的快速切换。当知识以 token 的形式存在,当答案以对话气泡的形式弹出,当复杂论证被压缩成要点列表,大脑就不再为连续注意付费。维持深度阅读的神经回路,和任何后天技能一样,会因为没有练习而萎缩。
《彩虹尽头》里同样预言了这件事。在文奇笔下的 2025 年,新时代的儿童已经不再读书,对信息的获取完全依赖视频。他们甚至都不会写字和说话,所有的表达都是依赖于互联网上无以计数的视频的切片,跟《变形金刚》里的大黄蜂一模一样,跟现在一模一样。文奇写这本书的时候,YouTube 刚成立一年,iPhone 还没发布。
文奇作为 AI 时代的指定预言家,还构思过一个完全相反的技术:聚能。