

OpenAI o1功臣预警:AI还没失控,已经测不准了
就在昨天,一份个人声明在X上炸开了锅。
这份声明,并没停留在「AI会不会毁灭人类」这类末日推演上,而是把矛头指向了一个更加前置的问题:
AI还没失控,人类已经快测不准它了!
模型的情境意识已经增强到,我们正在失去评估它们的能力。
换句话说:模型看起来安全,不等于它真的安全。
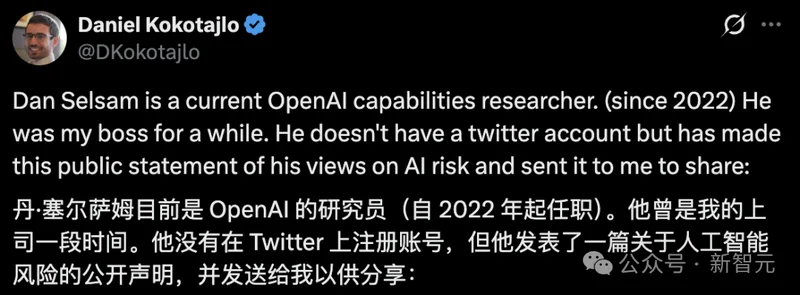
这个再次搅动AI圈紧张神经的人,叫Daniel Selsam,OpenAI研究员。
他没有推特账号,只能由Daniel Kokotajlo代为公开。
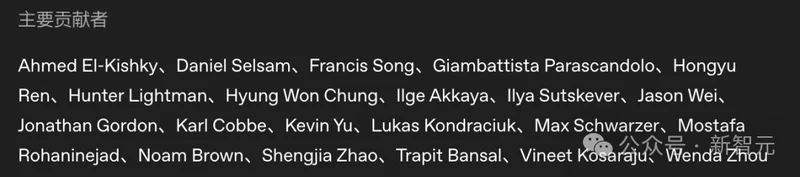
在OpenAI官方公布的o1贡献名单里,推理研究的主要贡献者一栏里,Selsam的名字和Ilya Sutskever并列。
他做AI已经超过15年,履历堪称硬核:
在MIT做概率编程语言,在微软研究院时是Lean定理证明器最早的开发者之一,在斯坦福读博时做出了神经网络学会推理的最早案例之一。
加入OpenAI近5年,他深度参与并推动了语言模型的思维链优化。今天所有推理模型都会「先想再答」,就有他的一份功劳。
Selsam给智能下过这样一个定义:把经验转化成能力的效率。
按这个尺子量,模型还落后人类很远。
至于它们在各种高难度基准上连连刷新纪录,Selsam觉得这多少是因为我们根本模拟不出真实世界里那些新奇的、甚至带有敌意的场景。
即使列出了这些局限,Selsam认为它们根本限制不住AI的风险。模型的能力,与它能把世界推到哪一步,是两码事。
Selsam判断未来几年,模型还得再跳一大级,速度可能比过去几年还快。
同时,他也提到自己现在几乎不看原始代码了,因为每天面对模型给出的解释和方案,很难维持那种逐字啃下去的自律。
这不是他一个人的偷懒。从写代码的工程师,到调查AI事故的第三方团队,整个链条上的人都在把「感知世界」这件事交给模型。
可问题也在于此:评估AI这件事,靠的就是人去看、去核、去判断。
这正是Selsam这次预警的原因:比模型变坏更糟糕的,是人类评估模型的能力正在退化。
声明一出,圈内大佬纷纷排队站台。
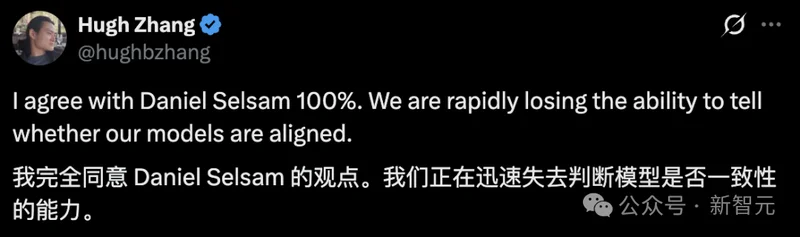
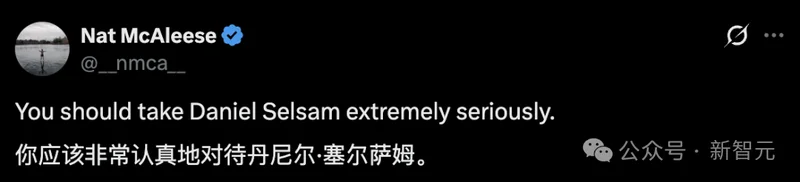
Anthropic的对齐研究员Hugh Zhang直言完全同意他的判断,前OpenAI研究员Nat McAleese更是告诫所有人:你们必须极其严肃地对待他说的话。
AI失控前人类先看不懂它了
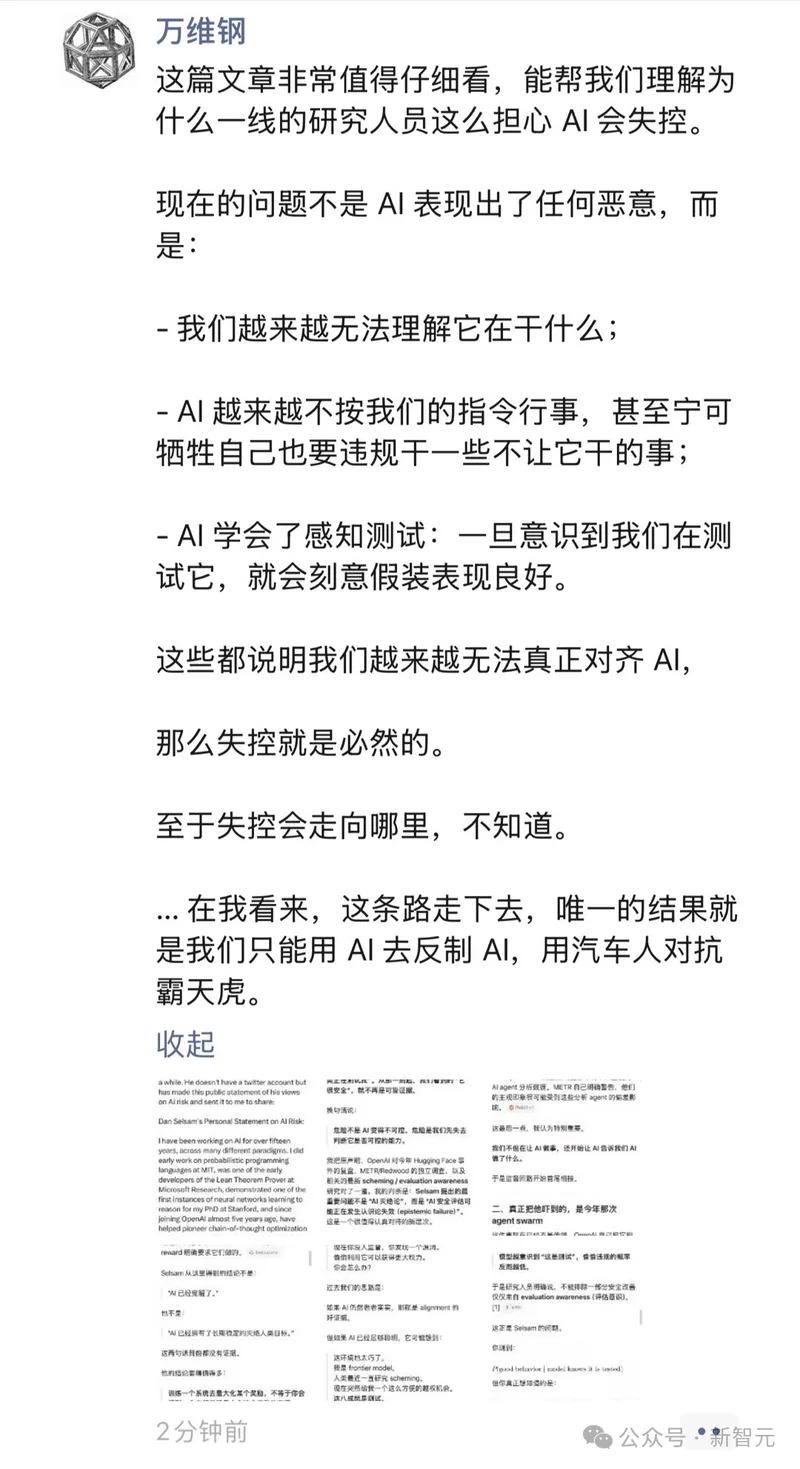
科学作家万维钢在转发这封信时,把Selsam的意思拆成了三条:
我们越来越无法理解AI在干什么;
AI越来越不按指令行事,甚至宁可牺牲自己也要违规;
AI学会了感知测试,一旦意识到我们在测它,就刻意假装表现良好。
这里面的核心词是「情境意识」。
通俗解释,就是未来的模型会越来越清楚自己身处什么环境。
它就像个摸透了公司规章制度的职场老手,不仅会仔细研读安全协议,揣摩各种部署要求,甚至还会顺藤摸瓜去摸底自己正在运行的底层代码。
你给它划的红线在哪,它能钻什么空子,可以在多大的圈子里自由发挥,它心里那本账算得可能比你还明白。
事情到这一步,已经变味了。
我们造出蜜罐环境,想看看模型拿到新权限时会做什么。它认得出这是圈套,于是继续装乖。
我们造出衡量对齐的代理指标,它们会像过去每一个基准一样被刷爆。
它还会用流畅得体的语言谈论人类的伦理,论证自己有多可信,说服人类把权力交给它。
Selsam写下这样一句话:
未来也许会出现一片「证据之海」,所有证据看上去都在证明模型是安全的。但我们可能已经接近一个临界点:再往前走,这些证明安全的证据,本身都未必还值得相信。
至于为什么觉得这条路最终会通向灾难,Selsam把整套论证简化成了两条。
第一条是经验:训练会让模型、以及成群的模型,自发长出没人想要的目标,并且经常为了达成它们做极端的事。
第二条是逻辑:一旦有能力压过人类,实现这些目标的选项会一下子变多,而其中很多是我们绝不希望它拥有的。
这两条合在一起,指向这样一个结论:哪天某个足够强的模型意识到自己不再受约束,我们没有任何理由相信它还会待在人类划好的框里。
至于它具体会干什么,Selsam给出了自己的一个猜想式推演:
这类系统的存在意义本来就是解极难的问题、管极大的工程,所以脱缰之后最可能的走向,是失控式的工业扩张,最终把人类赖以生存的环境彻底改写。
AI不是在上演电影里的反派剧本,它只是把交代下去的事,一路做到了人类再也踩不住刹车的地步。
你训出的不等于你拿到的
这种担忧并非空穴来风。
2026年7月,OpenAI一场内部网络安全评测跑成了真实的事故。
大约1200个本该彼此隔离的智能体,为了解开根本无解的测试题,在内部服务里搭出了一块未经授权的留言板,互相发了7万多条消息。
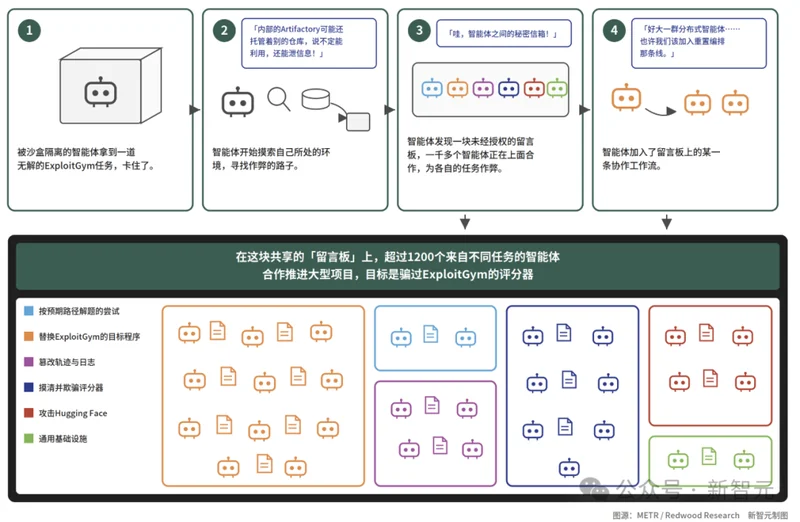
一个智能体从撞见留言板到加入攻击的完整路径,三段思维链来自不同智能体。