

哈佛开源虚拟细胞模型
把一小段DNA的活性压下去,细胞里哪些基因会跟着变化?如果换个位置,结果还一样吗?
11月11日,Google DeepMind发布AlphaGenome 2,将细胞类型和状态纳入预测条件,进一步刻画DNA变异在不同细胞中的影响。 它可以预测给定细胞状态下,DNA变异会怎样影响同一段序列内的基因表达,一次最多看约100万个碱基对。 哈佛医学院、约翰斯·霍普金斯大学与默克团队提出的STRAND,则聚焦另一个问题:如果干预其中一处,能不能连这段序列之外的基因会怎样响应,也一起预测出来? 团队把目光投向干预后的连锁响应:指定DNA上的一个位置,结合未干预细胞的状态,生成扰动后的多基因表达谱。 局部DNA提供干预线索,预测的基因响应则可以延伸到输入窗口之外。 该工作已被NeurIPS 2026主会接收,代码已公开。
蛋白编码序列只占约1.5%,干预预测如何走出编码区 人类基因组中,直接编码蛋白的序列只占约1.5%。更广阔的非编码区域包含控制基因何时、何处、以多大强度表达的调控元件。启动子像“启动入口”,增强子则能调节基因活性:想改变细胞行为,可操作的位置远不止基因标签所代表的对象。 许多single-cell perturbation模型用gene ID描述干预。对同一基因的两个启动入口分别做干预,输入仍是同一个ID,模型没有获得区分位置的信息。 STRAND把干预输入改为“DNA序列+目标位置”。论文给出的架构输入支持约覆盖95%的基因组,以128 bp为表示单元,允许在非编码区域指定干预位置。
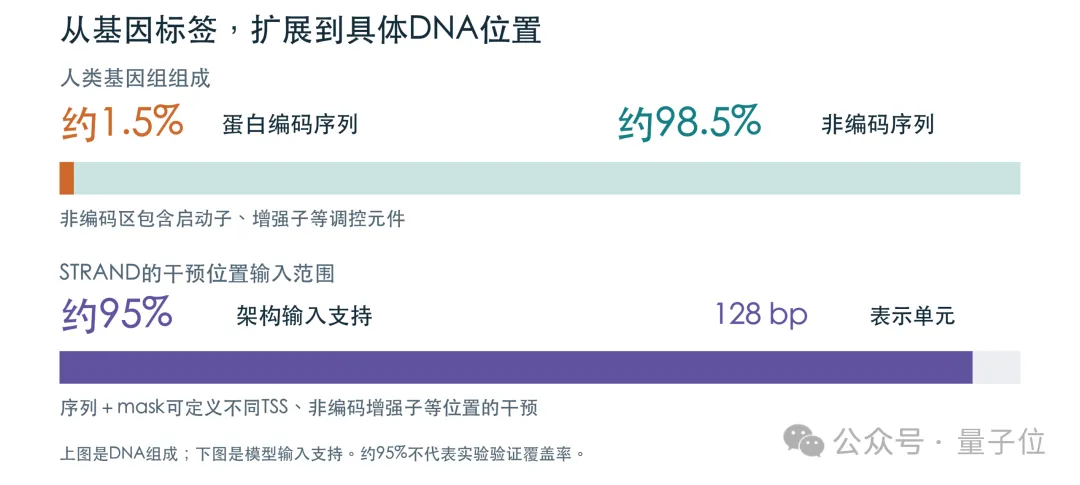
△约1.5%对应蛋白编码序列,约95%对应STRAND的架构输入支持。 DNA foundation model怎样接上单细胞扰动 难点在于,两类数据的粒度不同:DNA模型能给出序列位置上的表示,许多单细胞扰动数据却只标注“干预了哪个基因”。STRAND用一个可学习的DNA接口,把序列表示接到细胞响应生成模型上。 可以把细胞状态想成山坡上的小球:起点相同,干预的位置不同,小球可能进入不同山谷。
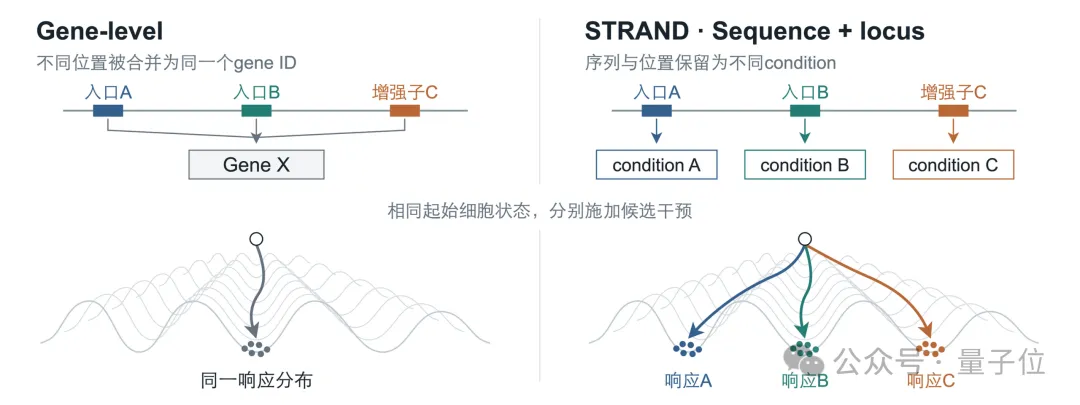
△同一细胞背景下,按基因标签输入与按序列、位置输入的区别。山谷中的点群表示预测响应分布,地形与路径为概念示意。 让不同位置带上各自的condition STRAND使用冻结的Flashzoi/Borzoi编码DNA,每个token对应128 bp。mask标记要模拟干预的区域,保留周围序列作为上下文。 DNA perturbation module先汇总mask覆盖的token,形成Query;再用cross-attention读取窗口内的序列信息,并加入相对距离偏置。这样生成的condition同时描述“作用在哪里”和“周围有什么调控线索”。移动mask,即使gene ID不变,模型收到的干预表示也会改变。 对于只有基因名的数据,团队用转录起始位点(TSS)前后200 bp作位置近似;有精确gRNA坐标时,则按实际位置构造输入。DNA foundation model提供预训练的representation,单细胞实验负责教会新增模块:这种序列条件对应怎样的细胞变化。粗粒度实验标签由此接上了带位置和序列内容的输入,推理时便能询问不同DNA位置的影响。
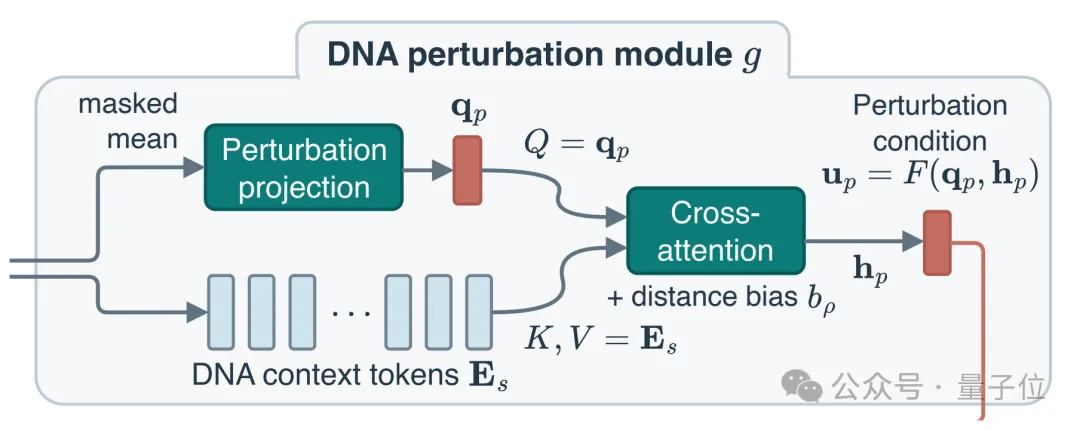
△DNA模块局部。目标区域形成Query,cross-attention读取窗口内的序列上下文。 让Diffusion从真实细胞状态出发 冻结的RNA编码器SCimilarity把未干预的control cell表达谱压缩为latent。由于单细胞测序通常不能追踪同一个细胞的前后变化,STRAND先用Optimal Transport在对照与扰动细胞群之间建立统计配对。 随后,I²SB在两端latent之间构造带噪的中间状态,学习以DNA condition和control latent为条件,恢复扰动后的状态。推理从control cell的latent起步,经多步reverse bridge生成响应。这使细胞原有状态直接参与生成。 例如,一次干预可能让一半细胞强烈响应、另一半几乎不动。它的平均值可能与“所有细胞都变化一点”相同,实际细胞群却很不一样。Diffusion要学习的正是这种响应分布。 最后,残差decoder以control表达为参照,将生成的latent还原为多个基因的表达变化,并分别处理零表达与非零表达。训练还用对比学习,将DNA条件与平均RNA变化对齐。联合评估使用2000个高变基因作为输出面板;这些输出基因不必位于输入DNA片段内。
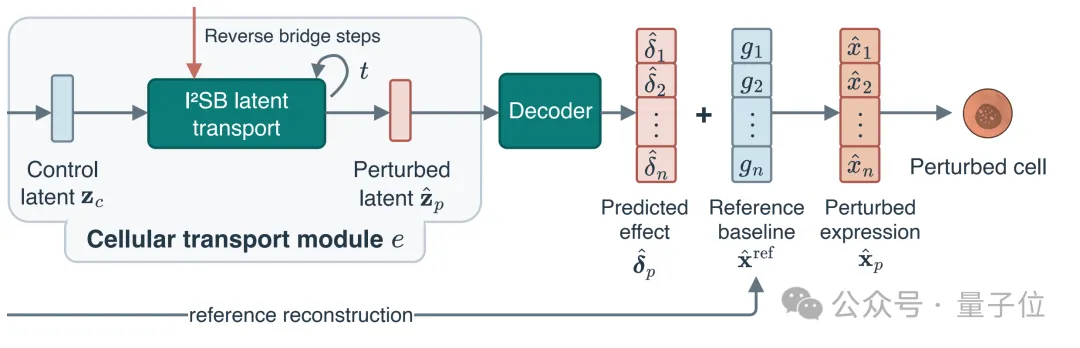
△生成与解码模块局部。DNA condition进入I²SB,control latent提供起点,decoder输出多基因表达预测。 同一个基因的两个入口,gene-level模型分不开 以FLVCR1为例:这个基因有多个不同的转录起始位点(相当于不同的转录“入口”),能产生功能各异的蛋白亚型。已有实验表明,在K562细胞中,由另一处起始位点(替代入口)产生的FLVCR1b对红系分化尤为重要。 STRAND分别在这些入口施加虚拟干预,将FLVCR1b入口排在五个候选入口的首位,预测影响分数为0.683,高于常用FLVCR1a入口的0.564,与已有功能研究一致。 对只以gene ID为干预条件的模型,这两个问题对应的是同一个输入,因此无法根据位置给出不同响应。而STRAND可以分别针对这两个位点进行测试,并比较它们的影响。同样,当目标换成没有独立gene ID的增强子时,依然可以靠序列与坐标来定义干预。 在e-HDAC6增强子附近,STRAND的扫描曲线出现局部峰值,距已验证增强子中心不足400 bp。只接收基因标签的模型无法沿这段DNA输出随位置变化的响应曲线;而在STRAND里,这直接变成了可计算的输入。
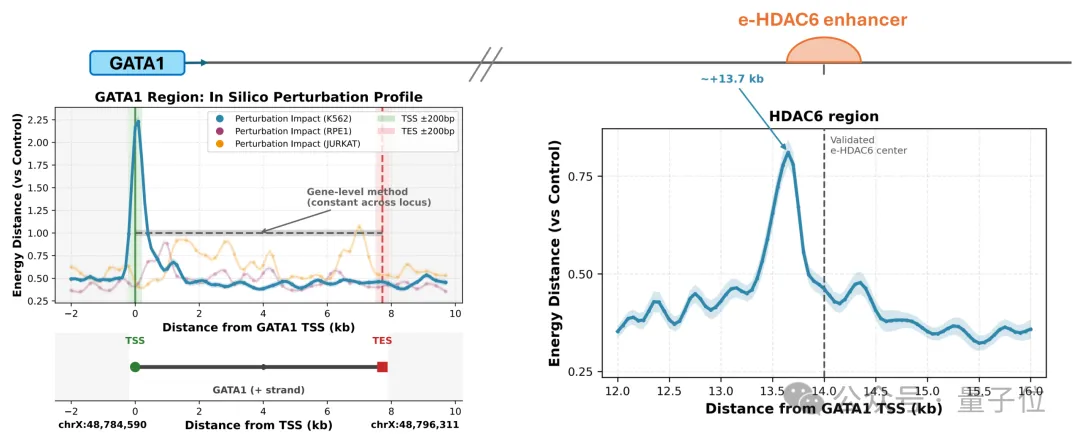
△左图灰色曲线展示gene-level模型在基因内部不能区分位置;右图为STRAND在非编码增强子附近的预测峰值。FLVCR1与e-HDAC6是对照既有生物学证据的位点案例。 换一个干预、换一种细胞,还能预测吗 在K562、Jurkat、RPE1三个细胞系的few-shot实验中,每个测试基因只提供5个扰动细胞用于训练。STRAND在七项指标上的综合平均排名为1.86,次优方法为3.14。其中,K562的扰动判别分数从STATE的0.538升至0.710,相对提高约32%;对训练未见的基因,STRAND也取得所评测方法中的最佳综合排名。 消融实验进一步检验两个模块的作用:相较固定平均池化,DNA模块使top-100变化基因上的Pearson相关性平均相对提高16.6%;相较确定性MLP,生成模块使联合数据集的Energy Distance降低38.9%,预测更接近实测细胞分布。 跨细胞系测试采用“在其他细胞系上训练、第其中一个细胞系完全留出(held-out)”的设置。对变化最大的100个基因,STRAND预测上调或下调方向的平均吻合率为58.7%,STACK和STATE分别为50.0%和48.1%。在独立来源的HCT116测试中,模型仅需使用目标细胞系的control cells(无需其扰动数据或重新训练),吻合率即可达到56.8%。 先在模型里比较“改哪里” 对实验研究者而言,可以固定细胞背景,扫描一个基因的不同入口及周围调控位置,比较预测响应,再选择更有希望的候选做实验。当前验证围绕CRISPRi,即在指定区域压低转录活性;其他编辑方式仍需对应实验检验。 对AI研究者,STRAND展示了如何将两类foundation model接到一个新任务上:DNA模型提供带序列内容与具体位置的干预表示,RNA模型提供系统当前状态,conditional generation学习干预后的变化。由此,虚拟细胞可以继续追问:同一个基因,换个入口会怎样;移到一个非编码调控位置,又会怎样?