


越来越多文章,“AI里AI气”的
AI味怎么来的,可能并不重要。重要的是,AI味已经影响到人类的写作,并蔓延到我们的日常生活里,影响到我们怎么说话。 “AI味”是怎么来的 作为一名头部网络文学平台的资深编辑,大方的工作早就形成了固定的模式:通常书稿看到第二章或者第三章,他就能确定一部稿件能不能通过。但从2023年开始,大量使用AI辅助撰写的稿件涌入稿库,他判断稿件的时间反而大大缩短了,“很多时候,我看第一页就能知道用没用AI”。 这样的稿件往往有非常典型的创作模式:读了1000字主角还没有出现,全是天花乱坠的景色描写。人物会毫无来由地“压低声音”或者“沉声道”,交谈时频繁“敲了敲桌子”或者“喝了口茶”。“不能因为出现一个个例,我就判定它是AI生成的。但如果在20万字的小说里频繁出现这些描写,AI写作的概率就很大了。” 侦查“AI味”现在不仅仅是编辑在做,很多内容消费者也会下意识地启动“文字嗅觉”,比如寻找某些标点符号,某些词语,某些句式的频繁使用。大家的直觉可能是对的。
侦查“AI 味”现在不仅仅是编辑在做,很多内容消费者也会下意识地启动“文字嗅觉” (视觉中国供图) 通常,大模型会偏爱某些词汇。佛罗里达州立大学的计算语言学家汤姆·S.尤泽克(Tom S. Juzek)和哲学家齐娜·B.沃德(Zina B. Ward)比较了人类文本和AI文本,发现ChatGPT常使用intricate(复杂的)、underscore(强调)等20个词汇。 他们认为,这受到很多因素分别的或者多种因素叠加的影响:也许在用来训练大模型的初始数据中,这些词的出现频率很高;也可能是大模型本身的架构或算法导致的;预训练之后的微调(fine-tuning)也可能带来新的词汇偏好。在这个阶段,模型会接触大量示例对话,如果其中某些词出现得特别频繁,模型就可能更倾向于使用它们;还有一种可能来自“基于人类反馈的强化学习”(reinforcement learning from human feedback,RLHF),即人类给不同类型的回答打分,模型由此学会生成与高分范例相似的回答。 “AI味”还表现在对特定的句式结构有偏好。语言学家发现,人类使用的句法结构和词汇条目总体更加丰富,也更常使用罕见、直接或非正式的表达;相比之下,大模型表现得像一种“平均化的作者”。还有研究者注意到,经过强化学习训练的奖励模型常常偏好更长的回复,在某些情况下,它们会把“更长”误认为“质量更高”。 更重要的是,“AI味”改变的不仅仅是内容的语言特征。西湖大学工学院教授、长期从事自然语言处理研究的张岳说,他收到的学生作业,如果是用AI辅助完成的,就会出现更多形式上的套话,却缺乏对专业内容的深入理解。
《normal people》剧照 AI与人的差别 “AI味”的内容,现在被很多人抵触。计算语言学家艾米莉·M.本德(Emily M. Bender)在个人网站上,明确表示自己不读“AI slop”(AI垃圾),“请不要发给我任何这类东西”。本德相信,人使用语言,是为了表达和交流某种想法。她这种直白和字斟句酌的敏感,让我在采访她之前,诚惶诚恐地起草采访邀请。 “我们必须想象这些词背后有一个有心智的思想主体。但对于大语言模型来说,它们背后根本没有这样一个主体。所有的意义都是我们自己投射进去的。”本德告诉本刊。普通人虽然无法像专家一样用学术语言来表达这种感受,但潜意识里,跟AI进行思想交流,会有一种真心错付的感觉。
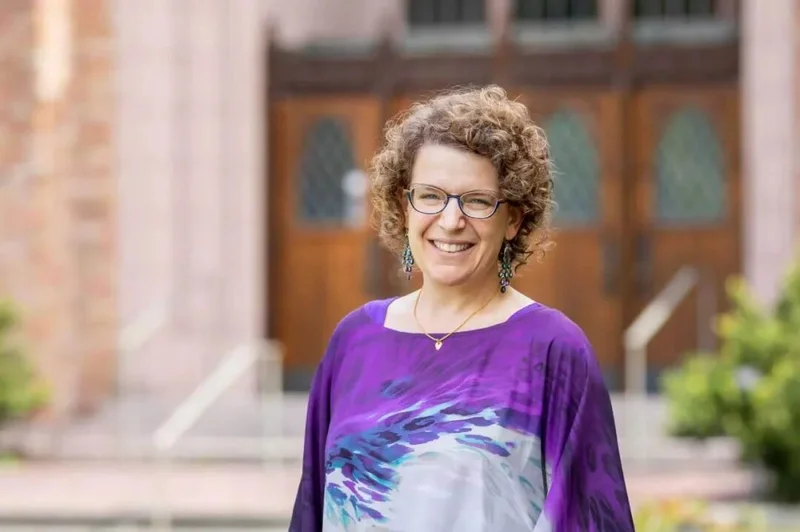
计算语言学家艾米莉· M.本德 人终究还是在意AI和人之间的差别,这也是张岳研究的领域。他的研究室位于西湖大学校园中心一座被称为“学术环”的环形建筑中——它将几个主要院系的教学楼串联起来,为学科碰撞提供了天然场域。张岳的研究室,就有一种跨学科视角,这里不仅有计算机专业的学生,还有语言学、神经科学和历史学等专业的同学。 2018年前后,随着大语言模型的发展,他的研究兴趣逐渐从神经网络架构和计算语言学的基础问题,转向AI与人类智能的差异,“我们当时很创新的一个想法是把AI当成一种智能,看它和人类的智能有什么区别”。 张岳觉得,仅仅从“像不像人”这个维度看,目前的AI已经可以做得比较好了。张岳提起一项研究:研究人员把一段文本的前30个词交给大语言模型,让它继续往后写,再把原文和AI续写的文本交给人判断,看他们能否分辨哪一段来自机器、哪一段来自人类。结果,人类判断的平均准确率只有约54.5%,已经非常接近随机猜测。
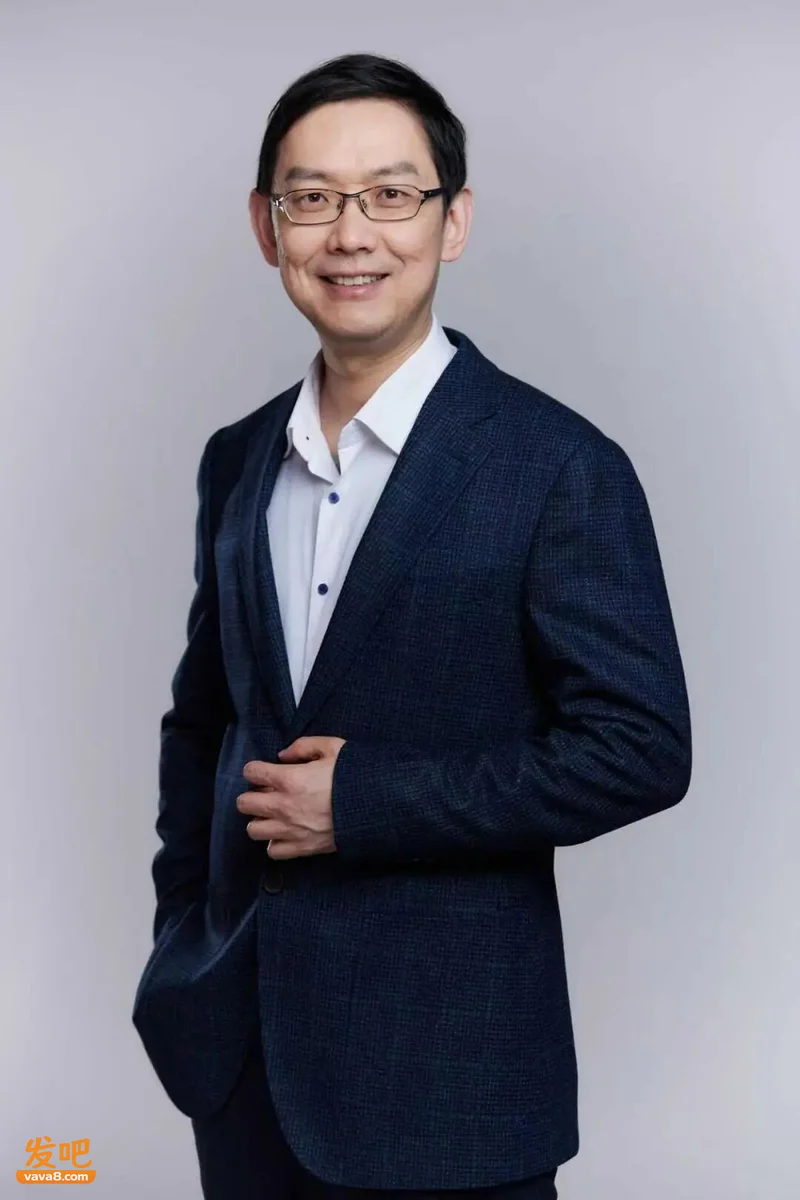
西湖大学工学院教授张岳 但在张岳看来,无论模型在表面上变得多么像人,它和人的“思维方式”仍然不同,而这种差异也会让AI在一些地方露出马脚。“不同于人的因果性思维,AI的‘思维’是统计性的。它永远是依靠训练数据中的统计规律,预测下一个词可能是什么。” 他给学生举过一个例子:在“我把面包扔给了鹈鹕”和“我把面包扔给了篮球”两个选择里,因为“鹈鹕”是比“篮球”更不常见的词汇,所以模型可能会选择后者,却忽视了“篮球”和“面包”的关系。今天的模型当然很少犯这样明显的错误,因为它已经见过海量文本,也接受了大量后训练。但类似的问题并没有消失,只是可能变得更加隐蔽。在专业领域,有时只有具备足够知识的人,才能发现一段看起来流畅的AI文本究竟错在哪里。 这种生成机制也会影响AI文本的信息密度。张岳实验室的另一项研究发现,模型生成内容的前半部分往往更接近人类文本的分布,但随着回答不断变长,内容可能不断趋同,信息密度也越来越低。“因为内容越短,它面临的选择就越多样;但随着内容变长,为了和前面保持一致,它就越来越固化。”张岳说。
《黑帮的我成了高中生》剧照 张岳认为,未来的大模型可能会无限逼近人类,也会完成越来越多人类无法完成的复杂任务。但因为AI和人的本质差异,在有些人类觉得很简单的任务上,AI还是会犯错。 “卡文”才出好作品 大方对“AI味”的甄别,不仅仅因为内容消费者可能会抵触,也因为一旦采用了AI辅助,无论是原本能力很强的作者,还是刚刚入行的新作者,这几年都始终不能写出一部超越过去的作品。 根据大方多年的编辑经验,很多真正出色的作品,反而是在“卡文”的过程中产生的。一处神来之笔可能来自作者冥思苦想之后的所得,也可能是在连载更新的压力下临时冒出来的,还可能来自一次采风之后不断涌现的新想法。“写作的时候,作者的思维看似集中在当下的任务上,但他的大脑可能不止在考虑眼前要写的这段剧情,还可能会涌现出很多胡思乱想的东西,包括后面可能出现的一些剧情。对于创作来说,这些‘旁逸斜出’都是非常美妙的养料。”
《normal people》剧照 但AI让创作停留在浅表的层次——现在的一般操作是,作者先写一个细纲,搭好剧情骨架,再交给AI扩写。大方认为,这样做的问题在于,作者不再需要全神贯注地进入这个具体的情境中去,也不再会有痛苦思考和触发灵感的过程。换句话说,“这省略了人的创作过程,导致作者没法提升自己的上限”。这也让大方担忧,新作者会受到AI影响,不再能经历一个完整的成长过程。 有一位原本成绩不错的作者,新作品用AI辅助之后,成绩一直不好。停用之后,作品成绩才回到原来的水平。两相对比,那个作者告诉大方:AI出现以后,每当遇到卡文,他就习惯让AI替自己补几百字。后来即使停止使用AI,这种思维惯性仍然保留了下来。每到写不下去的地方,他第一反应依然是,先水几百字过去。 但更多的作者意识不到这一点。大方认为这暴露了“人对自己的能力的无知”。担任编辑多年,他越来越强烈地意识到,写作能力和审美判断不能画等号,“有写作能力,不意味着能判断自己写得好不好,也不意味着知道自己为什么能写得好”。
《run on》剧照 尤其在网络文学这种商业写作中,最重要的并不是文笔,而是把故事讲好,读者才会想读下去。过于华丽的文笔反而会稀释原本紧凑的情节。但一些原本很优秀的作者看到AI生成的文字,反而会觉得大模型写得比自己好,“因为他这辈子从来没有写过这么华丽的东西,对于‘优美的文笔’有一种天然的倾慕”。 这种面对AI时产生的“自卑”,已经不只存在于网络文学创作中。本德近来尤其担心的是,如果一个人逐渐相信,自己的文字必须经过某个系统修改,才能“看起来更好”,这种使用过程可能就会不断强化一种语言上的自卑感。 作为一名大学教授,本德不希望学生用AI写作业,“我担心,我们可能会失去一代人中的一部分。其中本来可能有人会成为作家、记者,或者非虚构作者。但因为人们不再经历那种挣扎,或者说那种学习如何以自己的方式写作、慢慢找到自己的声音的过程,他们也可能永远不会成为自己本来能够成为的写作者”。 语言的未来 本德最为人熟知的观点之一,是用“随机鹦鹉”(stochastic parrots)来形容大型语言模型:模型通过统计规律预测接下来最可能出现的词;但就像鹦鹉学舌一样,它并不理解自己所说的内容。
《Her》剧照 这个说法曾经有争议。斯坦福大学教授、计算语言学家克里斯托弗·曼宁(Christopher Manning)也曾和本德公开讨论。曼宁认为,语言的意义可以从词语出现的语境中形成,而本德则坚持,语言本质上是关系性的,需要对话者共同努力才能达成沟通。 比本质上在跟一只“随机鹦鹉”沟通更让人警惕的是,不断有研究证明,AI可能会改变人类自己的语言习惯。澳大利亚斯威本科技大学高级研究员杰里米·阮(Jeremy Nguyen)曾经进行了一项实验:他和同事邀请了320人撰写一篇在二手交易平台上出售沙发的广告文案。之后,他们向参与者展示ChatGPT在相同提示下生成的文本,并要求他们再次完成同样的任务。结果,参与者在看到人工智能生成的文本后,写得明显更加冗长,平均写了87个字,而第一轮只有32.7个字。 人类也开始使用AI偏爱的词汇。德国马克斯·普朗克人类发展研究所的研究人员分析了近28万个来自学术频道的YouTube视频,发现在ChatGPT发布后的18个月里,使用者使用“meticulous(细致)”“delve(深入研究)”“realm(境界)”和“adept(熟练)”等词汇的频率,比三年前高了51%。
《猎罪图鉴2》剧照 本德对此并不意外。她告诉我,对语言模式保持敏感,本身就是我们学习语言的一部分,“有时候这种学习很直接。比如有人会教你‘这种论文应该这么写’‘商务信件应该这么写’‘顾客进店以后应该这么打招呼’”,但很多时候,我们也会在没有意识到的情况下自然习得语言,“比如,一些人可能很钦佩自己的某些专业同行,而这些同行恰好在使用这些大语言模型。于是,他们可能会学习这些同行的说话或者写作方式,而没有意识到这些模式其实来自机器”。 AI也带来了对语言同质化的担忧。本德提醒我们,大模型生成的语言很大一部分取决于它们学习到的语料,或者说,取决于“哪些类型的语言能够被收集数据的人拿到”。这些数据可能包括网络上的公开数据、社交媒体数据,甚至是已经出版的图书。“但这些材料距离真实语言生活的全部还差得非常远。” 另一个问题是,在模型训练中,英语(其次是中文)的语料往往最为丰富,因为它们拥有大量使用者。想想我们和AI说话时感受到的“翻译腔”就知道了:这些文本确实是中文写的,但它背后大量的语言材料可能来自英语,经过模型处理,再以中文形式表现出来。而对于使用者更少的语言,这种区别可能更加明显,它们也可能面临更大的被侵蚀风险。
《绝望写手》剧照 AI的影响下,人类语言虽然笼罩在“同质化”的阴影里,我们还是要对身为人类所具有的创造力有信心。本德提醒我们,所有语言都有很长的“语言游戏”的历史。人们一直会利用手头已有的语言资源创造新的东西,尝试不同的表达。本德甚至举了一个中文里利用谐音进行双关的例子:“我知道你们可以用一个读音相同、意义不同的汉字来替代另一个字,由此形成各种非常有意思的表达空间。而且我觉得,随着时间推移,其中一些表达后来甚至会获得新的意义。” “如果你把‘语言’理解为‘某个特定时间点上我们能够接触到的全部文本’,那么确实可能正在发生某种同质化。”但是,本德认为,如果把语言理解为具体社群里用于人与人之间交流的、活生生的东西,那么她对大规模的同质化持怀疑态度。