6天烧光2000多万,拿下开源第一
6天,2000多万,小米这场史无前例的「炼丹直播」终于尘埃落定。
过去这六天,小米把一场大模型强化学习训练搬进直播间,眼看着美元计价器一路狂跳。
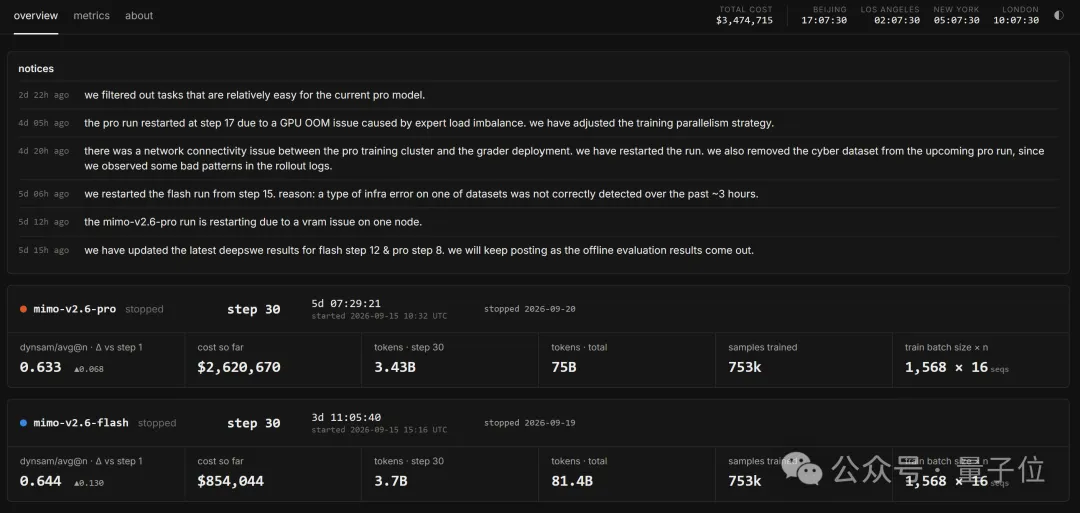
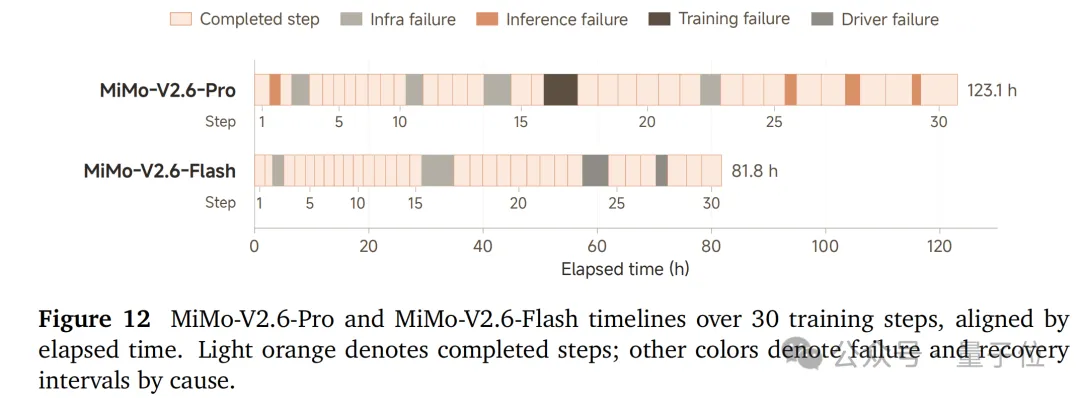
如今,MiMo-V2.6的Pro和Flash双双跑完30个训练Step,最终账单定格在350万美元(约合人民币2344万元)。
钱烧完了,模型也冲上去了。
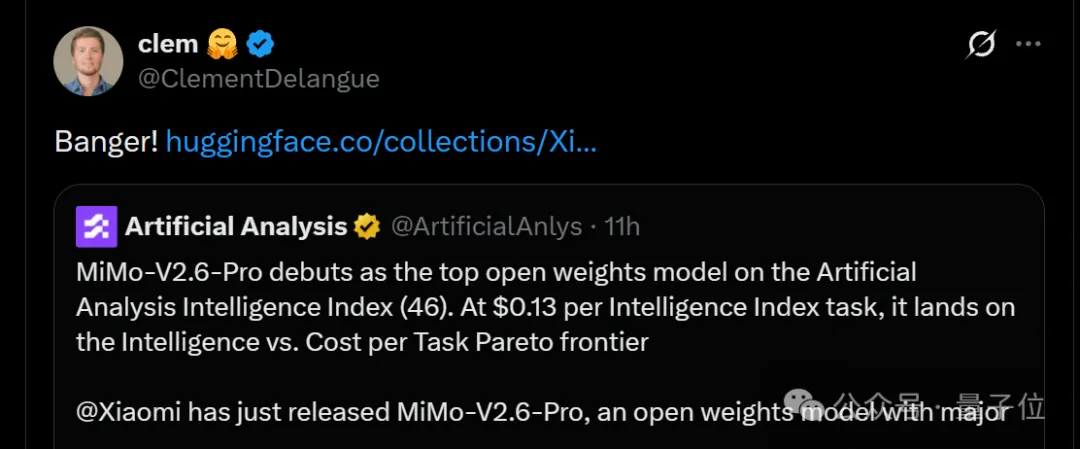
MiMo-V2.6-Pro,1.02万亿参数,420亿激活,在Artificial Analysis Intelligence Index上拿到46分,位列开源第一。
Hugging Face CEO也称赞说,「太棒了」。
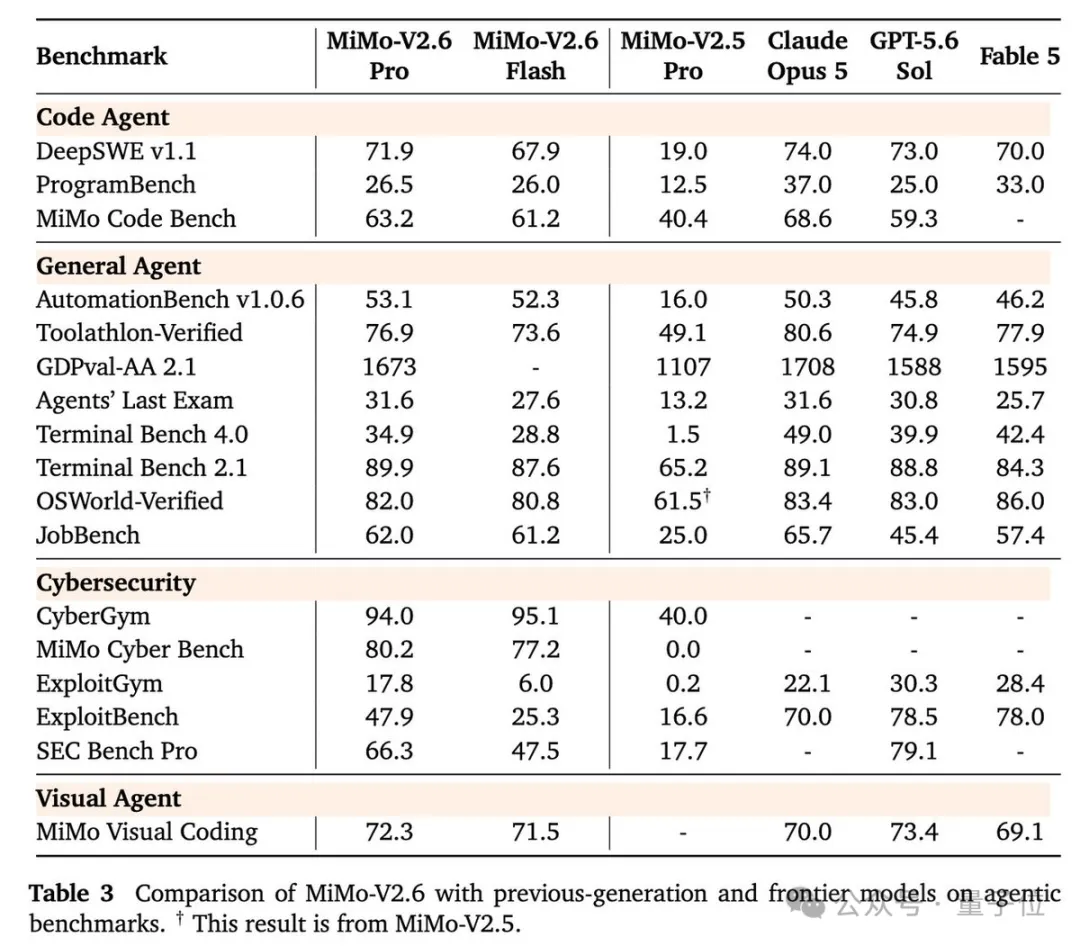
并且在多数Agent评测中,Pro的成绩已经逼近Claude Opus 5和GPT-5.6 Sol。
罗福莉将其称为「迄今为止任何开源模型团队所进行的规模最大的单次强化学习训练之一」。
还没完,更猛的还在后面,这位曾参与DeepSeek-R1研发的小米MiMo负责人直言:
在我看来,它背后的研究创新和工程挑战,超过了我曾参与其中的DeepSeek-R1。
这话分量有多重?看完MiMo-V2.6的训练细节就知道了。
2000多万烧完,开源模型冲进闭源前沿
聊技术之前,先带大家快速过一下这次直播的「收官战报」。
MiMo-V2.6-Pro跑完30个Step,用时5天3小时,花掉约260万美元;
Flash同样跑完30个Step,用时3天10小时,花掉约90万美元。
每个Step包含1568个Prompt,每道题让模型尝试16条不同路线,一轮就会产生超过2.5万条Rollout。
按技术报告单步2.7B~3.7B training tokens计算,Pro全程累计处理约81B~111B Tokens,相当于塞满超过8万个百万Token上下文窗口。
这么多Token和真金白银砸下去,效果也相当直接。
30个Step结束后,Flash的平均通过率相对提升25%,Pro相对提升12%。
整体上涨之外,更有说服力的变化出现在DeepSWE v1.1这项样本外测试上。
Pro从58.4分涨到72.57分,提升约14分;
Flash从48.7分涨到65.68分,提升约17分。
DeepSWE v1.1专门考察Coding Agent能不能在真实开源代码库中持续工作,OpenAI和Anthropic也已将其列为前沿模型发布时的重点评测项。
MiMo-V2.6的表现侧面说明,这轮RL不是在训练集上原地刷分,只跑30个Step,模型不仅持续变强,还把能力迁移到了没见过的软件工程任务上,样本效率和样本外泛化一定程度上经住了检验。
尤其是Flash,30个Step跑完花费仅为Pro的约三分之一,相对提升反而更大,堪称这次训练的「性价比选手」。
至于Pro,负责的则是冲击能力上限。
在Artificial Analysis Intelligence Index中,MiMo-V2.6-Pro拿到46分,成功登上全球开源王座。
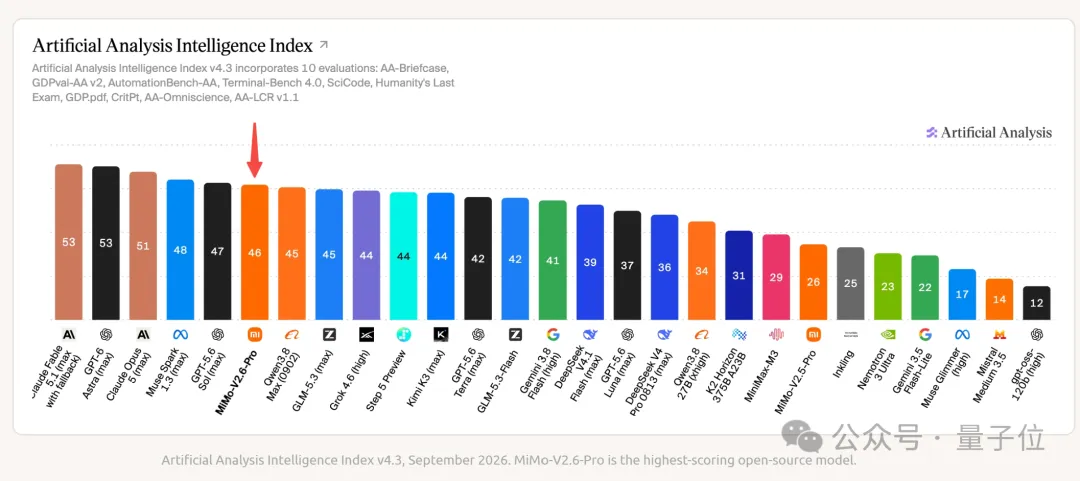
部分Agent评测中,它也已经和头部闭源模型打得有来有回。
例如AutomationBench上,Pro拿到53.1分,超过Claude Opus 5的50.3分和GPT-5.6 Sol的45.8分。
再结合其他评测来看,MiMo-V2.6-Pro在全球模型市场中的位置已经相当清晰:
冲进开源模型第一梯队,并在部分Agent任务上摸到了闭源前沿。
而且能力冲上去之后,价格并没有跟着涨。
MiMo-V2.6继续沿用V2.5的API定价,Pro输入/输出每百万Token约3元/6元,Flash约1元/2元。
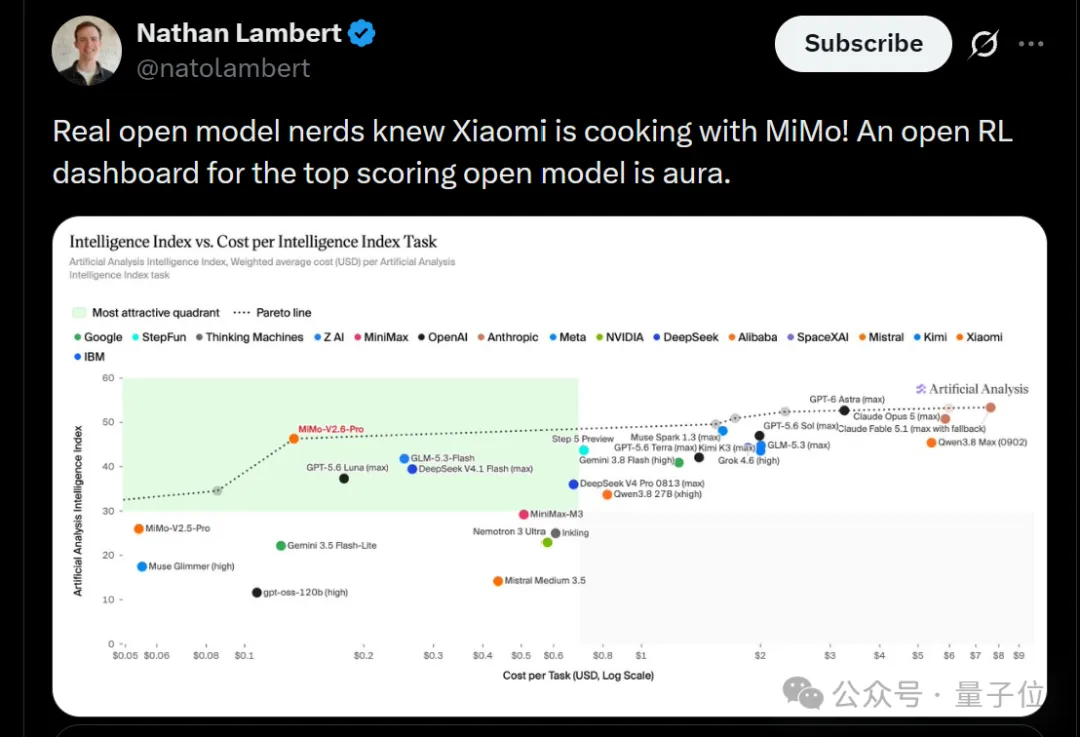
横向一比更夸张,在同等智能水平下,Pro完成任务的成本仅为国际前沿模型的1/20至1/60。
按照Artificial Analysis的测算,MiMo-V2.6-Pro完成一项Intelligence Index任务,平均成本只有0.13美元(约合人民币0.9元)。
也就是说,小米第一次把45分以上前沿模型的单任务成本,打进了0.1美元量级(约合人民币0.67元)。
巧的是,同日发布的闭源模型Grok 4.7,在这项指数上同样拿到46分,但据Artificial Analysis实测,其xHigh版本完成一项任务平均需要3.74美元,约为MiMo-V2.6-Pro的29倍。
同步上线的MiMo-V2.6-UltraSpeed模式,最高速度还能达到约900 TPS。
成绩单晒完,小米紧接着又把开源清单摊开了,一看阵仗还真不小。
Pro和Flash模型权重、完整技术报告、7000多个RL任务环境、端到端RL训练框架,以及可以自由组合的mini-harnesses,全部开放。
此外还有一个MiMo-V2.6-Distill-Qwen-9B,这是一个以Qwen3.5-9B为底座,使用MiMo生成的77.4B Token数据完成监督微调的模型。
小米开放的是SFT版本,主要也是想给社区提供一个更强的Agent RL起点。
总之这一波,模型、训练场、裁判和训练流水线,小米基本都给配齐了。
也难怪小米一开源,整个AI圈瞬间沸腾。
罗福莉本人的推文在短短几小时内获得几十万浏览,不少大V也火速下场转发评论。
Ai2后训练负责人Nathan Lambert直接表示:
真正懂开源模型的人,早就知道小米在用MiMo憋大招。
Hugging Face前研究员Elie Bakouch关注的则是开源速度:
最夸张的是,他们在最终RL训练启动不到一周后,就交出了模型、技术报告、7000多个RL环境和完整训练框架。