

老码农眼中的“距离”
【引】回忆与一个AI 产品经理的对话,否则就可能真的忘记了......
我们经常需要判断两个数据点之间的“相似程度”——比如给用户推荐喜欢的商品,要先找到和他兴趣相近的用户;做异常检测,要找出和正常数据差异大的异常值;聚类分析时,要把相似的数据归为一类。而衡量这种“相似”或“差异”的核心工具,就是距离指标。
简单来说,距离指标就像我们生活中用尺子量长度一样,只不过它量的不是物理空间的长度,而是数据之间的“差异度”。距离越近,说明两个数据越相似;距离越远,差异就越大。在这里, 老码农就尝试用最朴素的语言,讲清楚机器学习中最常用的9个距离指标,包括它们的含义、公式、简单示例,以及实际应用场景,哪怕是刚接触机器学习的朋友,也能轻松看懂。
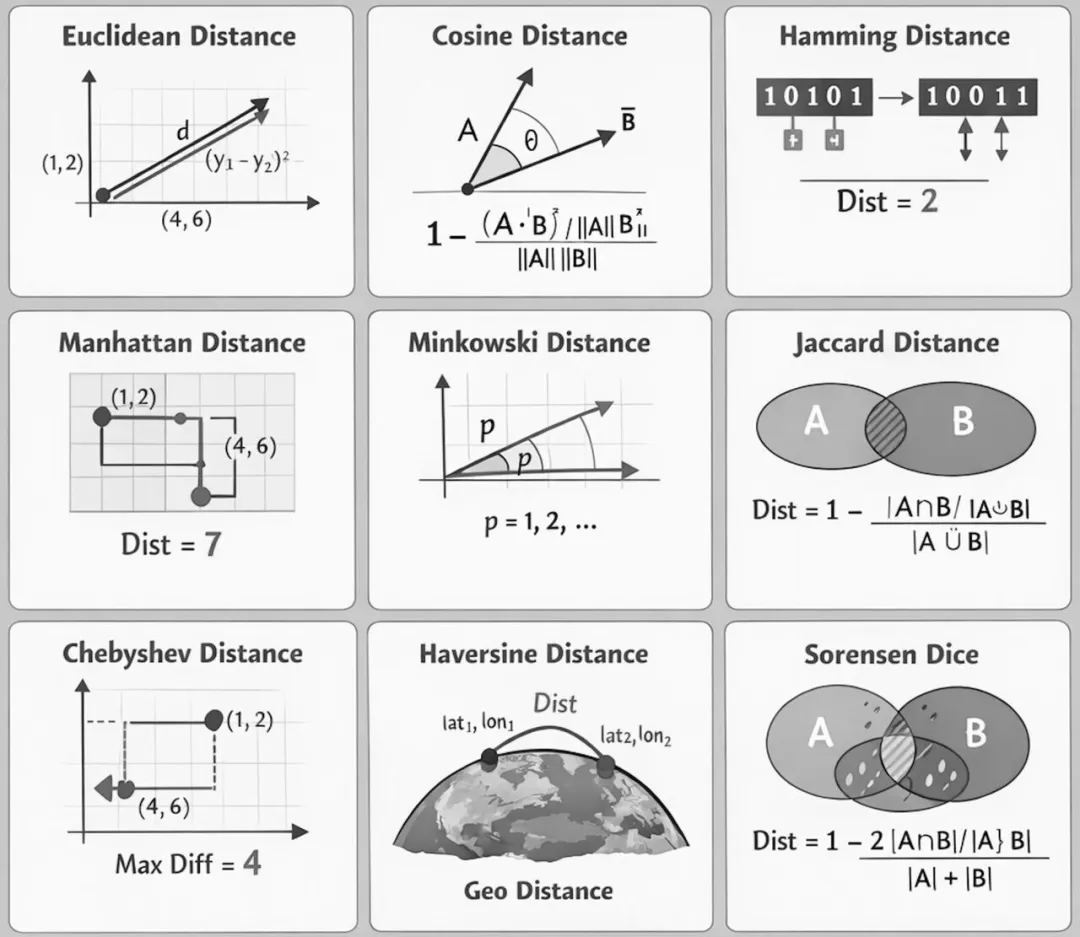
一、欧几里得距离,最直观的“直线距离”
欧几里得距离应该是我们最熟悉的距离指标,它的本质就是我们在初中几何里学的“两点之间直线距离”,也是生活中最直观的距离概念。比如从家到公司,走直线的距离就是欧几里得距离,只不过在机器学习里,这个“点”不再局限于二维平面,还可以是三维、四维甚至更高维度的特征数据。
它的计算逻辑很简单:把两个数据点在每个维度上的差值平方,加起来之后再开平方,得到的结果就是两者的欧几里得距离。
公式:√[(x₁ − x₂)² + (y₁ − y₂)²](如果是更高维度,就继续往后加,比如三维就是再加(z₁-z₂)²)
示例:假设我们有两个二维数据点,分别是(1,2)和(4,6),按照公式计算,先算每个维度的差值:x维度差是4-1=3,y维度差是6-2=4;然后把差值平方,得到9和16;加起来是25,再开平方就是5。所以这两个点的欧几里得距离就是5。
适用场景:欧几里得距离最适合用于特征是数字,且所有特征处于同一尺度的场景。比如在KNN(K近邻算法)中,判断一个数据点的类别时,就会用欧几里得距离找它最近的K个邻居;K均值聚类中,也常用它来衡量数据点和聚类中心的距离。需要注意的是,如果特征尺度不一样(比如一个特征是身高,单位是厘米,另一个是体重,单位是公斤),直接用欧几里得距离会有偏差,需要先做数据归一化。
二、余弦距离,不看“长短”,只看“方向”
和欧几里得距离不同,余弦距离不关心两个数据点的“绝对长度”,只关心它们的“方向差异”。举个生活中的例子,两个人评价一部电影,一个人打了8分、7分,另一个人打了4分、3.5分,虽然分数高低不一样,但他们的评价方向是一致的,余弦距离就会认为这两个人的喜好很相似。
在机器学习里,我们通常把数据转换成向量,余弦距离就是通过计算两个向量之间的夹角来衡量差异,夹角越小,距离越近,相似度越高。它的公式是用1减去两个向量的余弦相似度,这样距离越近,数值就越小,和其他距离指标的逻辑保持一致。
公式:1 − (A · B) / (||A||||B||)(其中A·B是两个向量的点积,||A||和||B||分别是两个向量的模长)
示例:假设向量A是(1,0),向量B是(0,1),先算点积:1×0 + 0×1 = 0;再算模长,两个向量的模长都是√(1²+0²)=1;代入公式就是1 - 0/(1×1) = 1,说明这两个向量方向完全相反,差异最大。如果两个向量是(1,2)和(2,4),点积是1×2 + 2×4=10,模长分别是√5和√20,计算后余弦相似度是1,余弦距离就是0,说明两个向量方向完全相同,相似度极高。
适用场景:余弦距离最适合用于衡量“内容相似度”,和数据的绝对数值无关。比如自然语言处理中,判断两篇文章的主题是否相似,会把文章转换成词向量,再用余弦距离计算;推荐系统中,基于用户的行为偏好向量,判断用户兴趣相似度;还有图像识别中的特征嵌入,也常用余弦距离来衡量特征的相似性。
三、汉明距离,数“不同”的个数就够了
汉明距离是一种很简单的距离指标,它的核心就是“数差异”——统计两个等长的字符串或向量中,对应位置上数值不同的个数,个数越多,距离越远。它的应用场景主要集中在离散数据,尤其是二进制数据的比较。
公式:统计两个数据对应位置上x≠y的数量,数量就是汉明距离
示例:比如两个二进制字符串10101和10011,我们逐位对比:第一位都是1,相同;第二位都是0,相同;第三位一个是1,一个是0,不同;第四位一个是0,一个是1,不同;第五位都是1,相同。总共2个位置不同,所以汉明距离就是2。再比如两个字符串“abcde”和“abxde”,对比后发现第四位不同,汉明距离就是1。
适用场景:汉明距离主要用于二进制特征的比较,比如图像处理中的哈希值比较,判断两张图片是否相似;数据传输中的错误检测,统计传输前后数据的差异,判断是否出现传输错误;还有推荐系统中,用户的二进制行为特征(比如是否点击、是否购买)的比较,也会用到汉明距离。
四、曼哈顿距离,像走城市街区一样的距离
曼哈顿距离也叫“城市街区距离”,这个名字很形象——就像我们在城市里走路,不能走直线,只能沿着街道水平或垂直移动,从一个路口到另一个路口的距离,就是曼哈顿距离。它的计算方式是把两个数据点在每个维度上的差值绝对值相加。
公式:|x₁ − x₂| + |y₁ − y₂|(更高维度同理,依次加每个维度差值的绝对值)
示例:还是用之前的两个点(1,2)和(4,6),计算曼哈顿距离的话,先算x维度差值的绝对值|4-1|=3,y维度差值的绝对值|6-2|=4,加起来就是7,所以曼哈顿距离是7,比欧几里得距离的5要大,这也符合我们在城市里走路比走直线远的常识。
适用场景:曼哈顿距离适合用于“基于网格”的场景,比如地图导航中,计算车辆在城市道路上的行驶距离;路径规划问题中,机器人在网格状的环境中移动,衡量其移动的距离;还有一些离散数据的聚类问题,尤其是特征维度的差异需要独立计算的场景,也会用到曼哈顿距离。
五、闵可夫斯基距离,欧几里得和曼哈顿的“通用版”
闵可夫斯基距离不是一种具体的距离,而是一个“通用公式”,它把欧几里得距离、曼哈顿距离都包含在内,通过调整一个参数p,就能切换成不同的距离计算方式,灵活性很高。
公式:(Σ|xi − yi|^p)^(1/p)(其中p是一个参数,取值为正数,Σ表示对所有维度的差值绝对值的p次方求和)
示例:当p=1时,公式就变成了Σ|xi − yi|,也就是曼哈顿距离;当p=2时,公式变成√Σ|xi − yi|²,也就是欧几里得距离;当p取无穷大时,闵可夫斯基距离就变成了切比雪夫距离(后面我们会讲到)。比如还是用(1,2)和(4,6)这两个点,p=1时距离是7,p=2时距离是5,p=3时,计算就是(3³+4³)^(1/3)=(27+64)^(1/3)=91^(1/3)≈4.497。
适用场景:闵可夫斯基距离适合用于需要灵活控制距离计算方式的场景。比如在聚类分析中,如果我们不确定用欧几里得还是曼哈顿距离更合适,就可以通过调整p的值,找到最适合当前数据的距离计算方式;在一些需要自定义距离权重的场景中,也可以通过调整p,突出不同维度的差异影响。
六、雅卡尔距离,衡量两个集合的“重叠度”
雅卡尔距离主要用于衡量两个集合之间的差异,它的核心是看两个集合的重叠程度——重叠的元素越多,距离越近,相似度越高。和余弦距离类似,它也是用1减去雅卡尔相似度得到的。
公式:1 − |A ∩ B| / |A ∪ B|(其中|A ∩ B|是两个集合的交集元素个数,|A ∪ B|是并集元素个数)
示例:假设集合A={1,2,3},集合B={2,3,4},先算交集,两个集合都有的元素是2和3,交集个数是2;再算并集,把两个集合的元素合并,去掉重复的,得到{1,2,3,4},并集个数是4;代入公式就是1 - 2/4 = 0.5,所以雅卡尔距离是0.5。如果两个集合完全相同,比如A={a,b,c},B={a,b,c},交集和并集个数都是3,距离就是0;如果两个集合没有交集,距离就是1。
适用场景:雅卡尔距离适合用于集合数据的比较,比如推荐系统中,比较两个用户的兴趣标签集合,判断用户兴趣的相似度;社交网络中,比较两个用户的好友列表,衡量社交关系的重叠度;还有文本分析中,比较两篇文章的关键词集合,判断主题相似度。
七、切比雪夫距离,只看“最大差异”