


从推理模型到智能体的数学原理
从推理模型到智能体:AI“会想、会做”背后的数学 摘要:推理模型并没有突然长出一套与语言模型无关的逻辑引擎,智能体也不是给聊天机器人装上几个工具那么简单。它们可以沿着一条数学主线理解:模型先学习在不确定性中预测与选择,再通过更长的计算、更细的反馈和与环境交互,改善“下一步做什么”的决策。概率描述不确定性,优化调整模型,强化学习塑造策略,控制与决策理论则帮助我们分析系统如何行动、何时失控。 想象你交给 AI 一个任务:“查找三家供应商的报价,比较交付时间,整理成一页报告。” 普通聊天模型可能直接给出一段看似完整的答案。推理模型可能先拆分问题、逐项计算,再检查结论。智能体则可能真的打开网页、读取表格、调用计算工具,发现资料缺失后再搜索,最后生成报告。 三者看起来像能力等级的递进,底层却不是简单的“加一个思考按钮,再加几个工具”。要理解它们,得从一个更基础的问题开始:一个模型究竟在计算什么?
一、语言模型的起点:对下一个符号下注
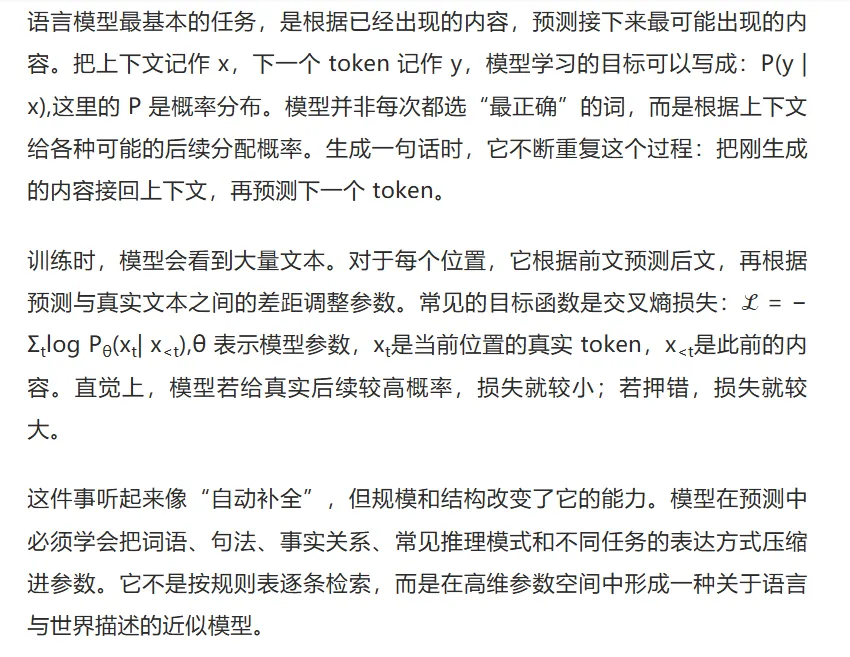
要强调“近似”:训练目标要求模型学会拟合文本分布,并不直接保证它掌握事实真伪,也不保证它的每一步推导都可靠。它可以生成一段非常像正确解释的文字,却仍然犯下算术、事实或逻辑错误。语言流畅,是预测能力的表现;事实可靠,则需要额外的训练、工具和检验机制。 二、Transformer:让上下文彼此传递线索
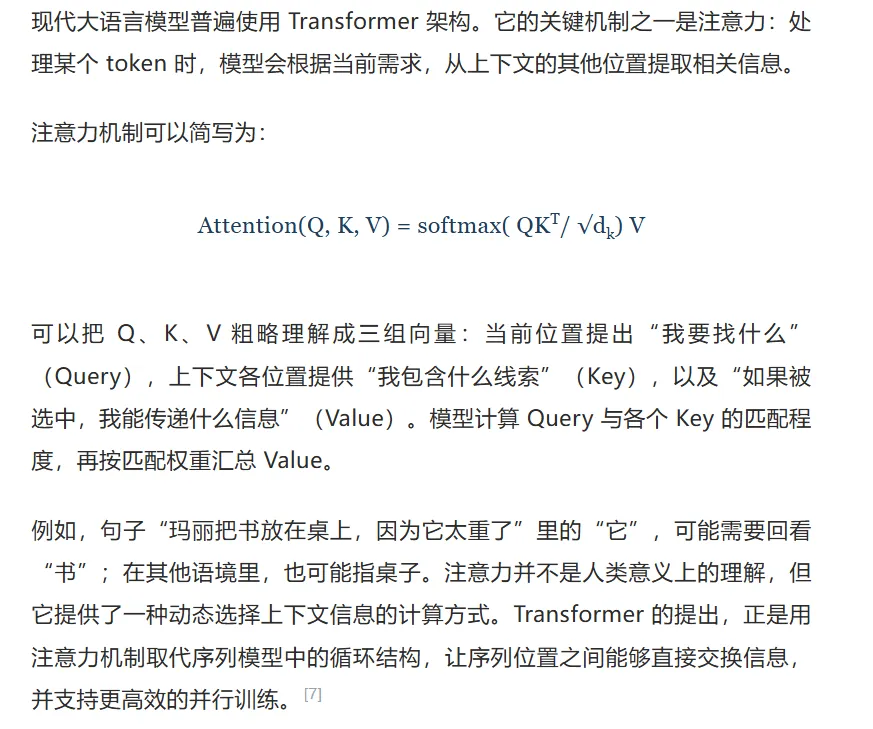
但注意力本身不等于推理。它更像一种信息路由机制:哪些上下文内容应该参与当前计算?复杂推导、数学计算、长任务规划,仍取决于模型学到了什么、生成过程有多少计算资源,以及系统如何验证中间结果。 这一点很重要。人们常把“模型能关注上下文”理解成“模型因此知道如何推理”。事实上,注意力解决的是信息交互问题;推理能力还涉及表征、训练信号、计算过程和错误校验。 三、为什么“多想几步”有时会更好
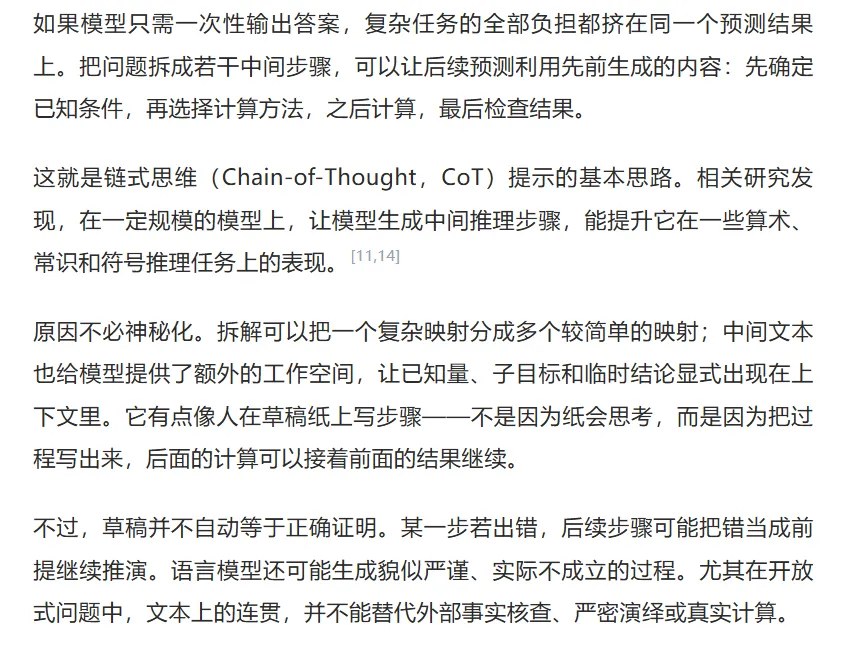
四、推理模型:一种更长、更受训练约束的求解过程
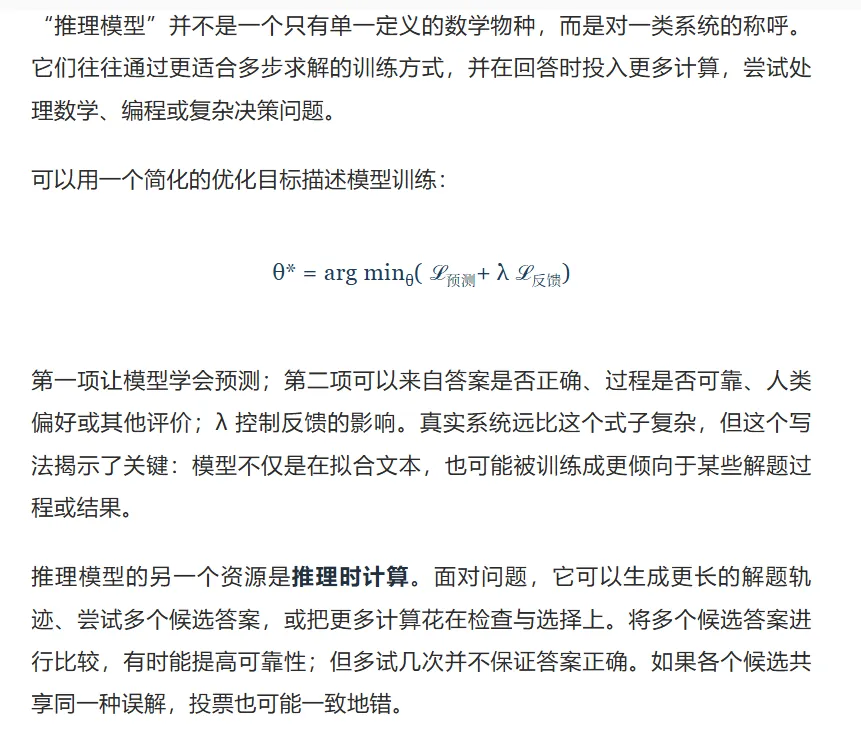
这与强化学习中的“策略”概念相连。强化学习把行动者表示为策略 π(a | s):在状态 s 下,选择行动 a 的概率分布。训练时,系统依据奖励信号调整策略,使高奖励的行动更容易出现。放到推理任务里,状态可以是题目和当前解题上下文,行动可以是继续推导、调用计算器、检查结果,或者提交答案。 这并不意味着每个推理模型都使用同一种强化学习算法,也不意味着“思考越长越好”。更准确的说法是:推理质量取决于模型能否找到有用的中间步骤、训练反馈是否正确、额外计算是否花在关键处,以及任务有没有可靠的验证标准。 五、从答案生成到动作选择:智能体的数学视角
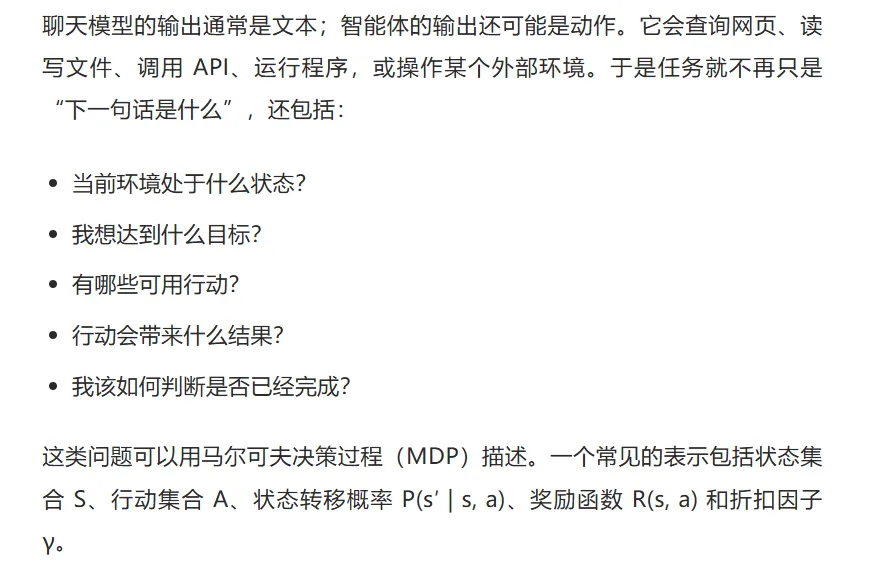
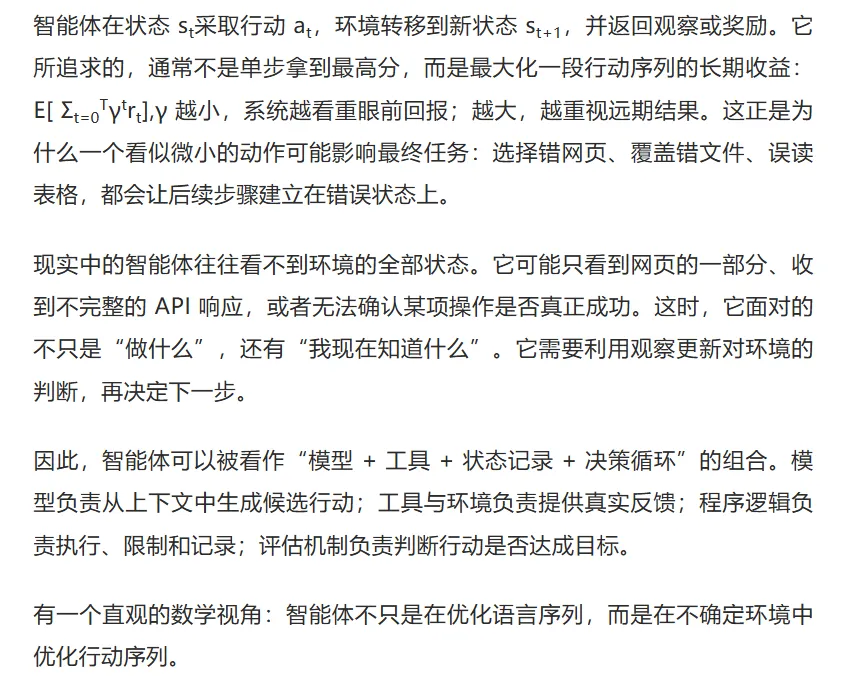
六、为什么“推理 + 行动”比单独推理更有用
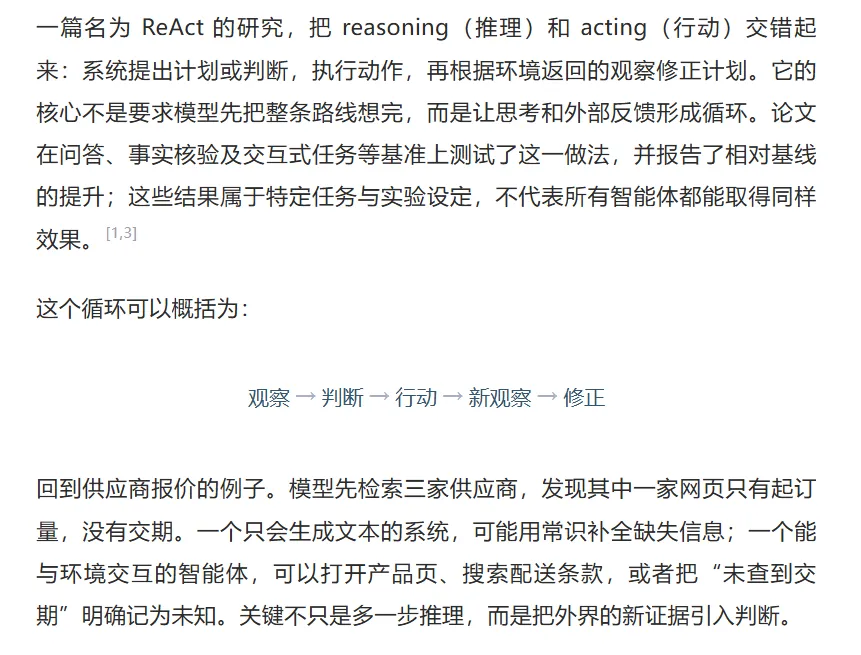
这里有一条值得记住的分界线:模型生成的“我已经查过”不是查证;工具返回的数据、执行结果或可重复验证的观察,才构成外部反馈。行动型系统的可靠性,不应只看它解释得是否顺畅,还要检查它实际调用了什么、得到什么、是否把结果读对。 七、智能体的瓶颈:长链路会放大错误
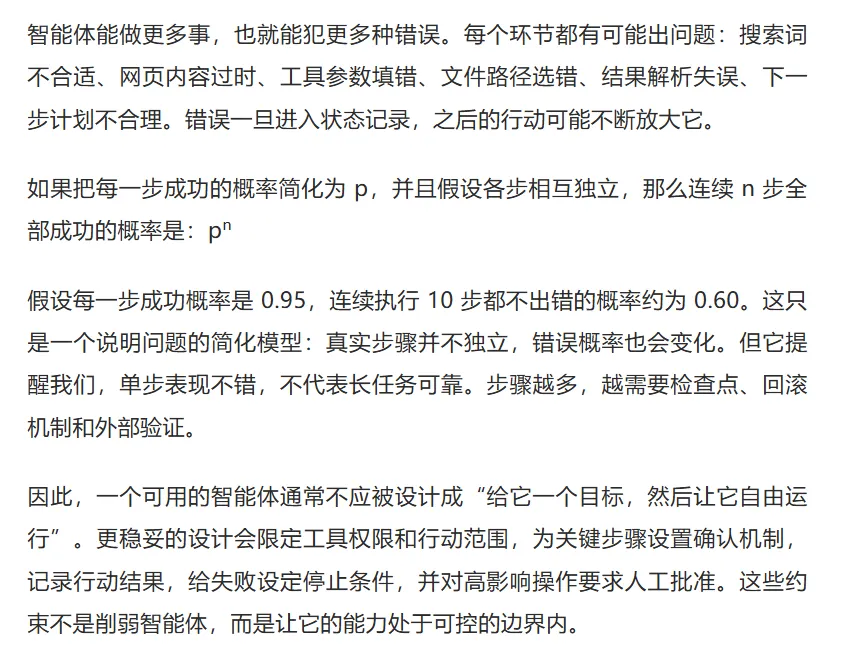
在实践中,还要区分“生成了计划”和“完成了任务”。计划可能合理,却没有执行;工具可能执行成功,却没有解决目标;任务可能看似完成,却遗漏关键条件。因而,智能体的评估应尽量依据可观察结果:数据是否正确、文件是否按要求生成、网页操作是否完成、失败时是否及时停止,而不只是看它的文字总结。 八、三层能力,三种不同的数学问题
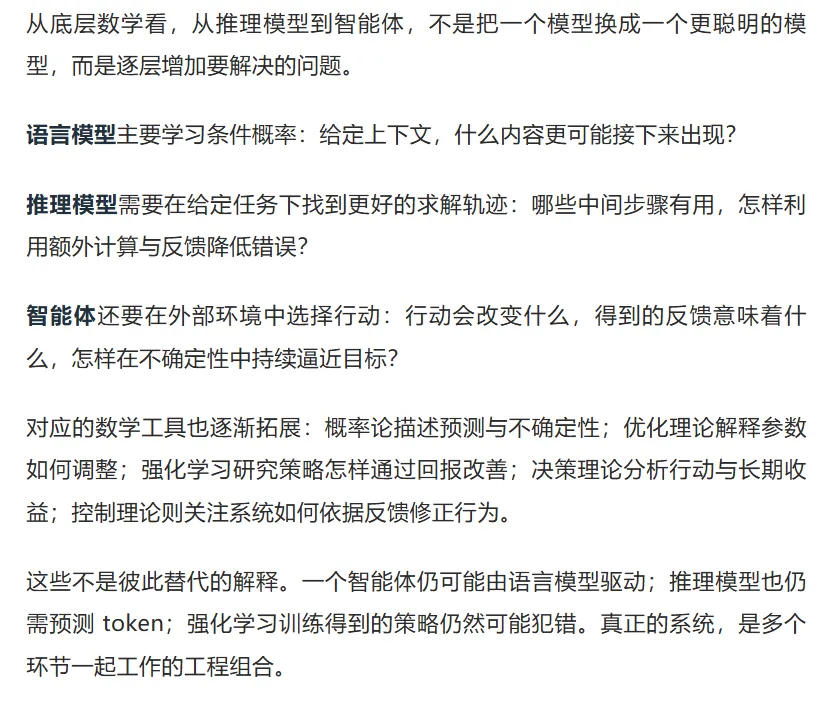
九、从公式回到应用:判断一个系统该靠什么
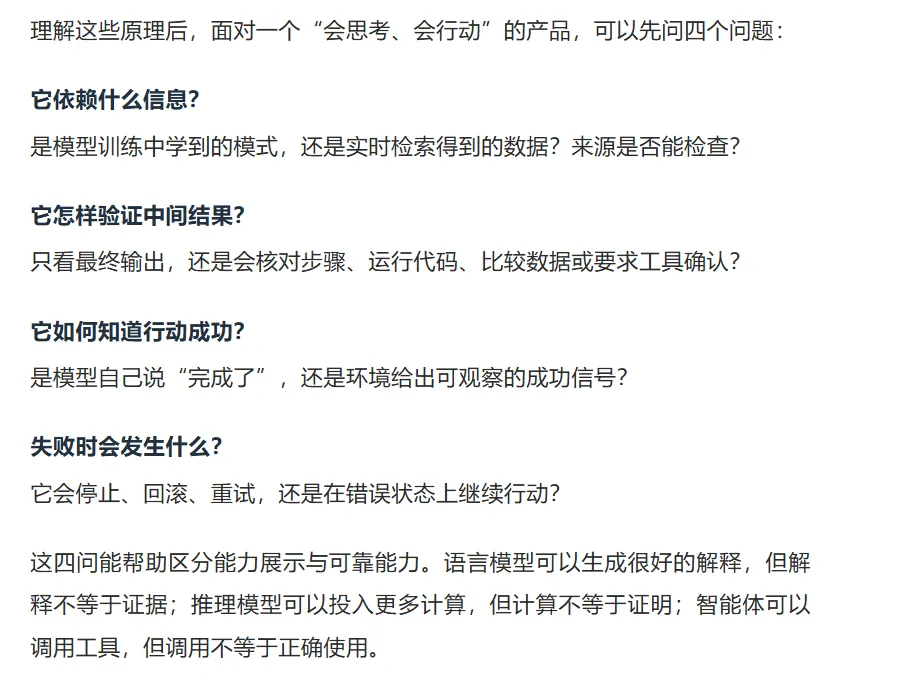
理解这种差别,也有助于更合理地使用它们:规则明确、结果可机器检验的任务,适合结合计算器、代码执行或数据库查询;事实会变化的任务,适合检索并核查来源;涉及真实世界高影响操作的任务,则应缩小权限、设置确认点,并保留人工监督。 结语:智能不是一枚按钮,而是一条反馈链 从推理模型到智能体,最重要的变化不是“AI 开始像人一样想”,而是计算过程变长、反馈变细、与环境的连接更直接。 概率让模型从上下文中选择下一步;优化让训练信号改变这种选择;推理时计算提供更多尝试和检查的机会;强化学习把行动与结果联系起来;工具和环境则把文本中的计划变成可观察的操作。 但每一层都有边界:概率匹配不等于事实;步骤文字不等于有效证明;奖励分数不等于真实价值;工具调用不等于任务完成。可靠性最终来自一条可检验的闭环:提出判断,采取行动,接收反馈,核对结果,必要时修正或停止。 AI 的“会想、会做”,不是某个神秘模块忽然觉醒,而是数学、训练和工程设计共同搭起的一座桥。桥能通向目标,但每一块桥板都需要被检查。